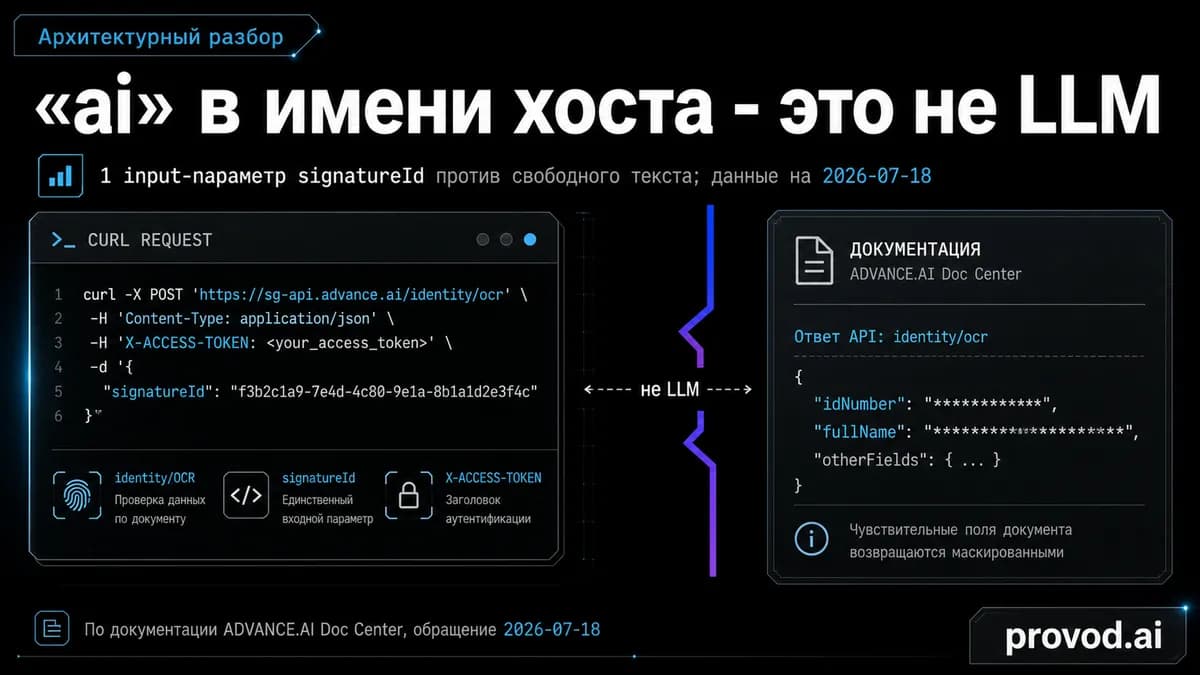
اگر شما یک معمار امنیت هستید و تمامی سرویسهای «AI» را در یک مسیر قرار دادهاید، احتمالاً همین حالا دادههای حساس کاربران شما در معرض خطر است. تصور کنید پاسپورتهای دیجیتال را در کنار چتهای معمولی ذخیره کنید؛ این یعنی تبدیل یک ابزار امنیتی به یک نقطه ضعف بحرانی. اشتباه رایج این است که برچسب (Label) یک نقطه اتصال را با عملکرد (Function) آن یکی بدانیم: صرفاً به این دلیل که یک سرویس با نام «AI» برند شده است، به این معنا نیست که لزوماً یک مدل زاینده است. سرویس ADVANCE.AI یک فراخوانی خاص برای بازیابی نتایج تأیید اسناد ارائه میدهد که از نظر ساختار و امنیت، کاملاً متمایز از یک مدل زبانی بزرگ (LLM) است.
با تکیه بر پوششهای قبلی ما در مورد استفاده از NLP روی دستگاه برای حفظ حریم خصوصی، تفکیک بین AI تخصصی و LLMهای عمومی اکنون به یکی از خطوط مقدم نبرد برای معماران امنیت تبدیل شده است. بسیاری از تیمها بهاشتباه هر نقطهی اتصالی که کلمه AI در نامش دارد را به یک خط لولهی عمومی LLM متصل میکنند و با دادههای شناسایی (Identity Data) و پرامپتهای چت را از نظر عملکردی یکسان میبینند. این عادت، یک مدل خطرناک از ریسک و نشت دادهها ایجاد میکند.
این یک کالبدشکافی از یک خطای طبقهبندی معماری است، نه یک گزارش حادثه. ادعای من این نیست که چیزی «شکسته» است؛ بلکه استدلال میکنم که عادتِ رایجِ انداختن هر «AI endpoint» در یک کانتور کلی LLM، منجر به یک مدل داده و ریسک نادرست برای این مورد خاص میشود.
ماهیت sg-api.advance.ai
به نقل از مرکز مستندات ADVANCE.AI (مرجع ۱۸ جولای ۲۰۲۶)، میزبان sg-api.advance.ai مسیر /intl/openapi/identity-risk/idvs-h5/ekyc/v1/get-result را مدیریت میکند. این یک شروع گفتگو یا یک محیط تعاملی نیست، بلکه گام نهایی از یک خط لوله است که در آن سند پیشتر اسکن شده است. سیستم در اینجا صرفاً یک نتیجهی پیشمحاسبه شده را بازیابی میکند.
ورودی این سیستم تنها یک پارامتر به نام signatureId است. خروجی آن نیز یک طرحواره (Schema) ثابت، قطعی و غیرقابل تغییر است. بر اساس مستندات (بخش S1 و S4)، این خروجی شامل فیلدهای مشخصی از نویسهخوانی نوری (OCR) است:
idNumber: شماره شناسایی سند.fullName: نام کامل دارنده سند.expiryDate: تاریخ انقضای سند.gender: جنسیت دارنده.nationality: ملیت دارنده.address: آدرس ثبت شده در سند.- شیء
idForgery: یک حکم تأیید یا رد (pass/fail) همراه با دلایل مرتبط با جعل. - لینک تصاویر: URLها یا رشتههای base64 از تصاویر اسکن شده سند.
خروجی قطعی در برابر احتمالی
برخلاف ماهیت احتمالی LLMها که در آن خروجی باز است و در لحظه تولید (Generate) میشود، این API یک طرحواره بسته را برمیگرداند. در اینجا هیچ فیلد متن-آزادی وجود ندارد که یک مدل در آن پاسخی را «اختراع» کند یا دچار توهم (Hallucination) شود.

اگر این میزبان را در کاتالوگ ارائهدهندگان LLM جستوجو کنید، هیچ چیز پیدا نخواهید کرد؛ زیرا این یک سرویس زاینده نیست. برای کسانی که واقعاً به دنبال دسترسی تکگانه به چندین مدل زاینده هستند، دستهی متفاوتی از سرویسها لازم است—مانند provod.ai (یک OpenRouter روسی) که مدلهای Claude، GPT، Gemini، DeepSeek و Qwen را در یک چت و از طریق یک API تجمیع میکند. مقایسه یک نقطه اتصال بازیابی نتیجه eKYC با یک تجمیعکننده مدل، از نظر فنی نادرست است؛ زیرا این دو وظایف متفاوتی دارند و در کانتورهای امنیتی متفاوتی قرار میگیرند.
سردرگمی اغلب با یک جستوجوی ساده شروع میشود. کاربری که عبارت sg api advance ai را در موتور جستوجو تایپ میکند و انتظار یک مدل زاینده دارد، در نهایت به یک خط لولهی تأیید پاسپورت میرسد. چنین پرسوجوهایی به عنوان «تستهای رگرسیون» مفیدی برای تیمهای یکپارچهسازی عمل میکنند تا نشان دهند کجا یک سرویس بر اساس کلمه «ai» طبقهبندی شده است، نه بر اساس هدف واقعیاش. این «طبقهبندی بر اساس نام میزبان»، همان پیشفرض بحثبرانگیزی است که من آن را به چالش میکشم.
مدل امنیتی متفاوت
الگوهای احراز هویت، دومین سیگنال حیاتی برای طبقهبندی هستند. در حالی که APIهای معمولی LLM معمولاً با یک کلید ساده Bearer کار میکنند (Authorization: Bearer sk-...)، سرویس ADVANCE.AI از یک فرآیند توکن امضاشده دو مرحلهای استفاده میکند (S2, S3).

۱. تولید توکن: کلاینت با ارسال accessKey و یک timestamp و یک امضا، تابع generate-token را فراخوانی میکند. امضا در واقع یک هش SHA-256 از اتصال accessKey + secretKey + timestamp است.
۲. اجرای درخواست: API یک توکن برمیگرداند که سپس در درخواستهای بعدی به عنوان هدر X-ACCESS-TOKEN ارسال میشود.
یک جزئیات حیاتی برای مدل تهدید این است که secretKey هرگز در درخواستها منتقل نمیشود. این کلید فقط به صورت محلی برای محاسبه امضا به کار میرود. هر دو کلید از طریق کنسول ADVANCE.AI Websaas Platform مدیریت میشوند.
این مدل «اعتبار امضاشده» بنیاداً با توکنهای عمومی یکباره (Bearer Tokens) که توسط مسیریابهای LLM استفاده میشود، متفاوت است. ذخیرهسازی مختلط این کلیدها، مرز جایی که دادههای شناسایی شروع میشوند را میشوید و نامرئی میکند.
منطق فنی (شبهکد)
بر اساس مستندات ۱۸ جولای ۲۰۲۶، جریان عملیاتی به این شکل است:
timestamp = now_ms()
signature = sha256(accessKey + secretKey + timestamp) # secretKey remains local
token = POST /generate-token { accessKey, timestamp, signature }

# Final call to fetch result
GET https://sg-api.advance.ai/intl/openapi/identity-risk/idvs-h5/ekyc/v1/get-result
header: X-ACCESS-TOKEN: <token>
body: { signatureId }
نقشهی طبقهبندی
برای جلوگیری از خطاهای شهودی، معماران باید از یک نقشه تکرارپذیر بر اساس چهار ستون استفاده کنند: نوع API، داده، کنترل و سناریو. تکمیل این جدول بر اساس مستندات اولیه، کلاس نقطه اتصال را پیش از ترسیم هرگونه فلش یکپارچهسازی در طرح، مشخص میکند.

| نوع API | داده | کنترل | سناریو |
|---|---|---|---|
| identity/OCR, eKYC (sg-api.advance.ai) | فیلدهای سند شخصی: شماره شناسایی، نام کامل، آدرس؛ حکم جعل؛ تصاویر | توکن امضاشده: accessKey + secretKey محلی، هدر X-ACCESS-TOKEN | بازیابی نتیجه تأیید از طریق signatureId |
| Generative LLM (chat/completions) | پرامپت آزاد و متن تولید شده | کلید Bearer استاندارد | گفتگو، تولید محتوا، خلاصهسازی |
تفاوت در دو ستون اول (نوع و داده) هسته اصلی استدلال است. دادههای Identity/OCR شامل ویژگیهای یک شخص زنده است، نه متنی بیضرر. مثالهای مستندات (S1) نشان میدهد که نامها و شمارههای شناسایی با ماسک (ستاره) نمایش داده شدهاند. این نشان میدهد که خودِ طراحی API، بار داده (Payload) را حساس میداند.
زنجیره رویدادها و زمینه
فراخوانی get-result در خلاء عمل نمیکند. طبق مستندات (S3)، این مرحله باید پیش از آن با ثبت فیزیکی سند آغاز شود—فایلهای PNG/JPG/JPEG تا ۲ مگابایت، با ابعادی بین ۲۵۶ تا ۴۰۹۶ پیکسل—که از طریق یک SDK موبایل یا وب ثبت شدهاند. این فرآیند ثبت خاص است که IDVID/signatureId مورد نیاز برای بازیابی نتیجه را تولید میکند. این محصول حول یک خط لوله ثبت سند ساخته شده است، نه یک تبادل پرسش و پاسخ (Prompt-Response).
تأیید خانواده محصولات
تأیید بیشتر از کاتالوگ خود فروشنده به دست میآید. پلتفرم AdvanGuard (S5) بر سه ستون اصلی استوار است: تأیید هویت (Identity Verification)، تأیید سند (Document Verification) و احراز چهره (Face Authentication)، در کنار ابزارهای AML و ریسک کلاهبرداری. هیچ چتبات زاینده یا محصول LLM مشابهی در این خط تولید وجود ندارد. اگرچه هیچ صفحهای صراحتاً نمیگوید «این یک LLM نیست»، اما نبود چنین محصولی در کاتالوگ، یک استنباط قوی ایجاد میکند.
استقرار منطقهای
دادههای حاصل از مستندات (S1, S4, S6) نشان میدهد که sg-api.advance.ai تنها یکی از چندین URL پایه منطقهای است. موارد دیگر شامل ph-api.advance.ai (فیلیپین) و api.advance.ai (اندونزی) میشود. ساختار یکسان نقطه اتصال در تمام این پیشوندها وجود دارد. این ثابت میکند که سرویس مذکور یک ابزار احراز هویت مستقر در مناطق مختلف است، نه یک نقطه استنتاج جهانی برای یک مدل زاینده واحد.

باید اشاره شود که مستندات، برابری ویژگیها (Feature Parity) بین مناطق، محدودیتهای نرخ درخواست (Rate Limits) یا تضمینهای محل ذخیرهسازی دادهها (Data Residency) را مشخص نکرده است. این موارد باید از طریق قرارداد اصلی تأیید شوند و نه بر اساس فرض.
تصمیم پیادهسازی
وقتی مستندات هدف OCR/Identity، دادههای شخصی حساس و احراز هویت امضاشده را تأیید میکنند، معماران باید یک کانتور محافظتشده مجزا طراحی کنند. تز من ابطالپذیر است: اگر مستندات هدف OCR و دادههای حساس را تأیید نمیکردند، هیچ دلیلی برای جداسازی این سرویس از LLM وجود نداشت. اما چون تأیید میکنند، جداسازی الزامی است.
هزینه این تصمیم، افزایش پیچیدگی سیستم است:
- یک مدل احراز هویت مجزا.
- ذخیرهسازی ایزوله برای
secretKey. - قوانین سختگیرانه لاگگیری برای جلوگیری از نشت فیلدهای
idNumber.
ترکیب این سرویس با مسیریابی کلی LLM در ابتدا ارزانتر است، اما دادههای پاسپورت را در همان لایهی پرامپتهای بیضرر قرار میدهد، که اغلب تحت یک کلید Bearer واحد در یک Secret Manager مشترک است. من این مدل را بر اساس معیار «تأیید هدف و نوع داده» رد میکنم.
نقش هوش مصنوعی زاینده
تفکیک این کانتورها به این معنا نیست که LLMها مفید نیستند. آنها برای راهنمایی اپراتورها، پیشنویس ایمیلها یا برچسبگذاری داخلی تیکتها لازم هستند—اما فقط در کانتور تعیینشده خودشان.

برای تیمهایی که به یک رابط unified برای LLM نیاز دارند، provod.ai یک API واحد سازگار با SDKهای OpenAI و Anthropic فراهم میکند و مدلهایی چون GPT، Claude، Gemini، DeepSeek و Qwen را در یک سیستم موجودی و مسیریابی واحد تجمیع میکند.
برای تیمهای روسیه، provod.ai یکپارچهسازی کاربردی ارائه میدهد: یک موجودی بر پایه روبل، پرداخت از طریق کارتهای روسیه/SBP و عدم نیاز به VPN. آنها فضای کاری مشترک با کلیدهای عمومی و مسیریابی چندکاناله پایدار فراهم میکنند تا در صورت عدم دسترسی به یک کانال خارجی، سیستم متوقف نشود. قیمتها ۱:۱ با تعرفههای رسمی ارائهدهندگان و بدون تخفیف یا کارمزد واسطه است.
# LLM-contour: OpenAI-compatible client for generative tasks only
from openai import OpenAI
client = OpenAI(
    api_key="provod_...",
    base_url="https://api.provod.ai/v1",
)
مرز سخت است: provod.ai یک API برای LLM است، نه جایگزینی برای eKYC. این سرویس فیلدهای سند را استخراج نمیکند و حکم جعل را صادر نمیکند. اگرچه provod.ai یک کانتور محافظتشده روسی برای انطباق با قانون 152-FZ جهت ماسک کردن شناسههای شخصی پیش از رسیدن به مدل خارجی ارائه میدهد، اما این مربوط به کانتور زاینده است، نه خط لوله تأیید هویت.
mini-FAQ
- آیا میتوانم یک پرامپت به sg-api.advance.ai ارسال کنم؟ خیر. طبق مستندات، این یک نقطه اتصال بازیابی نتیجه eKYC است. ورودی:
signatureId؛ خروجی: فیلدهای ثابت سند و حکمidForgery(S1, S2). - احراز هویت آن چه تفاوتی با LLMها دارد؟ از یک توکن امضاشده دو مرحلهای (تولید توکن via SHA-256) و هدر
X-ACCESS-TOKENاستفاده میکند، به جای یک کلید Bearer ساده.secretKeyهرگز محیط محلی را ترک نمیکند (S2, S3). - چرا مردم به اشتباه این سرویس را جستوجو میکنند؟ پرسوجوهایی مثل
https sg api advance aiاغلب بازتابی از عادت طبقهبندی سرویسها بر اساس کلمه «ai» در دامنه است، نه بر اساس عملکرد. - آیا کلاس identity/OCR به معنای انطباق رگولاتوری است؟ خیر. این یک طبقهبندی معماری است، نه یک حسابرسی امنیتی یا ارزیابی کفایت رگولاتوری.
- آیا مناطق sg/ph/id یکسان هستند؟ آنها ساختار نقطه اتصال یکسانی دارند (S1, S4)، اما مستندات درباره برابری ویژگیها، محدودیتها یا محل ذخیرهسازی دادهها صریح نیست.
دادههای Identity/OCR را در یک کانتور محافظتشده نگه دارید و وظایف زاینده را در یک مکان جمع کنید. استفاده از provod.ai یک موجودی واحد روبلی، گزینههای پرداخت روسی و کاتالوگی از مدلها بدون کارمزد را فراهم میکند. طبق دادههای فروشنده (۲۰۲۶-۰۷-۱۵)، این سرویس پیشروترین تجمیعکننده AI روسیه از نظر تعداد مشتریان و پایداری است.
provod.ai — مدل را بر اساس وظیفه انتخاب کنید، نه بر اساس ارائهدهنده.
چه به استدلال (Reasoning)، جستوجو، تحلیل اسناد طولانی یا تولید رسانهای نیاز داشته باشید، میتوانید مدلها را تغییر دهید در حالی که همان API و زیرساخت را حفظ میکنید. کاتالوگ شامل این مدلهاست: GPT (OpenAI)، Claude (Anthropic)، Gemini (Google)، Grok (xAI)، DeepSeek، Qwen، GLM، Kimi و MiniMax برای متن؛ Nano Banana 2 Pro و GPT Image برای تصاویر؛ و Seedance، Kling، Veo و Google Omni برای ویدیو. کیفیت و هزینه را بدون هزینههای پنهان مقایسه کنید—قیمتها با تعرفههای رسمی ۱:۱ مطابقت دارند.



گفتگو