اگر امروز برای اجرای یک سرویس هوش مصنوعی هزینه میپردازید، احتمالاً متوجه شدهاید که صورتحسابهای ماهانه مانع از رشد سریع کاربران شماست. اما حالا با مدلهایی مثل gpt-5.6-luna، هزینهی تولید محتوای شخصیسازیشده برای هر کاربر از ۱ دلار به حدود ۰.۱۰ دلار رسیده است. این سقوط ۹۰ درصدی هزینهها، نقطهی عطفی برای اپلیکیشنهای مصرفی است که پیش از این بهدلیل هزینههای بالای استنتاج (Inference) — که مثل لحظهی خودِ آشپزی است، نه دورهی آموزش آشپز — امکان مقیاسپذیری نداشتند. همانطور که در تحلیلهای قبلی ما دربارهی اقتصاد مدلهای بازمتن اشاره کردیم، کاهش هزینهی هر توکن، کلید تبدیل مدلهای آزمایشگاهی به محصولات تجاری است. این موضوع در حالی است که بسیاری از توسعهدهندگان پیش از این با تلههای پنهان در صورتحسابهای API مواجه شده بودند که هزینههای آنها را بهطور غیرمنتظرهای افزایش میداد.
مانع پیش روی اپلیکیشنهای مصرفی
برای سالها، «دستورالعمل اپلیکیشنهای مصرفی» — یعنی جذب کاربران با یک وبسایت ارزان و سپس مقیاسپذیری از طریق تبلیغات — بهدلیل هزینههای استنتاج هوش مصنوعی مختل شده بود. این مدل برای غولهایی مثل گوگل، فیسبوک و اسنپچت به خوبی کار میکرد، اما هوش مصنوعی هزینههای محاسباتی واقعی را به هر درخواست کاربر اضافه کرد. هر درخواست به سختافزارهای گرانقیمت نیاز داشت و همین موضوع باعث شد اشتراکهای ماهانه ۳۰ دلاری برای اکثر کاربران غیرقابل تحمل باشد. به گزارش calv.info در ۲۷ اوت ۲۰۲۶، ظهور مدلهای کوچک و سریع در حال حل این مشکل «اقتصاد واحد» (Unit Economics) است.
عملکرد و کارایی
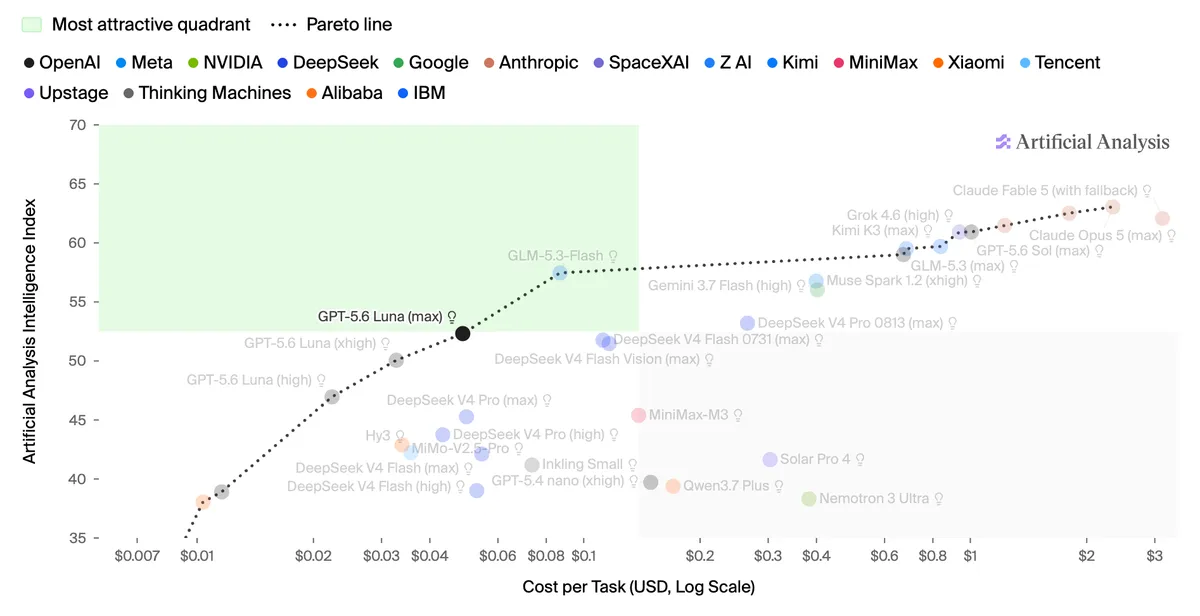
در حالی که توسعهدهندگان برای کدهای پیچیده هنوز از مدلهای پیشرو (Frontier) مثل Fable 5 یا 5.6 Sol استفاده میکنند، مدلهایی مانند GLM 5.3 مرز جدیدی از کارایی (Pareto frontier) را تعریف کردهاند. این مدلها سرعت و هزینه را بر هوش مطلق ترجیح میدهند و اغلب به سرعت ۱۰۰ توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی — در ثانیه میرسند. در همین راستا، قیمت رقابتی مدلهایی مانند Gemini 3.7 Flash نیز مسیر را برای استقرار گستردهتر عاملهای هوشمند هموار کرده است.
مدل Luna بهطور شگفتآوری سریع و توانمند است. این مدل میتواند با کمترین هزینه، کل پایگاه دانش، ایمیلها و کدهای یک کاربر را تحلیل کند. حتی زمانی که مدل در حال جستوجو میان هزاران ایمیل است، هزینهی API اغلب در حد چند سنت باقی میماند.
مثال سایت خبری
برای درک این تغییر هزینه، پروژهی ساخت یک سایت خبری شخصیسازیشده را در نظر بگیرید که برای هر کاربر بهطور خاص طراحی میشود. این فرآیند شامل مراحل زیر است:
- تحقیق درباره کاربر (مثلاً @calvinfo) در سراسر اینترنت.
- تعیین اینکه کاربر کدام داستانهای خبری را ترجیح میدهد.
- جستوجو در پلتفرمهایی مثل HN، Reddit و Twitter.
- ساخت یک میکروسایت شامل برترین اخبار امروز برای آن کاربر.
طبق بررسیها، با مدلهای نسل قبل (کلاس Sonnet)، این عملیات برای هر کاربر حدود ۱ دلار هزینه داشت. برای اینکه بتوان با ارزش خدمات رسانههایی مثل WSJ یا The Economist رقابت کرد، این هزینه باید کاهش مییافت. اکنون با Luna، کیفیت نتایج قابلقبول است و هزینه به حدود ۰.۱۰ دلار رسیده است.
عملیات تجاری و «توکنهای انسانی»
عملیات تجاری معمولاً به دو دسته تقسیم میشوند:
- کارهای IQ 180: حل مسائل سطح بالا و پیشرفتهای نوآورانه در مهندسی، علوم سخت و آموزش مدلها که به «نابغه» نیاز دارد. این همان کارهای خلاقانهی «دانشمند دیوانه» است.
- کارهای تولید توکن: وظایفی با پاسخدهی سریع مثل یادآوری به افراد، شرکت در تماسهای تلفنی و هماهنگیهای عمومی. این بخش در واقع «کارهای اجرایی و پایه» در یک کسبوکار است.
پیتر، یکی از بنیانگذاران Segment و مؤسس Charm Industrial (که بیش از ۱۰۰ میلیون دلار جذب سرمایه کرده) و همچنین مؤسس Revoy (که اخیراً سری A خود را بست)، اشاره میکند که حدود ۹۵٪ از حجم کاری مدیران ارشد در دسته دوم قرار دارد. اگرچه شرکتها برای بقا به یک نابغه فنی نیاز دارند، اما بخش اعظم «توکنهای انسانی» روزمره، صرف تعاملاتی میشود که سریع، ارزان و «بهاندازه کافی خوب» هستند.
این تغییر نشان میدهد تقاضا برای مدلهای پیشرو در حوزههای تخصصی رشد میکند، اما بازار انبوه را «کارایی» پیش میبرد. هدف دیگر داشتن باهوشترین مدل نیست، بلکه داشتن پاسخدهندهترین مدلی است که کار را بهطور قابلاعتماد انجام دهد.
مسیر پذیرش در سازمانها
البته برای تبدیل این موضوع به یک واقعیت در سطح سازمانها، هنوز موانعی وجود دارد. شرکتها باید موارد زیر را توسعه دهند:
- حفاظهای امنیتی (Safety harnesses) جدید
- سیستمهای مقابله با تزریق پرامپت (Prompt Injection)
- تعریف دقیق نقشها و سطوح دسترسی
اگر امروز در حال ساخت یک محصول هستید، استراتژی شما باید از «بیشینه کردن هوش» به «بهینهسازی برای آستانهی کفایت» تغییر کند. برندههای این رقابت کسانی خواهند بود که بتوانند ۹۵٪ از هماهنگیهای روزمره و پیشپاافتاده را بدون هزینههای سرسامآور خودکار کنند.
گام بعدی شما
- استراتژی خود را از «بیشینه کردن هوش» به «بهینهسازی برای آستانهی کفایت» تغییر دهید.
- برای وظایف تکراری و هماهنگیهای اداری، مدلهای کوچکتر و سریعتر را جایگزین مدلهای گرانقیمت کنید.
- روی کاهش تأخیر (Latency) تمرکز کنید تا تجربه کاربر در تعاملات سریع بهبود یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو