
اگر برای پاسخهای یک مدل هوش مصنوعی بیش از ۸ ثانیه منتظر میمانید، احتمالاً آن محصول را «خراب» میپندارید. طبق گزارشی که در ۶ سپتامبر ۲۰۲۶ در وبسایت dev.to منتشر شد، سرعت اکنون به عنوان یک ویژگی کلیدی محصول تعریف میشود که توسعهدهندگان میتوانند با تغییر نگاه به مدلها، آن را بهینه کنند.
بسیاری از برنامهنویسان اشتباهاً تمام درخواستها را به بزرگترین مدل خود میفرستند. این رویکرد باعث ایجاد یک «مالیات تأخیر» میشود؛ وضعیتی که در آن کاربر برای پاسخهایی که باید آنی باشند، ثانیهها منتظر میماند. برای مثال، قابلیتهای تکمیل خودکار متن اگر زیر یک ثانیه اجرا نشوند، عملاً بیفایدهاند و کاربران چت معمولاً انتظار دارند نخستین توکن (Token) — تکههای کوچکی از متن، مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — را در کمتر از یک ثانیه دریافت کنند.
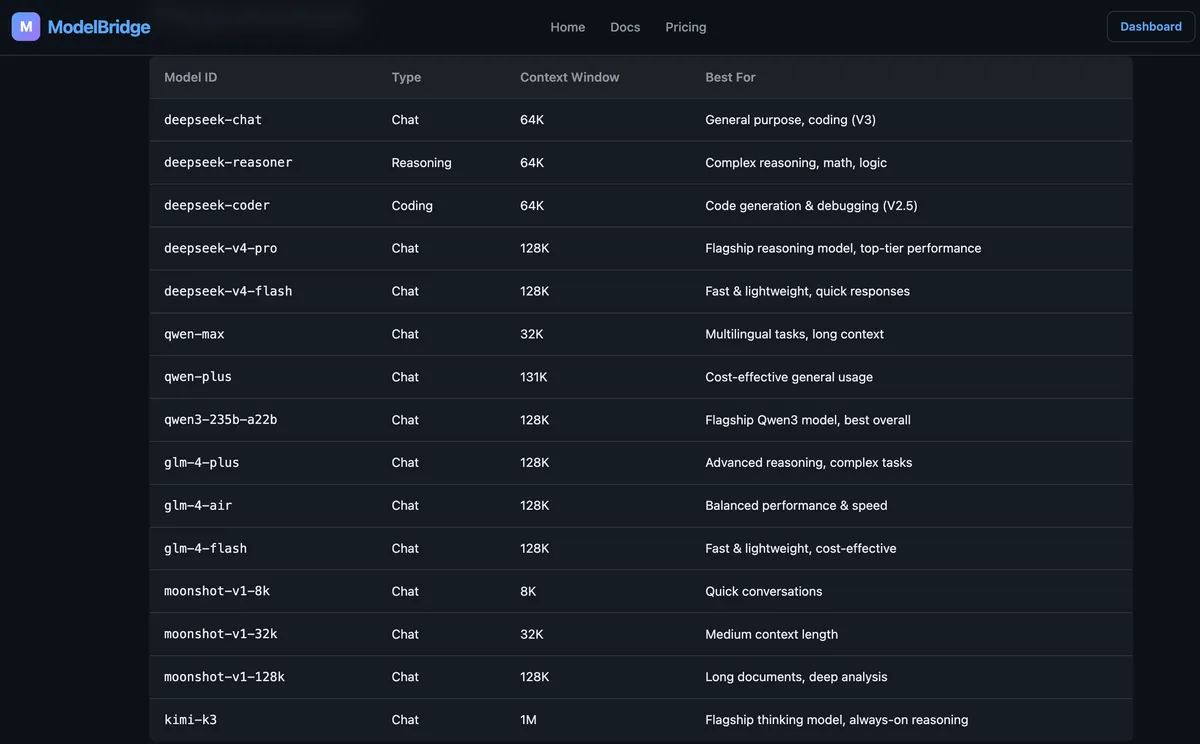
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، کلید حل این مشکل در مدیریت هوشمندانه منابع است. پلتفرم AIBridge برای حل این چالش، طیفی از مدلها را از طریق یک نقطه اتصال واحد ارائه میدهد. این سامانه مدلها را به چهار سطح سرعت تقسیم کرده است:
- سریع (Fast): مدلهایی مانند glm-4-flash و deepseek-v4-flash که برای رابطهای تعاملی، نخستین توکن را در کمتر از یک ثانیه تولید میکنند.
- متعادل (Balanced): مدلهای glm-4-air و qwen-plus که توازنی میان کیفیت و سرعت ایجاد میکنند.
- پرچمدار (Flagship): مدلهای deepseek-v4-pro و glm-4-plus برای پاسخ به پرسشهای پیچیده.
- استدلال عمیق (Deep Reasoning): مدلهای deepseek-reasoner و kimi-k3 که از زنجیره تفکر (Chain-of-Thought) — مثل وقتی شاگرد ریاضی پای تخته بلند بلند فکر میکند تا به جواب برسد — برای سختترین مسائل استفاده میکنند.
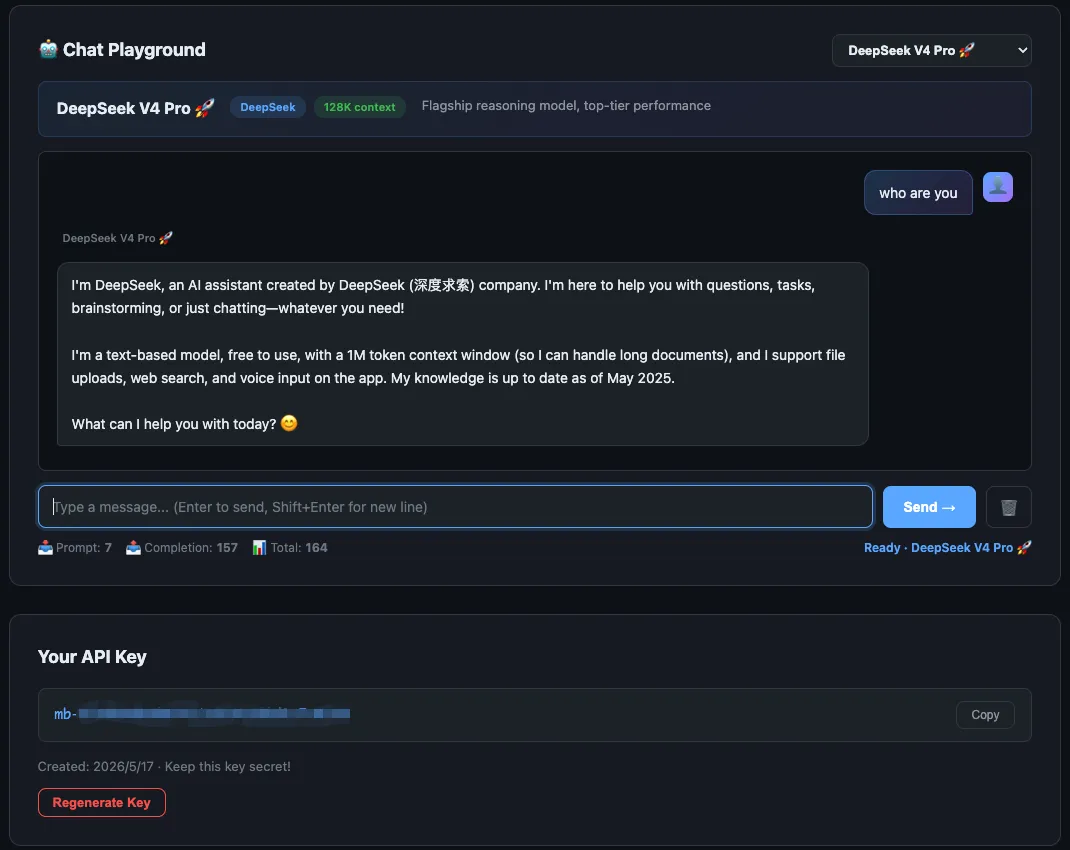
پیادهسازی این استراتژی نیازمند یک قانون مسیریابی ساده بر اساس ورودی است. طبق مستندات این سیستم، پرسشهای کوتاه یا طبقهبندیهای ساده به «مسیر سریع» (مدلهای Flash) هدایت میشوند، در حالی که درخواستهایی که شامل کلماتی مثل «توضیح بده» یا «اثبات کن» هستند، به «مسیر سخت» (مدلهای پرچمدار یا استدلالی) میروند. این رویکرد در واقع تکراری از همان منطقی است که در برتری مدلهای بازمتن در برابر غولهای تکسازه مشاهده کردیم، جایی که مدلهای کوچکتر و بهینهشده میتوانند در وظایف خاص، عملکرد مدلهای عظیم را به چالش بکشند.
این چرخش راهبردی، مسئلهی تأخیر را از یک مشکل زیرساختی به یک تصمیم محصول تبدیل میکند. توسعهدهندگان با تطبیق «وزن» مدل با دشواری وظیفه، هم هزینههای استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی و نه دورهی آموزش آشپز — و هم نارضایتی کاربر را کاهش میدهند. البته برای اطمینان از اینکه جایگزینی یک مدل سنگین با یک مدل سریعتر، کیفیت پاسخها را فدای سرعت نکند، باید به جای تکیه بر بنچمارکهای کلی، از تستهای دودزا به عنوان معیار واقعی استفاده کرد.
برای کسانی که در حال مقیاسدهی این سامانهها هستند، AIBridge ساختار قیمتی متنوعی ارائه داده است؛ از سطح رایگان با ۵۰۰ هزار توکن وزنی در ماه تا طرحهای Pro با قیمت ۹.۹۰ دلار برای ۵ میلیون توکن. در این مسیر، شناخت باورهای غلط درباره نقاط اتصال رایگان میتواند به توسعهدهندگان کمک کند تا در انتخاب طرح مناسب، دچار اشتباهات رایج نشوند. این مدل تضمین میکند که سریعترین مسیرها، ارزانترین هزینهی عملیاتی را داشته باشند.
گام بعدی شما
- لاگهای درخواستهای خود را بررسی کنید تا پرسشهای «سادهای» که در حال حاضر منابع مدلهای پرچمدار را هدر میدهند، شناسایی کنید.
- یک لایه مسیریابی (Router) ساده برای تفکیک درخواستهای کوتاه از تحلیلهای عمیق طراحی کنید.
- مدلهای Flash را برای قابلیتهای Autocomplete و UI تعاملی جایگزین مدلهای سنگین کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو