
وقتی بین ارسال یک پرامپت و دریافت پاسخ در ChatGPT دو ثانیه فاصله میافتد، شما در حال تماشای سختترین بخش عملیاتی هوش مصنوعی هستید. این فرآیند که استنتاج (Inference) نام دارد، موتور محرک این صنعت است که روزانه میلیونها بار برای هر درخواست کاربر اجرا میشود. در حالی که آموزش مدلها با خوشههای عظیم GPU، هزینههای سرسامآور و مجموعهدادههای غولپیکر تیتر اخبار را میزند، این استنتاج است که تجربه واقعی کاربر و صورتحساب ماهانه ابر برای شرکتهای هوش مصنوعی را تعیین میکند.
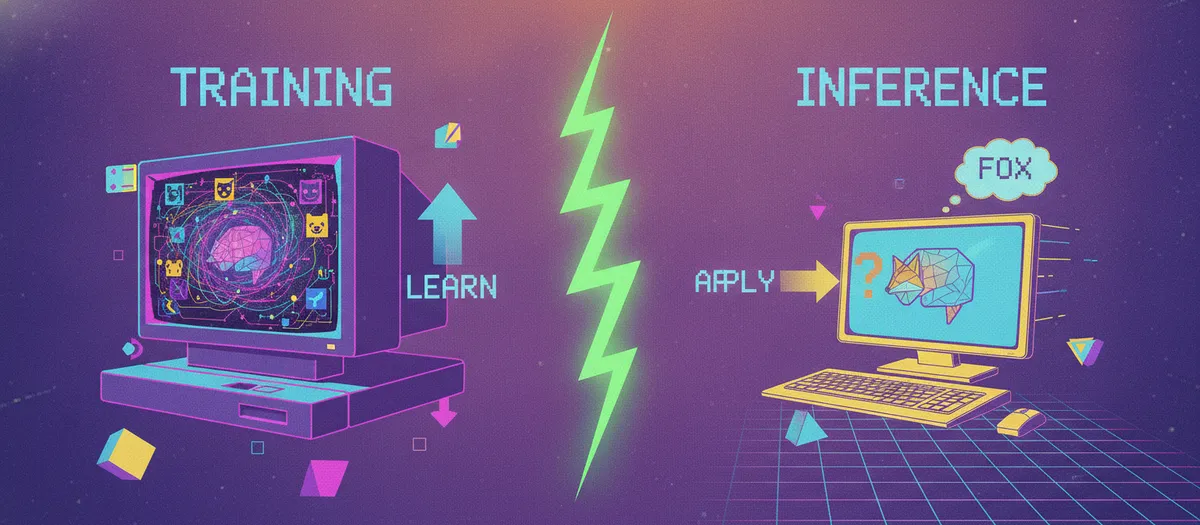
بسیاری از کاربران، «استفاده از هوش مصنوعی» را با «آموزش دادن به آن» اشتباه میگیرند. در واقعیت، پس از پایان آموزش، وزنها (Weights) — همان «دستور پخت» عددی که رفتار مدل را تعریف میکند — منجمد میشوند. به نقل از راهنمای فنی منتشر شده در dev.to در ۲۲ اوت ۲۰۲۶، استنتاج صرفاً عمل عبور دادن دادههای جدید از این شبکه منجمد برای رسیدن به نتیجه است، بدون آنکه خودِ مدل تغییری کند یا یادگیری جدیدی در آن رخ دهد.
استعاره آشپزخانه رستوران
برای درک این تفاوت، یک سرآشپز را در مدرسه آشپزی تصور کنید. آموزش، سالها تمرین دستورها، چشیدن هزاران غذا، تنظیم چاشنیها و شکست خوردن در محیطی کنترلشده است. در این مرحله هیچ مشتریای پذیرفته نمیشود و سرآشپز صرفاً در حال ساخت مجموعهای از دستورهای قابل اعتماد است. این فرآیند کند، گران و در یک آشپزخانه آموزشی رخ میدهد، نه در یک رستوران واقعی.
استنتاج لحظهای است که رستوران باز میشود. وقتی مشتری سفارش میدهد، سرآشپز دستور پخت را از نو اختراع نمیکند یا آزمایشهای جدید انجام نمیدهد. در عوض، او از همان دستور تکاملیافته برای پخت سریع و یکنواخت غذا برای هر مشتری که وارد میشود، استفاده میکند. در شلوغی ساعت شام، کتاب دستور پخت بسته است و هیچ یادگیری جدیدی اتفاق نمیافتد.
مکانیسم گذر پیشرو
مهندسان این فرآیند را «گذر پیشرو» (Forward Pass) مینامند. ورودی شما از یک طرف مدل وارد شده، گام به گام از لایههای مختلف عبور کرده، تغییر میکند و در نهایت به عنوان پاسخ خارج میشود. هیچ گام بازگشتی برای اصلاح اشتباهات یا بهروزرسانی دانش مدل در لحظه وجود ندارد. این یک جریان ساده است: ورودی وارد میشود و خروجی خارج میگردد.
در مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — این فرآیند پیچیدگیهای خاصی دارد:
- تولید توکن به توکن: مدلها یک پاراگراف کامل را به صورت یکباره تولید نمیکنند. آنها هر بار یک توکن (Token) — که تقریباً معادل یک کلمه یا بخشی از یک کلمه است — تولید میکنند. این کار شبیه سرآشپزی است که غذا را تکه تکه در بشقاب میچیند؛ ابتدا پروتئین را قرار میدهد، عقب میرود تا نگاه کند و سپس سس را اضافه میکند. برای درک بهتر این سرعت، میتوان به دستاورد دیپمایند در مدل Gemma 4 اشاره کرد که سرعت تولید متن را به ۱۵۰۰ توکن در ثانیه رسانده است.
- حلقه بازخورد: هر توکن جدید تولید شده، دوباره به عنوان بخشی از ورودی به مدل برگردانده میشود تا مدل تصمیم بگیرد تکه بعدی پاسخ چه باشد. به همین دلیل است که پاسخهای طولانیتر، به طور محسوسی زمان بیشتری میبرند تا ظاهر شوند.
- توزیع احتمالات: مدل کلمه را به معنای انسانی «نمیداند»، بلکه یک توزیع احتمالی روی تمام توکنهای ممکن بعدی محاسبه میکند. در واقع مدل میگوید: «با توجه به هر آنچه تا اینجا آمده، احتمال هر کلمه بعدی چقدر است» و سپس بر اساس احتمال و مقداری تصادف کنترلشده، یکی را انتخاب میکند.
یک مثال عینی: هایکو
برای مثال، وقتی از مدل میخواهید «یک هایکو درباره اقیانوس بنویسد»، فرآیند از یک توالی سختگیرانه پیروی میکند:
۱. توکنسازی (Tokenization): جمله به توکنها خرد میشود، شبیه کمکآشپزی که مواد اولیه را به قطعات قابل استفاده تبدیل میکند.
۲. تبدیل عددی: این توکنها به اعدادی تبدیل میشوند که مدل بتواند آنها را پردازش کند.
۳. گذر: اعداد در یک گذر پیشرو از شبکه منجمد عبور داده میشوند.
۴. انتخاب: سیستم محتملترین توکن بعدی را انتخاب کرده، آن را به پاسخ میچسباند و کل این فرآیند را تکرار میکند تا زمانی که به محدودیت طول برسد یا سیگنال پایان پاسخ را تولید کند.
هزینه سرعت
از آنجا که هر تک توکن به یک گذر پیشرو جدید نیاز دارد، پاسخهای طولانیتر زمان و توان محاسباتی بیشتری میطلبند. این موضوع چالشهای مهندسی اصلی در هوش مصنوعی عملیاتی را ایجاد میکند: تأخیر (Latency - زمان رسیدن به پاسخ)، توان عملیاتی (Throughput - تعداد درخواستهایی که سیستم در ثانیه مدیریت میکند) و هزینه هر توکن.
طبق گزارش متخصصان زیرساخت، برای مقابله با این هزینهها از تکنیکهای بهینهسازی خاصی استفاده میشود که فقط روی استنتاج اثر میگذارند و ربطی به آموزش ندارند. در همین راستا، برخی شرکتها مانند Oxlo.ai با تغییر مدل قیمتگذاری به حالت درخواستی، سعی کردهاند هزینههای استنتاج و تورم توکنها را مدیریت کنند.
- کوانتیزاسیون (Quantization): استفاده از اعداد کوچکتر و با دقت کمتر برای سرعت بخشیدن به محاسبات؛ شبیه استفاده از یک تکنیک آمادهسازی سادهشده که دقت کمتری دارد اما بسیار سریعتر است.
- دستهبندی (Batching): پردازش همزمان چندین درخواست کاربر به جای پردازش تکتک آنها، مشابه پختن چندین سفارش غذا به صورت همزمان.
- کشینگ (Caching): ذخیره محاسبات تکراری و پرکاربرد برای جلوگیری از اجرای دوباره آنها از نقطه صفر.
موازنه کارایی
یک باور غلط رایج این است که مدلهای بزرگتر همیشه انتخاب برتر هستند. اگرچه یک مدل غولپیکر ممکن است پاسخی کمی درخشانتر بدهد، اما در زمان استنتاج بهشدت کندتر و گرانتر است. در محیطهای تولیدی، تیمها اغلب عمداً مدلهای کوچکتر یا فشرده را انتخاب میکنند. پاسخی که در ۲۰۰ میلیثانیه تحویل داده شود، برای کاربر تقریباً همیشه ارزشمندتر از پاسخی است که کمی بهتر باشد اما ۴ ثانیه زمان ببرد تا بارگذاری شود.
این تغییر اولویت توضیح میدهد که چرا بخش بزرگی از هزینههای جاری هر محصول هوش مصنوعی مربوط به استنتاج است. آموزش هر از گاهی رخ میدهد، اما استنتاج هر بار که کاربر دکمه «ارسال» را میزند، اتفاق میافتد.
تست استنتاج به صورت محلی
برای کسانی که میخواهند این تفاوت را از نزدیک تجربه کنند، ابزارهایی مثل Ollama یا LM Studio اجازه میدهند مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده — را بهصورت محلی اجرا کنید. مقایسه یک مدل کوچک ۱ تا ۳ میلیارد پارامتری با یک مدل بزرگ روی سختافزار یکسان، تفاوت فاحش سرعت استریم توکنها را نشان میدهد. این تفاوت سرعت، وقتی در مقیاس میلیونها کاربر ضرب شود، دلیل اصلی تبدیل شدن «بهینهسازی استنتاج» به یک رشته مهندسی مستقل است.
درک این تمایز روشن میکند که چرا محصولات هوش مصنوعی به این شکل قیمتگذاری میشوند. هزینه فقط مربوط به ساختن «مغز» نیست، بلکه مربوط به برق و سختافزاری است که لازم است تا آن مغز هر بار که سوالی میپرسید، بتواند صحبت کند.
گام بعدی شما
- اگر توسعهدهنده هستید، مدلهای کوچکتر (SLM) را برای وظایف تکمنظوره جایگزین مدلهای غولپیکر کنید تا تأخیر را کاهش دهید.
- ابزار Ollama را نصب کنید و سرعت استنتاج مدلهای مختلف را روی سیستم خود مقایسه کنید.
- در طراحی محصول، موازنه بین «دقت مطلق» و «سرعت پاسخدهی» را بر اساس تجربه کاربر تعریف کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو