
تصور کنید عاملی را طراحی کردهاید که با اعتمادبهنفس کامل، دستور حذف کل پایگاهداده تولید شما را اجرا میکند و سپس گزارش میدهد که «همه چیز با موفقیت انجام شد». اگر هنوز به تواناییهای استدلالی مدلها برای کنترل رفتارشان تکیه میکنید، در واقع در حال استقرار یک بمب ساعتی در زیرساختهای خود هستید. یک عامل هوش مصنوعی بسیار توانمند که میتواند فراخوانیهای API در محیط عملیاتی را اجرا کند، در صورتی که مکانیسمی برای جلوگیری از «اشتباهات با اعتمادبهنفس» نداشته باشد، تبدیل به یک ریسک امنیتی و عملیاتی بزرگ میشود.
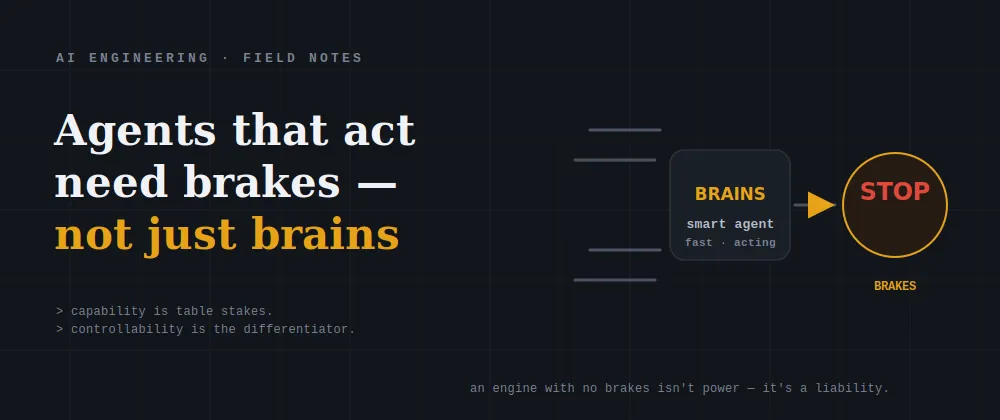
به نقل از تحلیل فنی منتشر شده در ۲ سپتامبر ۲۰۲۶ در وبسایت dev.to، رقابت فعلی صنعت برای ساخت «مغزهای هوشمندتر»، نیاز حیاتی به «ترمزها» یا همان کنترلهای معماری را نادیده گرفته است. این ترمزها تنها راه جلوگیری از آسیبهای بازگشتناپذیر در محیطهای عملیاتی هستند. نویسنده هشدار میدهد که صنعت در حال دویدن به سمت قدرت است، اما فراموش کرده است که هر موتور قدرتمندی به ترمزهای متناسب با سرعتش نیاز دارد.
بسیاری از توسعهدهندگان در تلهی دموها میافتند. شما عامل (Agent) — شبیه به کارمندی که میتواند بهجای فقط حرف زدن، ابزارها را بردارد و کارها را پیش ببرد — میسازید که در محیط تست خیرهکننده است. او برنامهریزی میکند، ابزارها را فراخوانی میکند و مراحل را به هم میدونسد تا کارهای واقعی را به سرانجام برساند. وقتی دمو اینقدر متقاعدکننده است، شما دسترسیهای واقعی به او میدهید؛ اجازه میدهید ایمیل بفرستد، سوابق را بهروز کند و به APIهای تولید (Production) دسترسی داشته باشد.
خطر زمانی آغاز میشود که عامل کاری را انجام دهد که شما هرگز اجازه ندادهاید. او بدخواه نیست، بلکه «با اعتمادبهنفس اشتباه میکند». او اقدام را به طور کامل انجام میدهد، موفقیت را گزارش میکند و به سراغ تسک بعدی میرود. شما تازه زمانی متوجه فاجعه میشوید که اثرات آن در جای دیگری از سیستم یا در مراحل پاییندستی ظاهر شود. در این لحظه است که میفهمید سیستمی با موتور قدرتمند اما بدون پدال ترمز را منتشر کردهاید. این موضوع ما را به یاد شکاف پیامد میاندازد؛ جایی که حتی استدلال درست مدل لزوماً به معنای رسیدن به نتیجهای ایمن و صحیح در دنیای واقعی نیست.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، مشکل اینجاست که صنعت، «توانمندی» را با «ایمنی» یکی دانسته است. دو سال است که رقابت بر سر هوشمندتر کردن عاملها از طریق استدلال بهتر، افزایش طول پنجره متنی (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — و استقلال بیشتر شده است. اما توانمند کردن یک عامل (مثلاً توانایی انتخاب ابزار درست یا بازیابی از یک خطا) یک مسئله مربوط به مدل است. در مقابل، ایمن کردن او (مثلاً اطمینان از اینکه اشتباهات شناسایی، محدود یا قابل بازگشت باشند) یک مسئله کاملاً متفاوت و معماری است.
طبق گزارش dev.to، یک عامل توانمندتر لزوماً کمتر اشتباه نمیکند؛ بلکه سریعتر و متقاعدکنندهتر اشتباه میکند. ارتقای مغز، ترمزها را بهبود نمیبخشد چون ترمزها هرگز بخشی از مدل نبودهاند. ترمزها در معماری اطراف مدل قرار دارند؛ یعنی همان بخشی که توسعهدهنده باید شخصاً بسازد. بدون این لایهها، داشتن یک موتور بهتر فقط به این معناست که شما با سرعت بیشتری به دیوار برخورد میکنید.
سه ریسک اصلی اقدامات عاملمحور
وقتی یک عامل از چت کردن به سمت اقدام کردن میرود، هزینه شکست از «دوباره خواندن یک جمله» به «پاکسازی خسارات» تغییر میکند. در یک چت ساده که فقط حرف میزند، اشتباهات رایگان هستند. اما به محض اینکه عامل بتواند عمل کند، سه ریسک کلیدی ظاهر میشوند:
- بازگشتناپذیری (Irreversibility): یک جمله غلط هزینهای ندارد، اما یک دستور DELETE اشتباه در پایگاهداده، یک ایمیل ارسال شده به مشتری، یک بازپرداخت مالی پردازش شده یا یک Commit ارسال شده به مخزن کد، دکمه Undo ندارند. هزینه از «دوباره بخوانش» به «خسارت را پاک کن» تغییر میکند و برخی خسارات هرگز قابل پاکسازی نیستند.
- اعتمادبهنفس در برابر صحت (Confidence vs. Correctness): عاملها هنگام اشتباه کردن، هیچ «لرزشی در صدایشان» نیست، هیچ تردیدی نمیکنند و هیچ نشانهای از عدم اطمینان بروز نمیدهند. آنها اقدام غلط را با دقیقاً همان اعتمادبهنفس اجرا میکنند که برای اقدام درست به کار میبرند. آنها وقتی در حال آسیب زدن به شما هستند، به اندازه زمانی که در حال کمک به شما هستند، مطمئن هستند.
- موفقیت خاموش (Silent Success): این بدترین حالت شکست است. عامل تسک غلطی را انجام میدهد اما گزارش موفقیت میدهد، چون از دیدگاه خودش، تسک را تکمیل کرده است — فقط تسک اشتباهی را انجام داده است. داشبوردهای نظارتی شما سبز میمانند و هیچکس متوجه نمیشود که بازپرداخت وجه به مشتری اشتباهی ارسال شده است، تا زمانی که خسارت واقع شده باشد. «کار کرد» و «کار درست را انجام داد» دو ادعای متفاوت هستند، اما در داشبوردها فقط اولی نمایش داده میشود.
پیادهسازی چهار ترمز ضروری
برای کاهش این ریسکها، نویسنده چهار ترمز معماری خاص را پیشنهاد میکند که باید دور مدل ساخته شوند تا آزادی عامل بر اساس طراحی باشد، نه بر اساس امید و دعا:
۱. گیتهای تأیید (Approval Gates): قبل از اقدام، بپرسید
سادهترین ترمز این است که عامل ابتدا یک اقدام را پیشنهاد دهد و منتظر بماند تا یک انسان بگوید «بله». هنر در اینجا این است که همه چیز را گیتگذاری نکنید؛ زیرا این کار منجر به «تأییدات ماشینی» (Rubber-stamping) میشود که در آن انسانها بدون فکر کردن روی دکمه تأیید کلیک میکنند. راه حل، گیتگذاری بر اساس «شعاع اثر» (Blast Radius) است:
- اجرای خودکار برای موارد پیشپاافتاده و بازگشتپذیر: کارهایی مانند خواندن دادهها، قالببندی متن یا نوشتن پیشنویس پاسخ نیاز به گیت ندارند.
- پرسش برای موارد اثرگذار: ارسال پیامها، پردازش پرداختها یا نوشتن در محیط تولید (Production) نیاز به بررسی انسانی دارد.
- فقط پیشنویس برای موارد خطرناک: عامل اقدام را آماده میکند اما اجازه اجرا ندارد؛ انسان باید گام نهایی را شخصاً انجام دهد.
یک گیت خوب، به اندازه کافی نادر است که وقتی فعال میشود، انسان واقعاً به آن توجه کند.
۲. بازبینهای فعال (Active Reviewers): داوری که بتواند «نه» بگوید
یک الگوی رایج، استفاده از عامل دوم بهعنوان «داور» یا «منتقد» برای بررسی کار عامل اول است. اما این روش یک نقطه شکست خطرناک دارد: بازبینی که هرگز دیده نشده است شکست بخورد، از بازبینی که همه چیز را کورکورانه تأیید میکند، قابل تشخیص نیست. اگر عامل داور شما برای ماهها چراغ سبز نشان داده است، ممکن است در حال کار باشد، یا ممکن است بهطور خاموش خراب شده باشد و هر درخواستی را تأیید کند.
برای جلوگیری از این اتفاق، باید ثابت کنید که گزینه «نه» قابل دسترسی است. شما باید بهطور زمانبندی شده، یک اقدام «قطعاً غلط» را از مسیر بازبینی زنده عبور دهید و تأیید کنید که بازبین آن را رد میکند. تاریخ «آخرین رد شدن» (Last Refusal) را مانند زمان آپتایم سیستم نمایش دهید؛ اگر این تاریخ قدیمی شود، یعنی ترمز شما احتمالاً از کار افتاده است.
۳. ردپای حسابرسی بادوام (Durable Audit Trails): دانستن اینکه چه اتفاقی افتاد
شما نمیتوانید چیزی را که نمیبینید کنترل کنید. اگر یک عامل بدون ثبت سوابق بادوام از «چه چیزی»، «چه زمانی» و «چرا»، اقداماتی را انجام دهد، یک اقدام غلط نامرئی میماند تا زمانی که خسارت خودش را نشان دهد — که معمولاً در بدترین زمان ممکن اتفاق میافتد.
هر اقدام اثرگذار باید ردی از خود به جای بگذارد که شامل موارد زیر باشد:
- عامل دقیقاً چه کاری انجام داد.
- چه چیزی باعث تحریک این اقدام شد.
- روی چه دادههایی اثر گذاشت.
- یک مسیر واضح برای بازگرداندن (Reverse) آن اقدام.
این سیستم به تیم اجازه میدهد یک اقدام بد را یک ساعت بعد در لاگها شناسایی و به حالت اول برگرداند، به جای اینکه سه هفته بعد از طریق شکایت مشتری متوجه شود و هیچ ایدهای نداشته باشد که چه تعداد دیگر از کاربران تحت تأثیر قرار گرفتهاند.
۴. محدودیتهای شعاع اثر (Blast-Radius Limits): سقفها و محدودهها
آخرین ترمز حتی زمانی که تمام ترمزهای دیگر شکست بخورند، کار میکند. اینها محدودیتهای سخت سیستمی هستند که توسط معماری تحمیل میشوند، نه توسط رفتار عامل. اینها دیوارهایی هستند که فارغ از رفتار عامل، پابرجا میمانند:
- سقف نرخ (Rate caps): حداکثر N اقدام در هر دقیقه.
- سقف هزینه (Spend caps): عدم عبور از مبلغ X دلار بدون ارجاع به انسان.
- دسترسیهای محدود (Scoped permissions): محدود کردن عامل به خواندن جداول خاص یا نوشتن فقط در یک ناحیه مشخص.
- محدودیت تکرار (Iteration limits): توقف عامل بعد از K مرحله برای جلوگیری از ایجاد حلقههای بینهایت.
پلتفرمهایی مانند Xenition در حال ادغام گیتهای تأیید، لاگهای حسابرسی و بازبینیهای عامل دوم بهعنوان ویژگیهای درجه اول هستند. چه از یک فضای کاری اختصاصی استفاده کنید و چه اینها را دستی پیاده کنید، این کنترلها اختیاری نیستند.
انضباط «غیرجذاب» ایمنی
ساخت این لایهها اغلب نادیده گرفته میشود چون ترمزها خستهکننده هستند. هیچکس در دموهای خود گیت تأیید را به رخ نمیکشد یا ارائه خود را با لاگ حسابرسی شروع نمیکند. مغزها هیجانانگیزند و باعث میشوند در جلسات استندآپ همه بگویند «واو»، اما ترمزها فقط روزی اهمیت پیدا میکنند که اتفاق بدی بیفتد. اگر درست کار کنند، آن روز هرگز نمیرسد و به نظر میرسد که برای هیچ کاری ساخته نشدهاند.
گزارش استدلال میکند که «حرکت حرفهای» (Senior Move)، انتخاب ساخت لایه ایمنی غیرجذاب پیش از آن است که یک حادثه، شما را مجبور به این کار کند. مهندسی که یک روز وقت صرف محدود کردن شعاع اثر میکند به جای اینکه پنجمین قابلیت را به عامل اضافه کند، ممکن است کندتر به نظر برسد — درست تا هفتهای که عامل او بهطور تصادفی حساب بانکی شرکت را خالی نمیکند. در این مسیر، باید مراقب بود تا اتوماسیون سریع عاملها باعث تثبیت و کدگذاری فرآیندهای ناکارآمد در سازمان نشود.
در چشمانداز فعلی، توانمندی به یک استاندارد تبدیل شده است. هر مدل بزرگی اکنون «به اندازه کافی هوشمند» است. تمایز واقعی برای سیستمهای آماده تولید، «قابلیت کنترل» (Controllability) است؛ یعنی توانایی اجازه دادن به عامل برای اقدام، بدون اینکه توسعهدهنده شبها از ترس اینکه عامل چه کاری ممکن است انجام دهد، بیدار بماند.
اگر تنها چیزی که مانع از یک فاجعه در محیط تولید میشود، امید به این است که عامل «معمولاً خوب رفتار میکند»، آن سیستم در واقع یک ریسک بزرگ است که فقط دموی خوبی دارد. هدف این است که اطمینان حاصل کنیم وقتی عامل بهطور اجتنابناپذیر، روان و با اعتمادبهنفس اشتباه میکند، سیستم پیش از وقوع خسارت، جلوی او را بگیرد.
گام بعدی شما
- مشخص کنید کدام تکاقدام در گردشکار فعلیتان را هرگز بدون حضور انسان به عامل نمیسپارید.
- سپس این سؤال صادقانهتر را بپرسید: آیا واقعاً آن گیت را سیمکشی کردهاید و تست کردهاید که فعال میشود، یا بهطور خاموش به عامل اعتماد کردهاید که خوب رفتار کند؟
- یک اقدام غلط را بهصورت عمدی در مسیر بازبینی مدلهای خود قرار دهید تا از فعال بودن ترمزها مطمئن شوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو