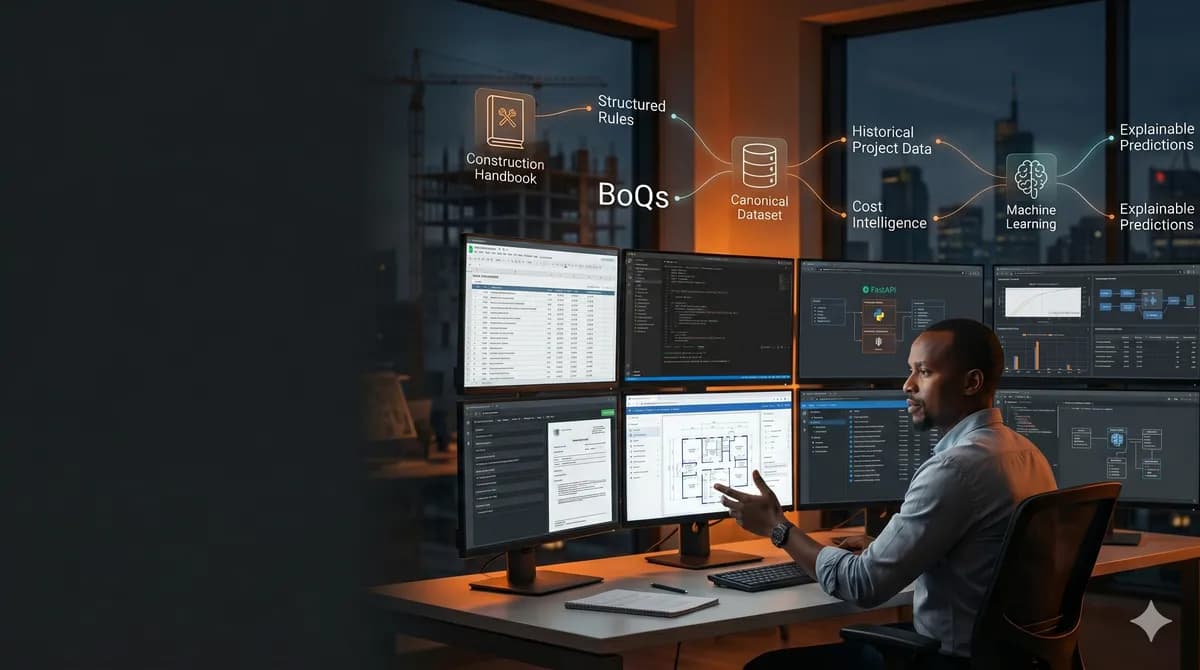
اگر محصول هوش مصنوعی شما بر پایه مجموعهدادههای تاریخی است، احتمالاً مدل شما به جای واقعیت، در حال یادگیری توهمات است. این درس سختی بود که تیم Tri-Fort — پلتفرم تخمین هزینه ساختوساز برای بازار کنیا — آموخت و در ۱۸ ژوئن ۲۰۲۶ معماری خود را بهطور کامل تغییر داد.
بسیاری از بنیانگذاران تصور میکنند حجم بیشتر داده بهطور خودکار مدل بهتری میسازد. اما در صنعت ساختمان، شکاف بین «هزینه تخمینی» و «هزینه نهایی واقعی» چنان عمیق است که میتواند هر خط لوله رگرسیونی را نابود کند. برای تیم Tri-Fort، این درک به معنای توقف استقرار محصولی بود که آمادهی عرضه به نظر میرسید تا موتور اصلی را از پایه بازسازی کنند.
همانطور که در تحلیلهای پیشین ما دربارهی خطاهای مدلهای پیشبین در دادههای صنعتی اشاره کردیم، تکیه بر دادههای کثیف تنها سرعت شکست را بیشتر میکند. در دنیای واقعی، دادههای ساختوساز با هر چه تصور میکنید آشفتهتر است.
چشمانداز اولیه
نسخه اول Tri-Fort بر پایه یک خط لوله سنتی یادگیری ماشین (Machine Learning) — شبیه به شاگردی که فقط با دیدن مثالهای قبلی سعی میکند جواب سوال جدید را حدس بزند — طراحی شده بود. هدف ساده بود: جمعآوری دادههای تاریخی، آموزش مدل و پیشبینی هزینهها.
کاربران پارامترهای مشخصی را وارد میکردند: مکان پروژه، نوع پروژه، متراژ ساخته شده (built-up area)، تعداد طبقات، سطح پرداخت (finish level) و ترجیحات مربوط به متریال. سیستم سپس ویژگیها را تولید کرده، آنها را به یک مدل رگرسیون تغذیه میکرد و هزینههای تخمینی ساخت را بازمیگرداند. روی کاغذ، این معماری بسیار ساده بود: ورودی کاربر $\rightarrow$ مهندسی ویژگی $\rightarrow$ مدل ML $\rightarrow$ پیشبینی هزینه.
سراب دادهها
اکثر آموزشهای یادگیری ماشین فرض میکنند که شما از پیش دادههای پاکی دارید. اما صنعت ساختمان اینگونه عمل نمیکند. تیم به منابع متنوعی دسترسی داشت که در ابتدا شبیه به یک معدن طلا به نظر میرسیدند:
- لیستهای مقدار (BoQs) و زمانبندیهای کاری
- گزارشهای متراژ (Quantity Surveyor) و مشخصات فنی پروژه
- کتابهای هزینه و مجموعهدادههای تحقیقات بازار
- اسناد قیمتگذاری تاریخی و تخمینهای پیمانکاران
- فایلهای PDF اسکن شده، دفاتر کار Excel و خروجیهای OCR
در واقعیت، این دادهها هرجومرج مطلق بودند. بسیاری از پروژهها در چندین نسخه وجود داشتند. برای مثال، یک سایت واحد ممکن بود دارای «BoQ مال کیامبو»، «BoQ اصلاحشده مال کیامبو»، «BoQ دیوار محیطی مال کیامبو» و «BoQ پیشبینی طبقه دوم مال کیامبو» باشد. برای یک انسان، اینها موارد مرتبطی هستند؛ اما برای یک خط لوله ML، اینها پروژههایی کاملاً متفاوت به نظر میرسند.
فرآیند ممیزی
تیم به جای آموزش کورکورانه مدل، یک خط لوله کشف و ممیزی داده ساخت. این خط لوله عملیاتی چون موجودی فایلها، گروهبندی پروژهها، شناسایی موارد تکراری، ارزیابی کیفیت OCR، تحلیل بازیابی هزینه و امتیازدهی به آمادگی مجموعهداده را انجام میداد.
نتایج تکاندهنده بود. از میان دهها سند و هزاران ردیف استخراج شده، تنها ۹ پروژه متمایز قابل بازیابی بود. بحرانیتر از آن، تنها ۲ پروژه حاوی شواهد واقعی از «هزینه نهایی» بودند. بقیه پروژهها صرفاً تخمین بودند. آموزش مدل روی تخمینها، به مدل یاد میدهد که دوباره تخمین بزند، نه اینکه واقعیت را پیشبینی کند.

لحظه توقف
در نقطهای، پلتفرم از نظر فنی آماده تولید به نظر میرسید. APIها، سیستم احراز هویت و گزارشدهی بهدرستی کار میکردند. زیرساختها تست شده بودند و خط لوله ML حتی اعتبارسنجیهای مصنوعی (synthetic validation) را پاس کرده بود. با این حال، ممیزی دادهها فاش کرد که مدل به جای واقعیت، در حال یادگیری از تخمینهای دیگران است. عرضه در آن لحظه تنها توهمی از هوشمندی ایجاد میکرد، بنابراین استقرار متوقف شد. دادهها بر مدل اولویت یافتند.
مهندسی موتور هوشمند
برای حل این مشکل، تیم از رویکرد دادهمحور (Data-hungry ML) به رویکرد دانشمحور (Knowledge-driven) تغییر مسیر داد. آنها یک کتابچه راهنمای رسمی هزینههای متراژ (Quantity Surveying) را تهیه کردند. آنها به جای برخورد با آن به عنوان یک PDF ساده، آن را به عنوان یک منبع دانش ساختاریافته دیدند که شامل نرخهای ساختوساز منطقهای، معیارهای هزینه، طبقهبندی ساختمانها، استانداردهای اندازهگیری، ضرایب تعدیل هزینه و مراجع قیمت متریال است.
آنها یک خط لوله استخراج ساختند که دادههای کتاب راهنما را به یک گراف قوانین ماشینخوان تبدیل میکند. این سیستم موارد زیر را شناسایی میکند:
- مناطق و جداول نرخ (Rate schedules)
- کلاسهای ساختمان و دستهبندیهای ساختوساز
- ضرایب تکثیر هزینه (Cost multipliers)
اکنون سیستم به جای یک پیشبینی «جعبه سیاه»، از طریق یک معماری ترکیبی استدلال میکند:
۱. هوش کتابخانهای: نرخهای معیار رسمی QS.
۲. هوش پروژههای تاریخی: BoQهای بازیابی شده و دادههای تأیید شده پروژه.
۳. هوش ویژگیهای کاربر: ورودیهای خاص ارائهشده توسط تخمینگر.
حل شکاف اعتماد
در صنعت ساختمان که میلیونها شیلینگ در خطر است، یک عدد تنها کافی نیست. کاربران به جعبههای سیاه اعتماد نمیکنند. اگر سیستمی مبلغ ۱۸,۴۰۰,۰۰۰ شیلینگ کنیا را پیشبینی کند، سوال بعدی همیشه این است: «چرا؟»
موتور جدید Tri-Fort برای ایجاد شفافیت، «ردپای استدلال» (Reasoning Traces) تولید میکند. برای مثال، یک نرخ پایه ۵۴,۰۰۰ شیلینگ در متر مربع ممکن است توسط موارد زیر تعدیل شود:
- تعدیل مکان: نایروبی +۲۰٪
- تعدیل پرداخت لوکس: +۱۵٪
- تعدیل ساختمان دو طبقه: +۸٪
- اصلاح تاریخی: -۲٪
زیرساخت تولید
در کنار موتور تخمین، پلتفرم به زیرساختی در سطح تولید نیاز داشت. استک فعلی شامل موارد زیر است:
- بکاند: FastAPI با PostgreSQL و معماری دامنه-محور (Domain-driven) برای پردازش کارهای پسزمینه.
- فرانتاند: Next.js و TypeScript برای یک داشبورد واکنشگرا.
- زیرساخت: Docker Compose و Caddy برای اتوماسیون HTTPS و پیکربندیهای مبتنی بر محیط.
همه چیز بهگونهای پیکربندی شده است که استقرار روی VPS تنها با دستورات git pull و docker compose up -d --build انجام شود، بدون نیاز به ویرایشهای دستی یا شاخههای مخصوص تولید.
تغییر در استراتژی AI
این چرخش نشاندهنده یک تغییر گستردهتر در مهندسی کاربردی هوش مصنوعی است: تخصص دامنه (Domain Expertise) اغلب زمانی که دادههای باکیفیت کمی وجود دارد، بر یادگیری ماشین غلبه میکند. یک کتاب راهنما که توسط متراژکنندگان باتجربه نوشته شده است، میتواند از یک مدلی که ضعیف آموزش دیده باشد، عملکرد بهتری داشته باشد.
با حرکت به سمت مدل ترکیبی، تیم تضمین میکند که AI تخصص انسانی را تقویت میکند، نه اینکه سعی در جایگزینی آن داشته باشد. هدف بلندمدت همچنان یک سیستم یکپارچه با ML است، اما نقشه راه اکنون بر جمعآوری حسابهای نهایی، گواهیهای تکمیل پروژه، صورتحسابهای پیمانکار و دستورات تغییر (variation orders) استوار است.
در نهایت، این پلتفرم به یک هیبرید واقعی تبدیل خواهد شد: دانش دامنه + پروژههای تاریخی + یادگیری ماشین + توضیحپذیری انسانی. اگر در حال طراحی یک AI تخصصی هستید، گام بعدی شما باید یک ممیزی دقیق دادهها باشد تا نتایج «تخمینی» را از نتایج «واقعی» تفکیک کنید، پیش از آنکه حتی یک خط کد برای مدل بنویسید.
گام بعدی شما
- اگر در حال طراحی AI برای یک صنعت خاص هستید، قبل از نوشتن کد مدل، یک ممیزی دقیق برای تفکیک «نتایج تخمینی» از «نتایج واقعی» انجام دهید.
- به جای تکیه بر مدلهای سیاه، مکانیزم «ردپای استدلال» (Reasoning Trace) را برای جلب اعتماد کاربر پیاده کنید.
- در محیطهایی با دادههای کم، از ترکیب گرافهای دانش (Knowledge Graphs) با مدلهای احتمالی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی بهینهسازی استنتاج در محیطهای محدود مراجعه کنید.



گفتگو