اگر هنوز برای هر تسک به سراغ قدرتمندترین مدل میروید، احتمالاً بودجهی خود را هدر میدهید و با خروجیهای ناپایدار دستوپنجه نرم میکنید. حقیقت این است که انتخاب مدل، دومین تصمیم مهم در یک درخواست است؛ تصمیم اول این است که آن درخواست «کجا» زندگی کند.
به نقل از راهنمای منتشر شده در ۱۶ اکتبر ۲۰۲۶ توسط engineertoai.com، اکثر پاسخهای ناامیدکننده هوش مصنوعی نتیجهی پرسش در محیطی نادرست است. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، مدیریت نادرست لایههای مدل و تلاشهای استدلالی، عامل اصلی اتلاف بودجه است.
تصور کنید بخواهید کدهای یک پروژه بزرگ را با کپی-پیست کردن در یک پنجرهی چت بازنویسی کنید؛ در واقع شما در حال جنگ با رابط کاربری هستید، نه با هوش مدل. این اصطکاک زمانی رخ میدهد که توسعهدهندگان با ChatGPT یا Claude نه به عنوان مجموعهای از محیطهای مجزا با هزینههای تأیید متفاوت، بلکه به عنوان ابزارهای یکپارچه برخورد میکنند.
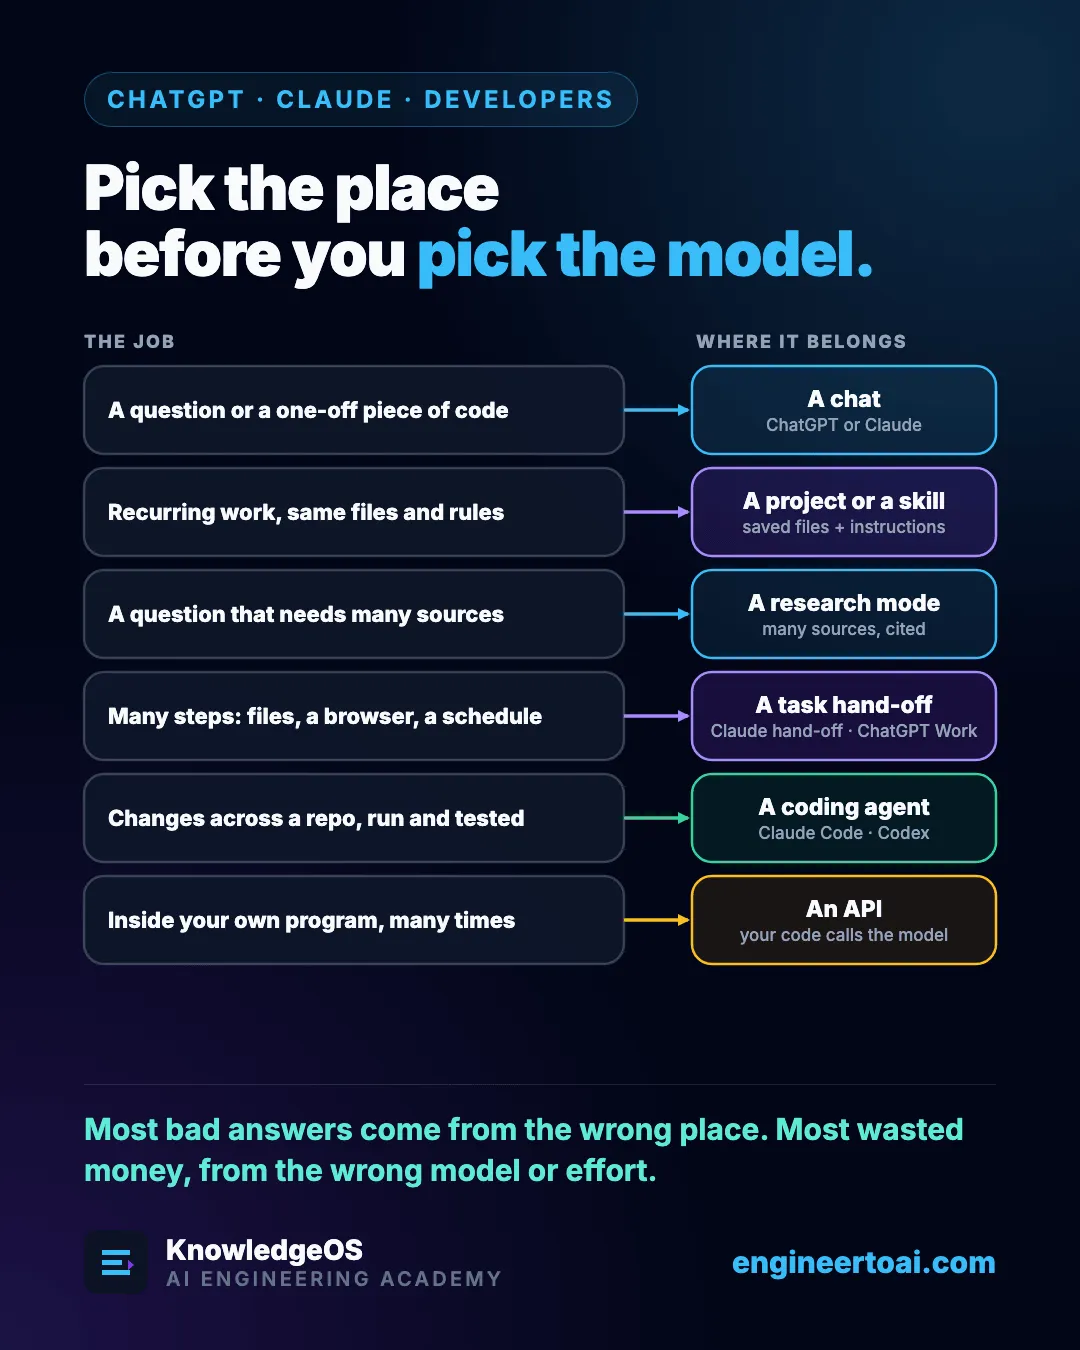
برای بهینهسازی خروجی، باید هر تسک را به محیطی منتقل کنید که بررسی نتیجه در آن ارزانترین حالت ممکن باشد. این چارچوب شامل ۶ محیط اصلی است:
نقشهی جایگذاری هوش مصنوعی
- چت (Chat): مناسب برای پرسشهای یکباره یا توضیحات ساده که تنها بررسی بصری پاسخ کافی است.
- پروژهها/مهارتها (Projects/Skills): ایدهآل برای کارهای تکراری با فایلها و قوانین ثابت؛ برای اینکه هر بار مجبور به ارسال مجدد زمینه نباشید.
- حالت پژوهش (Research Mode): ضروری برای پرسشهایی که نیاز به منابع متعدد و مستند دارند.
- حالت کاری/تفویض تسک (Work Mode): طراحی شده برای خروجیهای چندمرحلهای که به مرورگر یا تقویم نیاز دارند، نه گفتگوهای رفتوبرگشتی. این رویکرد مشابه اتوماسیون کامل در فرآیندهای جستوجوی شغل است که در آن هوش مصنوعی بهجای گفتگو، مستقیماً تسکهای عملیاتی را مدیریت میکند.
- عاملهای کدنویسی (Coding Agents): ابزارهایی مثل Claude Code یا Codex برای تغییرات در سطح مخزن کد ضروری هستند، چون میتوانند با اجرای تستها، صحت کد را ثابت کنند.
- رابط برنامهنویسی (API): تنها گزینه برای تسکهای درونبرنامهای که کنترل کامل روی ورودی، فرمت خروجی و بررسیهای خودکار نیاز است.
بر اساس مستندات این راهنما، پس از تعیین محیط، باید استراتژی «اول مدل میانرده» را پیش بگیرید. یعنی ابتدا با یک مدل میانرده و تلاش پیشفرض شروع کنید و تنها در صورتی که مدل محدودیتهای تعیینشده را نادیده گرفت، سطح مدل یا قدرت استدلال را بالا ببرید.
باید بدانید اگر پاسخ به دلیل نبود اطلاعات غلط است، ارتقای مدل هیچ کمکی نمیکند؛ شما ابتدا باید شواهد را فراهم کنید. این تفکیک حیاتی است چون مدلهای قویتر لزوماً درستتر پاسخ نمیدهند، بلکه «روانتر» حدس میزنند. یک مدل سطح بالا ممکن است توهم (Hallucination) — شبیه دوستی که خاطرهای را با اطمینان کامل اما اشتباه تعریف میکند — را بسیار متقاعدکنندهتر ارائه دهد، بهخصوص اگر فایل منبع در پنجره زمینه (Context Window) نباشد.
برای تیمها، این تغییر دیدگاه مانع از «مشکلات جایگذاری» میشود که هیچ ارتقای مدلی آنها را حل نمیکند. یکی از اشتباهات رایج این است که تصور شود اشتراک ChatGPT یا Claude شامل فراخوانیهای API میشود، در حالی که اینها بهصورت جداگانه و بر اساس توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک — محاسبه میشوند.
با اصلاح مکان اجرا، سپس تنظیم مدل و در نهایت تعدیل تلاش استدلالی، تیمها میتوانند از بحثهای بیپایان درباره اینکه کدام مدل «بهتر» است دست بردارند و جریانهای کاری قابلتأیید بسازند.
گام بعدی شما
- لیست تسکهای روزانه خود را بر اساس ۶ محیط ذکر شده دستهبندی کنید.
- برای تسکهای تکراری، بهجای چت ساده از قابلیت Projects در Claude یا GPTs در OpenAI استفاده کنید.
- در پروژههای کدنویسی، بهجای کپی-پیست، از عاملهای متصل به فایلسیستم استفاده کنید تا قابلیت اجرای تست را داشته باشید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو