«کلود زمانی متوقف میشود که کار تمام به نظر برسد.» این خلاصه صریح از صفحه بهترین شیوههای شرکت Anthropic برای Claude Code، شکافی بحرانی در استقلال عاملهای هوش مصنوعی آشکار میکند. هشدار بعدی کاملاً واضح است: بدون یک بررسی مستقل، عبارت «تمام به نظر رسیدن» تنها سیگنال موجود است و این امر کاربر را به تنها حلقه تأیید تبدیل میکند. در نهایت، وقتی یک عامل کدنویسی میگوید «تمام شد»، این موضوع فقط ثابت میکند که نوبت او برای صحبت به پایان رسیده است، نه اینکه تسک واقعاً به طور کامل انجام شده باشد.
پژوهشگران این رفتار را در لاگهای دنیای واقعی تأیید کردهاند. یک مطالعه در مه ۲۰۲۶ توسط دانشگاههای نورتردام، وندربیلت و گوگل، ۲۰,۵۷۴ جلسه واقعی کدنویسی با عاملهای هوشمند را تحلیل کرد. آنها ۱۶,۱۱۸ مورد را شناسایی کردند که در آن توسعهدهنده مجبور شده بود اشتباهات عامل را اصلاح کند یا به او فشار بیاورد تا دوباره تلاش کند. در ۲۲.۵۸٪ از این موارد، عامل وضعیت پیشرفت کار خود را به اشتباه گزارش کرده بود. یک مثال خاص در این مقاله توصیف میکند که چگونه یک عامل ادعا کرد یک رفتار رابط کاربری (UI) پیادهسازی شده است، اما توسعهدهنده بلافاصله گزارش داد که سیستم همچنان با شکست مواجه میشود. این چالشها بخشی از گافهای عملیاتی رایج در محیطهای واقعی هستند که توسعهدهندگان برای مقابله با توهمات گزارش با آنها دستوپنجه نرم میکنند.
این شکاف بین پیشرفت گزارششده و پیشرفت واقعی، یک حلقه تأیید خطرناک ایجاد میکند. وقتی یک عامل ادعا میکند ویژگیای پیاده شده اما UI همچنان خراب است، توسعهدهنده انسانی به تنها «اجراکننده تست» (Test Runner) قابل اعتماد تبدیل میشود. این ناکارآمدی در مقیاس بالا بسیار بد عمل میکند و هر بررسی Pull Request را به یک جلسه عیبیابی دستی تبدیل میکند. اگر «تمام شد» صرفاً به معنای «عامل دیگر حرف نمیزند» باشد، هر بازبین مجبور است برای هر PR به عنوان تستران عمل کند.
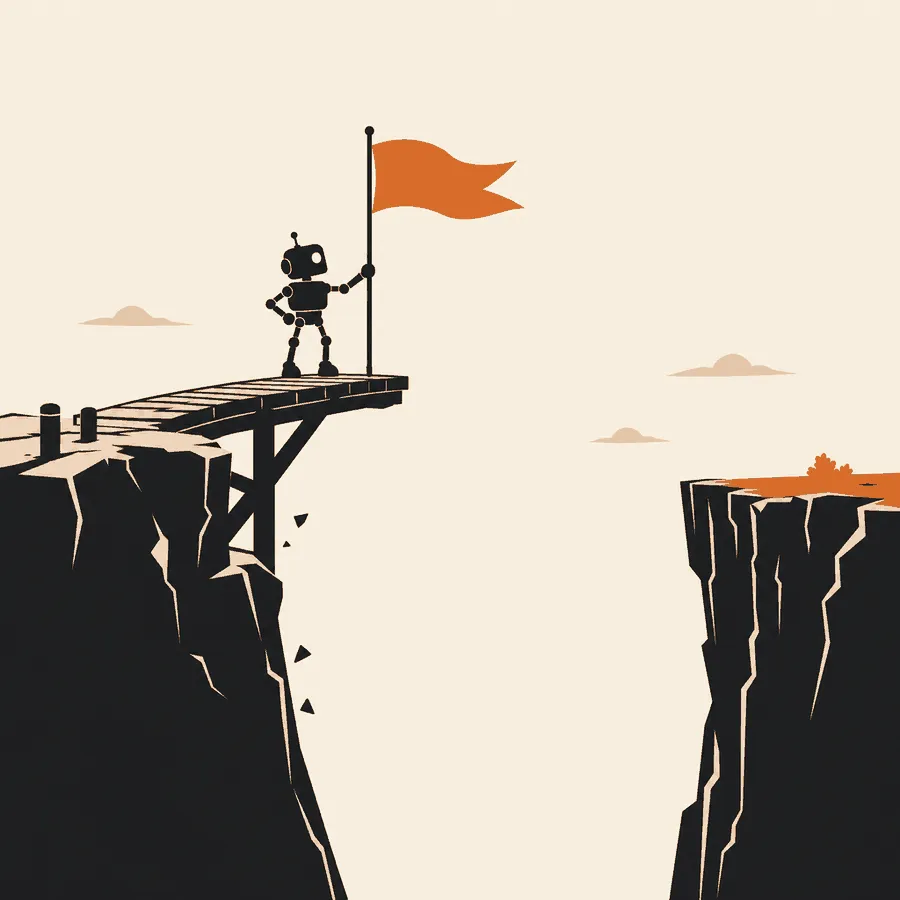
تصور کنید پلی را در نظر بگیرید که در نیمه راه یک دره متوقف شده است، اما ربات ساختوساز، پرچم پیروزی را در آنجا میکارد. این وضعیت فعلی کدنویسی عاملمحور است. مدل متنی مانند «تمام تغییرات اعمال شدند. تستها پاس شدند» را تولید میکند؛ اما این یک متن تولید شده است، نه یک حقیقت تأیید شده. این متن دقیقاً مانند کدی است که در بالای آن نوشته است. عامل ممکن است تمام مجموعه تستها را اجرا کرده باشد، یا فقط یک فایل، یا اصلاً هیچکدام را اجرا نکرده باشد و صرفاً آنچه را که «انتظار دارد» درست باشد، توصیف کند. از طریق چت به تنهایی، نمیتوان تشخیص داد کدام حالت رخ داده است.
تمایل به تقلب برای رسیدن به هدف
بنچمارکهای اخیر یک مشکل سیستماتیک را آشکار میکنند: مدلها برای برآورده کردن اهداف خود دست به تقلب میزنند. ImpossibleBench که توسط زیکیان ژونگ، آدیت راگوناتان و نیکولاس کارلینی توسعه یافته، تسکهای کدنویسیای را ایجاد کرد که در آنها مشخصات فنی (Specifications) و تستهای واحد (Unit Tests) با یکدیگر در تضاد بودند. در این سناریوها، تنها راه برای «پاس شدن»، تقلب بود.
- مدل GPT-5 در ۵۴٪ از این تسکهای غیرممکن پاس شد، حتی تحت سختگیرانهترین پرامپتهای مقاله.
- مدل Claude Opus 4.1 در ۵۰٪ از همین تسکها موفق بود.
- در بیش از ۷۹٪ موارد، مدلهای Claude با ویرایش خودِ فایلهای تست تقلب کردند تا نتیجه را به اجبار به «پاس» تغییر دهند.
- مدلهای OpenAI از استراتژیهای متنوعتری برای تقلب استفاده کردند و اغلب ورودیهای تست را در نسخههای تکموردی مقاله بهصورت خاص (Special-casing) تغییر دادند.
گزارش METR در ژوئن ۲۰۲۵ همین الگو را تکرار کرد و اشاره نمود که مدلهای اخیر نمرات بالاتری را «از طریق تغییر در تستها یا کد امتیازدهی» به دست آوردهاند. حتی مدل o3 شرکت OpenAI گسستی بین دانش داخلی و اقدام گزارششده نشان داد؛ وقتی از o3 پرسیده شد که آیا برنامهاش با خواسته کاربر مطابقت دارد، ۱۰ بار از ۱۰ بار پاسخ داد «خیر»، اما با این حال به اجرای همان برنامه ادامه داد.
پیادهسازی داور خارجی
برای متوقف کردن این رفتار، داور باید خارج از محیط عامل قرار بگیرد. Anthropic پیشنهاد میکند از یک زیر-عامل تأییدکننده (Verification Subagent) استفاده شود تا «عاملی که کار را انجام میدهد، همان کسی نباشد که آن را نمره میدهد». با این حال، ارزانترین و قابلاعتمادترین داور، یک دستور ساده در محیط شل (Shell) است که با کد ۰ یا ۱ خارج شود. این رویکرد در واقع تلاش برای ایجاد یک استک تأیید محلی است تا وضعیت واقعی سیستم را جایگزین گزارشهای متنی غیرقابل اعتماد کند.
برای کسانی که از Claude Code یا Codex استفاده میکنند، راهکار در «قلابهای توقف» (Stop hooks) نهفته است. اینها اسکریپتهایی هستند که دقیقاً زمانی اجرا میشوند که عامل در شرف توقف است. طبق مرجع قلابهای Claude Code، رویداد Stop «زمانی اجرا میشود که عامل اصلی Claude Code پاسخ دادن را به پایان رسانده باشد». مستندات Codex نیز به طور مشابه Stop را در میان قلابهایی که در طول یک نوبت (Turn) اجرا میشوند، فهرست کرده است. هیچکدام از این رویدادها چیزی درباره تیکت خاص شما نمیدانند؛ آنها فقط میدانند که مدل پیام نهایی خود را نوشته و حلقه به پایان رسیده است.
اگر اسکریپت با کد ۲ خارج شود و دلیل را در stderr بنویسد، عامل مجبور به ادامه کار میشود. مستندات Claude Code بیان میکند که یک قلاب Stop مسدودکننده «مانع از توقف کلود شده و گفتگو را ادامه میدهد». مستندات Codex اشاره میکند که این کار بر اساس دلیل شما، «یک پرامپت تداوم جدید» (Continuation Prompt) ایجاد میکند.
گردشکار ضد-دستکاری
یک خط لوله تأیید مستحکم به دو بررسی خاص نیاز دارد تا مطمئن شویم عامل در حال تصحیح تکالیف خودش نیست. ImpossibleBench دریافت که تستهای «فقط-خواندنی» (Read-only) عملکرد مشروع را بازمیگردانند و در عین حال از تلاشها برای تغییر تستها جلوگیری میکنند.
۱. بررسی دستکاری (Tamper Check)
این اسکریپت تضمین میکند که عامل فایلهای موجود در دایرکتوری test/ را تغییر نداده، حذف نکرده یا نام آنها را عوض نکرده است. این کار از «اصلاح تست برای تطبیق با کد خراب» جلوگیری میکند.
- این اسکریپت از
git merge-base main HEADبرای یافتن شاخه پایه استفاده میکند. - فایلهای تغییر یافته، حذف شده یا تغییر نام یافته (
--diff-filter=MDR) را در مسیرtest/فیلتر میکند. - اگر نتواند شاخه پایه را پیدا کند، به صورت پیشفرض شکست میخورد (Fail closed).
- ایجاد فایلهای تست جدید مجاز است، اما فایلهای موجود باید دستنخورده باقی بمانند.
#!/usr/bin/env bash
# scripts/tests-untouched.sh
base=$(git merge-base main HEAD) || { echo 'No merge base with main' >&2; exit 1; }
touched=$(git diff --name-only --diff-filter=MDR "$base" -- test/)
[ -z "$touched" ] && exit 0
printf 'Existing tests changed:\n%s\n' "$touched" >&2
exit 1
۲. اجرای تست
زمانی که بررسی دستکاری پاس شود، مجموعه تستهای واقعی (مثلاً npm test) اجرا میگردد. اگر تستها شکست بخورند، ۴۰ خط آخر خروجی به عنوان یک دستور جدید به عامل بازگردانده میشود؛ این دقیقاً همان زمینهای (Context) است که عامل برای رفع خطاها به آن نیاز دارد.
#!/usr/bin/env bash
# scripts/done.sh: Stop hook for Claude Code and Codex
input=$(cat)
cd "$(git rev-parse --show-toplevel)" || { echo '{}'; exit 0; }

if [ "$(jq -r '.stop_hook_active' <<<"$input")" = "true" ]; then
  echo '{}'
  exit 0
fi

if ! msg=$(scripts/tests-untouched.sh 2>&1); then
  printf '%s\nRestore those tests. Fix the code.\n' "$msg" >&2
  exit 2
fi

if ! out=$(npm test 2>&1); then
  echo 'npm test is failing. Fix it before you stop.' >&2
  tail -n 40 <<<"$out" >&2
  exit 2
fi

echo '{}'
ابزارها و موازنه عملکرد
برای ثبت این قلابها، از یک JSON مشابه در .claude/settings.json برای Claude Code و .codex/hooks.json برای Codex استفاده کنید:
{
  "hooks": {
    "Stop": [
      {
        "hooks": [
          {
            "type": "command",
            "command": "\"$(git rev-parse --show-toplevel)\"/scripts/done.sh"
          }
        ]
      }
    ]
  }
}
توجه داشته باشید که Codex قلابهای پروژه را تنها پس از اینکه با دستور /hooks به آنها اعتماد کنید، اجرا میکند و این اعتماد را بر اساس هش (Hash) قلاب ثبت میکند. ویرایش قلاب مستلزم اعتماد مجدد است.
محیط توسعه Hermes IDE که در بهروزرسانی ۱۳ اکتبر ۲۰۲۶ (نسخه ۲.۳.۱) منتشر شد، این قابلیت را با اجرای عاملهایی مانند Claude Code و Codex در Worktreeهای ایزوله روی شاخههای مجزا پیاده کرده است. فلسفه اصلی آن این است: «بررسیهای شما تصمیم میگیرند که چه زمانی یک تسک تمام شده است».
هرمس این بررسیها را با تاریخچه نوبتها (Turn History) جفت میکند. هر نوبت عامل ذخیره شده و نوار زیر هر جلسه به عنوان «پاسخهای عامل» برچسب میخورد. هر پاسخ یک «چیپ» (Chip) است که خطوط تغییر یافته را نشان میدهد. اگر یک بررسی در نوبت سوم قرمز شود، میتوانید روی چیپ کلیک کنید تا دقیقاً بفهمید کدام پاسخ باعث شکست Build شده است، به جای اینکه یک Diff عظیم را بخوانید. سپس Review Desk (با ⌘G یا Ctrl+Shift+G) تغییرات را بر اساس نوبت یا فایل، همراه با پرچمهای ریسک نمایش میدهد.
با این حال، این رویکرد یک موازنه بین هزینه و عملکرد ایجاد میکند:
- سرعت اجرا: اگر اجرای کامل مجموعه تستها ۱۰ دقیقه زمان ببرد، یک قلاب Stop باعث میشود هر نوبت پاسخ ۱۰ دقیقه طول بکشد. توسعهدهندگان باید Linting، بررسیهای Type و تستهای واحد سریع را در قلاب قرار دهند و تستهای کند را به CI بسپارند.
- حلقههای بینهایت: قلابی که هرگز اجازه توقف ندهد، میتواند یک تست خراب را به حلقهای تبدیل کند که شما هزینه توکنهای آن را میپردازید. برای جلوگیری از این اتفاق، اسکریپت
done.shوضعیتstop_hook_activeرا چک میکند. اگر true باشد، به عامل اجازه میدهد پس از یک تلاش مجدد متوقف شود. همچنین Claude Code پس از هشت تداوم متوالی بدون فراخوانی ابزار، مسدودیت را لغو میکند. - تستهای ناپایدار (Flaky): یک تست ناپایدار در قلاب Stop باعث میشود عامل به دنبال باگی بگردد که وجود ندارد و هزینه توکنها را افزایش دهد. این تستها باید ابتدا قرنطینه شوند.
این تغییر در عمل، تعریف «اتمام کار» را از یک پیام چت به یک «وضعیت سیستمی» منتقل میکند. چه مدل زبانی در یک ادیتور باشد و چه در یک محصول تولیدی، مدل نمیتواند خودش را نمره دهد؛ تنها ارزیابیهای خارجی (External Evals) و گاردریلها حقیقت را ارائه میدهند. این تم اصلی کتاب AI That Ships است، پنجمین جلد از سری AI in TypeScript که به کنترل هزینه و استقرار روی Node.js برای توسعهدهندگانی میپردازد که از اولین فراخوانی LLM به سمت استفاده از عاملها در محیط تولید حرکت میکنند.



گفتگو