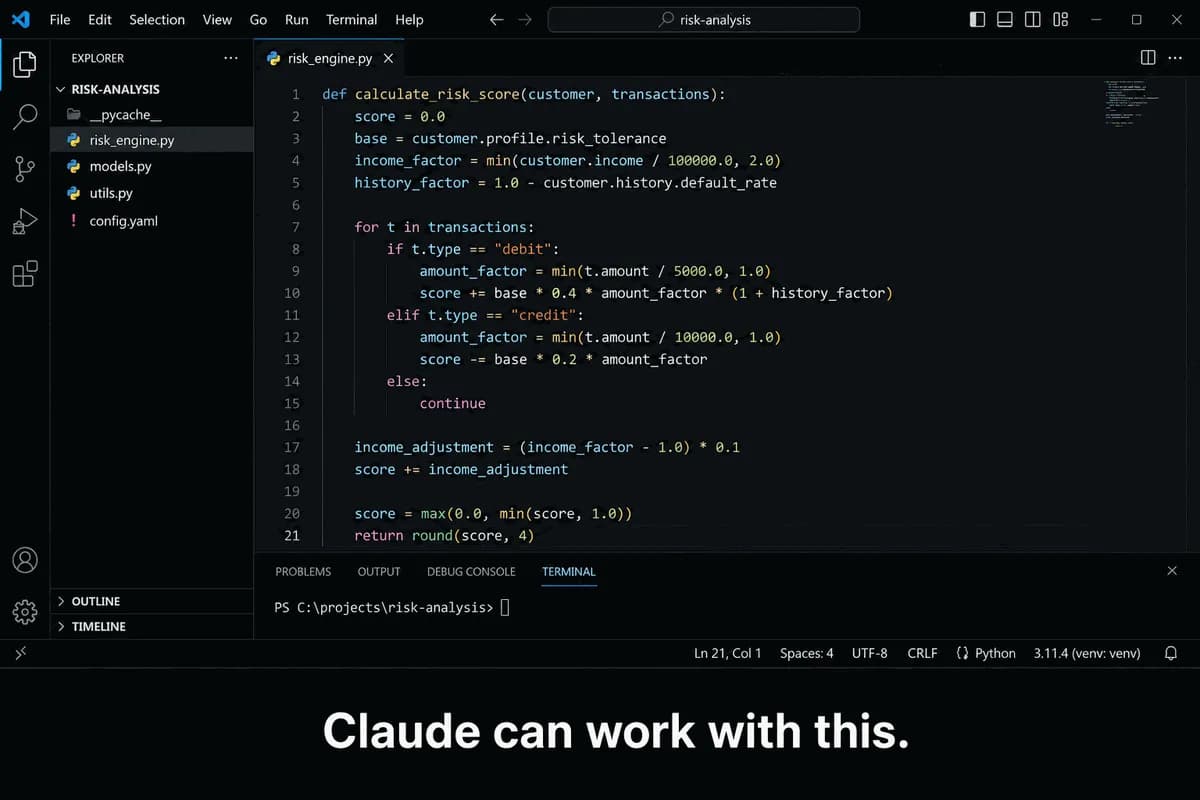
اگر شما برنامهنویسی هستید که در شرکتی کار میکند که به دلیل ترس از نشت دادهها، استفاده از هوش مصنوعی ابری را ممنوع کرده، احتمالاً مقدار کدی که مدل واقعاً برای کمک به شما نیاز دارد را بیش از حد تخمین زدهاید. پروژه جدیدی به نام Kiri که در ۱۰ ژوئن ۲۰۲۶ معرفی شد، این فرض را که برای دریافت کمکهای معنادار، حتماً باید تمام سورسکد در اختیار مدل قرار گیرد، به چالش میکشد.
شرکتها سالهاست با یک انتخاب سخت روبرو بودهاند: یا ابزارهای هوش مصنوعی را کاملاً ممنوع کنند یا ریسک ارسال دانش فنی محرمانه به فضای ابری را بپذیرند. این تنش به این دلیل است که سورسکد فقط شامل منطق برنامهنویسی نیست؛ بلکه مخزنی از سالها تجربه است. این تجربه شامل مدلهای قیمتگذاری، استراتژیهای بهینهسازی و جریانهای کاری خاص مشتریان است که در واقع همان چیزی است که یک شرکت را از رقیبانش متمایز میکند.
تصور کنید برای اینکه یک هوش مصنوعی فقط نام یک متغیر را بهتر پیشنهاد دهد، مجبور باشید فرمول سری یک محصول را لو دهید. بسیاری از توسعهدهندگان از اینکه هوش مصنوعی بازنویسی کدها یا حذف کدهای تکراری را آسان میکند لذت میبرند، اما مدیریت شرکتها همچنان نگران هستند چون سورسکد، گنجینه دانش رقابتی آنهاست. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای زبانی اشاره کردیم، تعادل بین بهرهوری و حریم خصوصی همواره نقطه حساس این فناوری بوده است.
برای حل این مشکل، Kiri به عنوان یک واسطه بین برنامهنویس و مدلهای هوش مصنوعی مثل Claude عمل میکند. این پروژه یک پرسش بنیادی را مطرح میکند: آیا مدل واقعاً به «پیادهسازی» نیاز دارد یا فقط به «قصد» (Intent) برنامهنویس؟
به جای ارسال کد خام، این ابزار بلوکهای کد محافظتشده را با توصیفات عملکردی جایگزین میکند. برای مثال، یک تابع پیچیده و محرمانه برای محاسبه ریسک مشتری که به صورت def calculate_risk_score است، از منطق داخلیاش تهی میشود. به جای پیادهسازی واقعی، مدل فقط یک توضیح کوتاه میبیند که میگوید: «این تابع یک امتیاز ریسک نرمالشده بین ۰ و ۱ را بر اساس پروفایل و تاریخچه تراکنشها محاسبه میکند».
طبق گزارش وبسایت dev.to، این سیستم بررسی میکند که وقتی جزئیات پیادهسازی حذف میشوند، چه مقدار از کاربردی بودن مدل باقی میماند. گردش کار سیستم به این ترتیب است:
- دستیار کدنویسی یک پرامپت میفرستد.
- Kiri درخواست را رهگیری میکند.
- پیادهسازیهای محافظتشده با توصیفات عملکردی جایگزین میشوند.
- پرامپت تغییریافته به مدل ارسال میشود.
- مدل پاسخ معمولی خود را میدهد.
پروژه Kiri بر این ایده استوار است که مدلهای مدرن کدنویسی — مثل یک معمار که برای بررسی استحکام ساختمان نیازی به دانستن رنگ هر پیچ ندارد — بیشتر از دادههای ساختاری ارزش میگیرند تا منطق خام. نویسنده دریافت که مدلها کمتر از آنچه ما تصور میکنیم، به جزئیات پیادهسازی اهمیت میدهند.
مجموعه بنچمارکهای این پروژه روی چند حوزه کلیدی تمرکز دارد:
- بافت ساختاری: قراردادهای نامگذاری، رابطها و امضاهای توابع.
- طراحی سطح بالا: الگوهای معماری و ساختار فایلها.
- مستندات: کامنتهای کد و بافت surrounding.
با حفظ این عناصر، Kiri آزمایش میکند که آیا مدل همچنان میتواند کدهای اطراف را توضیح دهد، تست بنویسد، بازنویسی پیشنهاد کند یا معماری را بررسی کند، بدون اینکه «دستور پخت سری» شرکت را دیده باشد.
نویسنده در ابتدا تنها بر اساس حدس و گمان پیش میرفت، اما برای رسیدن به نتیجه، یک مجموعه بنچمارک ساخت. هدف این نبود که ثابت کند حذف کد همیشه جواب میدهد (چون نمیدهد) یا مدلها هرگز به پیادهسازی نیاز ندارند (چون اغلب نیاز دارند)، بلکه هدف درک این بود که چه مقدار کد را میتوان حذف کرد و کدام روشها بهتر عمل میکنند.
نتایج نشان داد که برخی وظایف سریعاً کیفیت خود را از دست میدهند، اما برخی دیگر بهطور شگفتآوری مقاوم هستند. این پژوهش نشان میدهد که سورسکد در لایههای مختلفی از اطلاعات قرار دارد:
- رابطها و قصد کاربر
- معماری
- قوانین کسبوکار
- منطق پیادهسازی
- دانش رقابتی
همه این لایهها ارزش یکسانی ندارند و برای هر وظیفهای لازم نیستند. با جداسازی این لایهها، تیمها میتوانند یک «شکاف امنیتی» برای ارزشمندترین داراییهای فکری خود ایجاد کنند و در عین حال از قدرت هوش مصنوعی ابری بهره ببرند.
برای یک توسعهدهنده معمولی، این یعنی تغییر محور بحث. سوال دیگر این نیست که «آیا باید از هوش مصنوعی استفاده کنیم؟»، بلکه این است که «هوش مصنوعی برای حل این مسئله خاص، دقیقاً به چه اطلاعاتی نیاز دارد؟»
اگر این رویکرد مقیاسپذیر شود، میتواند پذیرش هوش مصنوعی را در صنایع با نظارت شدید مثل امور مالی یا دفاعی ممکن کند. این تغییر، هوش مصنوعی را از ابزاری که اسرار شما را میخواند، به ابزاری تبدیل میکند که نیات شما را میفهمد. نویسنده اعتراف میکند که مسئله پیچیده است، اما این فرض را که مدل ابری برای مفید بودن باید همه چیز را ببیند، رد میکند.
گام بعدی شما
- اگر در محیطی با محدودیتهای امنیتی شدید کار میکنید، سعی کنید توابع حساس خود را با Docstringهای دقیق جایگزین کرده و پاسخ مدل را بسنجید.
- مخزن گیتهاب Kiri اثر پائولو ماسینیان را بررسی کنید تا متوجه شوید در چه مواردی حذف کد منجر به شکست مدل میشود.
- بخش بنچمارک در README پروژه را مطالعه کنید تا لایههای اطلاعاتی کدتان را شناسایی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.


گفتگو