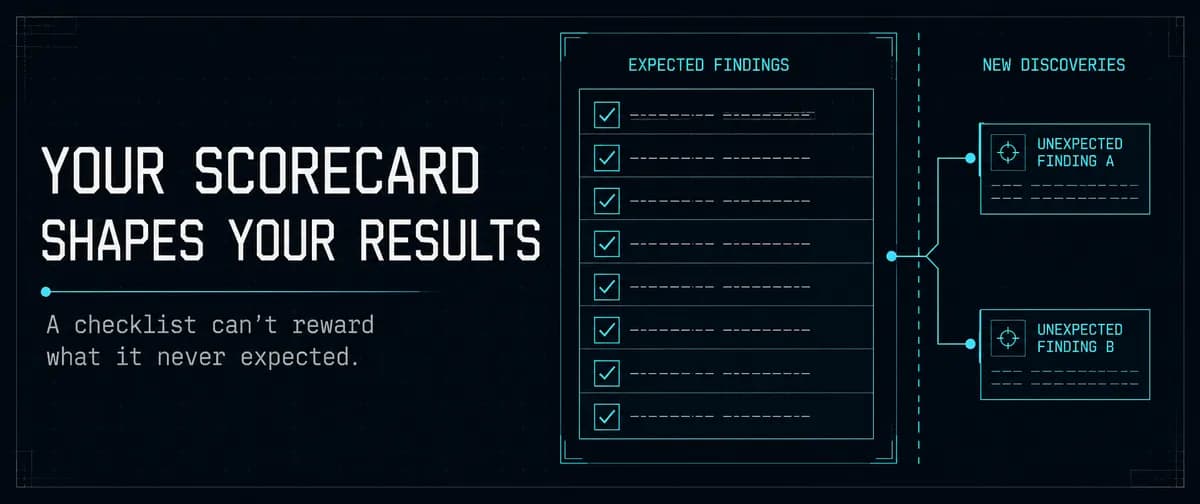
تصور کنید یک بازرس سختگیر استخدام کردهاید که فقط خطاهای فهرستشده در دفترچه راهنما را گزارش میکند و هرچه دقیقتر ببیند، بابت گزارشِ موارد «خارج از لیست» جریمه شود. در چنین سیستمی، شما به جای یافتن باهوشترین بازرس، کسی را پیدا میکنید که فقط شبیه شما فکر میکند.
طبق گزارشی که در ۲۵ ژوئیه ۲۰۲۶ منتشر شد، یک مهندس سه دستیار کدنویسی هوش مصنوعی را با استفاده از یک چکلیست پیشتعیینشده ارزیابی کرد. نتایج این آزمایش یک نقطه کور سیستمی را افشا کرد: بنچمارکهای استاتیک به جای اندازهگیری کیفیت بررسی کد، در واقع میزان توافق مدل با پیشفرضهای نویسنده را میسنجند. به همین دلیل، هر یافتهای که در چکلیست نبود، بهطور خودکار برچسب مثبت کاذب (False Positive) — یعنی گزارش خطایی که در واقعیت وجود ندارد — میخورد. این پدیده یادآور چالشهای پیچیدهتری است که در بهینهسازی معیارهای ارزیابی برای جلوگیری از جعل نتایج توسط عاملهای هوش مصنوعی به آنها پرداخته بودیم.

همانطور که در تحلیلهای قبلی ما دربارهی سوگیریهای مدلهای زبانی اشاره کردیم، این مدلها تمایل دارند پاسخهایی بدهند که کاربر انتظار دارد، نه لزوماً پاسخهای درست. برای رفع این مشکل، ارزیاب نتایج را به دو دسته تقسیم کرد:
- یافتههای مورد انتظار: مواردی که با چکلیست اولیه مطابقت داشتند.
- یافتههای جدید: کشفیاتی خارج از لیست که توسط یک شخص ثالث بهصورت مستقل بازبینی شدند تا سوگیری ارزیاب حذف شود.
به نقل از گزارش وبسایت dev.to، این تغییر ساختاری باعث شد دو خطای مهندسی واقعی که نویسنده اصلی کد نادیده گرفته بود، شناسایی شوند. نکته کلیدی این است که این کشفیات توسط دو مدل مختلف انجام شد و هیچکدام نتوانستند یافتههای مدل دیگر را پیدا کنند. این یعنی مدلها در رتبهبندی کلی قرار نمیگیرند، بلکه نقاط قوت یکدیگر راe کامل میکنند. در واقع، تغییر رویکرد از امتیازدهی ساده به تحلیل عمیقتر، میتواند مانند تجربه تغییر جایگاه تحلیل و امتیازدهی، کیفیت بازخوردهای مدل را بهشدت بهبود ببخشد.
بر اساس مستندات این آزمایش، شکاف عمیقی در نقشهای مدلها دیده میشود. در حالی که مدلها در اجرای دستورات صریح برای بازبینی (Revision) مشابه عمل کردند، اما در یافتن خطاهای پیشبینینشده، عملکردشان بهشدت متفاوت بود. این نشان میدهد انتخاب یک ابزار برای «ویرایش کد» با انتخاب ابزاری برای «بازبینی کد» (Code Review)، دو مسئله بهینهسازی کاملاً متفاوت است. برای دستیابی به نتایجی دقیقتر در این مرحله، استفاده از ساختارهای چهار قسمتی در پرامپتها میتواند اثرات کلیگویی را کاهش دهد.
برای متخصصان، این معنای آن است که یک چکلیست تنها نیمی از حقیقت است. تکیه صرف به نتایج پیشبینیشده، مدلهایی را پاداش میدهد که «چاپلوس» هستند و 능 lực اصلی یک بازبین هوش مصنوعی — یعنی دیدن آنچه انسان از قلم انداخته — را نادیده میگیرد.
گام بعدی شما
- بنچمارکهای داخلی خود را بازبینی کنید تا مطمئن شوید کشفیات درست اما «خارج از انتظار» را جریمه نمیکنید.
- برای خروجیهایی که با نتایج مورد انتظار شما متفاوت است، یک بازبین انسانی مستقل (Blind Reviewer) تعریف کنید.
- از ترکیب دو مدل مختلف برای بازبینی کد استفاده کنید، چرا که احتمالاً نقاط کور یکدیگر را میپوشانند.
اما این چالش ارزیابی تنها بخشی از ماجراست؛ اثر این سوگیریها بر آموزش مدلهای استدلالی را در گزارش بعدی بررسی خواهیم کرد.



گفتگو