تصور کنید برای یک برنامهنویس دستور میدهید که کامنتهای کد را کم کند، اما او همچنان هر خط را با توضیحات طولانی میپوشاند؛ این دقیقاً همان اتفاقی است که در تعامل با Claude رخ میدهد. درخواست یک توسعهدهنده برای کاهش کامنتها در یک فایل CLAUDE.md نتوانست مانع از توضیحنویسی بیش از حد مدل شود. این موضوع ثابت میکند که فایلهای دستورالعمل، ابزارهای جادویی برای پیکربندی مدل نیستند. طبق گزارشی که در ۸ اکتبر ۲۰۲۶ منتشر شد، این شکست نشاندهنده یک شکاف بحرانی میان نحوه استفاده توسعهدهندگان از هوش مصنوعی و نحوه پردازش واقعی راهنماییها توسط مدلها است.
بسیاری از تیمها اکنون از عاملهای هوش مصنوعی (AI Agents) — شبیه به کارمندانی که میتوانند بهطور مستقل وظایفی را انجام دهند — هم برای نوشتن و هم برای بازبینی کد استفاده میکنند. این وضعیت یک حلقه بازخورد خطرناک ایجاد کرده است. به گزارش نویسنده، او شاهد جلساتی با Claude بوده است که در آن، یک جلسه بازبینی تغییری را بررسی میکند که یک جلسه دیگر از همان Claude پیشتر آن را بازبینی و تایید کرده است. در چنین سناریوهایی، یک انسان همچنان باید مسئولیت تایید نهایی را بر عهده بگیرد. این وضعیت زمانی بسیار دشوار و ناخوشایند میشود که انسان مربوطه، تغییری را که از او خواسته شده تایید کند، بهطور کامل درک نکند. این چالش دقیقاً همان نقطهای است که ابزارهایی مانند StareBrain تلاش میکنند تا از تبدیل شدن ناظران انسانی به مهر تایید ساده جلوگیری کنند.
این مشکل زمانی تشدید میشود که حجم تولید نرمافزار افزایش مییابد، در حالی که عمق بازبینی انسانی برای همگام شدن با این سرعت تلاش میکند اما شکست میخورد. بازبینیها عجولانهتر شدهاند. فشار برای پیشروی سریع — که با درخواستهایی مانند «هی، ما باید عجله کنیم. میتوانی این را سریع چک کنی؟» شناخته میشود — اساساً با داشتن زمان کافی برای درک درست اثر و کار متفاوت است.
این وضعیت شبیه به کارخانهای است که در آن ماشینی که قطعه را میسازد، فرم بازرسی کیفیت را هم امضا میکند. اگر ماشین در ساخت قطعه اشتباه کند، به احتمال زیاد همان اشتباه را در مرحله بازرسی هم نادیده میگیرد. این دقیقاً همان وضعیتی است که بسیاری از جریانهای کاری توسعه مبتنی بر هوش مصنوعی امروز تجربه میکنند.
توهم کنترل
فایلهای دستورالعمل مثل CLAUDE.md برای هدایت مدل طراحی شدهاند، اما قدرت اجرایی و الزامآور ندارند. بر اساس تجربه نویسنده با ابزارهای Anthropic، این فایلها بیشتر به عنوان پنجره زمینه (Context Window) — مثل میز کاری که فقط جای چند ورق کاغذ دارد و مدل هر چه روی آن باشد را میبیند — عمل میکنند تا یک تنظیمات سختافزاری یا پیکربندی قطعی. نوشتن کلمه «همیشه» در یک فایل Markdown، انجام آن کار را برای هوش مصنوعی اجباری یا گریزناپذیر نمیکند.
به همین دلیل، زنجیرههای پیچیده پرامپت غیرقابل اعتماد هستند. نویسنده که سابقه کار با طیف گستردهای از ابزارها، از نسخههای اولیه GitHub Copilot و ChatGPT گرفته تا Claude Code و مقدار زیادی از Codex را دارد، استدلال میکند که ساخت زنجیرههای دستوری پیچیده، بسیار کماثرتر از بررسی ساده نتیجه نهایی است. در همین راستا، تنظیمات جدید Copilot سعی دارند با جداسازی پیشنویسها از تغییرات جدید، تداخل تحلیلهای هوش مصنوعی را کاهش دهند. اگر یک شرط برای پذیرش کد به اندازه کافی مهم است که مانع از پذیرش یک تغییر شود، بررسی آن شرط باید فارغ از اینکه عامل کدنویس آن را به یاد میآورد یا خیر، اجرا شود.
حرکت به سمت بررسیهای مستقل
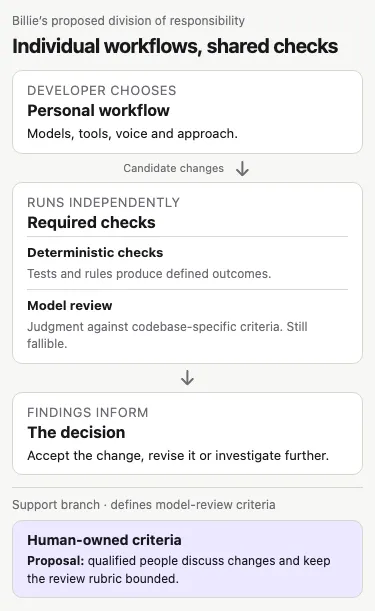
راهکار پیشنهادی نویسنده، سیستمی است که در آن معیارهای پذیرش از عامل کدنویس جدا (Decoupled) شوند. هدف این است که اطمینان حاصل شود بررسیها حتی اگر عامل فراموش کرد آنها را فعال کند، باز هم انجام شوند. این یک تمایز ایجاد میکند که بهراحتی میتوان آن را گم کرد: الزام به اینکه یک بازبینی اتفاق بیفتد، لزوماً به معنای قابل اعتماد بودن حکم آن بازبینی نیست.
این بررسیها به دو دسته تقسیم میشوند:
- بررسیهای مکانیکی: شرایط پذیرشی که میتوانند بهصورت مکانیکی و بدون دخالت انسان ارزیابی شوند.
- بررسیهای قضاوتی: الزاماتی که نیاز به قضاوت درباره یک تغییر خاص و درک گستردهتر از کل پایگاه کد (Codebase) دارند.
اجرای بازبینی توسط یک مدل، نتیجه را قطعی (Deterministic) نمیکند. یک مدل بازبین همچنان ممکن است یک الزام را اشتباه بفهمد، مشکلی را نادیده بگیرد یا پس از یک بهروزرسانی مدل، پاسخ متفاوتی بدهد. بنابراین، عبارت «به نظر خوب میرسد» از سوی یک هوش مصنوعی دیگر، ثابت نمیکند که کد واقعاً خوب است. صرفاً افزودن یک بازبین خودکار به یک Pull Request نمیتواند به سوالات حیاتی پاسخ دهد: این مدل دقیقاً چه چیزی را چک میکند؟ معیارهای آن تا چه حد بر اساس این پایگاه کد خاص استوار است؟ و چه میزان میتوان به قضاوت آن اعتماد کرد؟
نظارت انسانی بر معیارها
نویسنده پیشنهاد میکند تیمها یک «شورای تخصصی» از افراد واجد شرایط تشکیل دهند تا از معیارهای خاص هر پروژه محافظت کنند. این پیشنهادی است برای اطمینان از اینکه بیش از یک نفر درباره تغییرات بحث کنند و درک کنند که چرا هر الزام در آنجا قرار دارد.
این رویکرد از «تورم معیارها» جلوگیری میکند؛ وضعیتی که در آن هر پیشنهاد متقاعدکننده از سوی هوش مصنوعی به یک قانون تبدیل میشود، بدون اینکه کسی واقعاً از آن دفاع کرده باشد. عادت رایجی شکل گرفته که توضیحات متقاعدکننده مدل را به عنوان مرجع بپذیریم و فکر کنیم «اوه، Claude اینطور گفت، پس از این به بعد روش کار همین است». نویسنده میخواهد پیش از تبدیل شدن یک توضیح به قانون، اصطکاک و بحث وجود داشته باشد. محدود نگه داشتن مجموعه الزامات، بخش کلیدی نگهداری از پایگاه کد است.
این تغییر رویکرد، تمرکز را از «آیینهای پرامپتنویسی» — یعنی وسواس در انتخاب کلمات دستورالعمل — به دفاع از نیازهای واقعی پروژه منتقل میکند. با توافق بر سر نتایج نهایی و بررسی نتیجه، توسعهدهندگان میتوانند از ابزارهای مختلفی مثل Claude یا Codex استفاده کنند بدون اینکه کیفیت فدا شود. یک جریان کاری دقیق ممکن است برای یک نفر مناسب باشد، در حالی که یک گفتگوی طولانی برای فردی دیگر بهتر عمل کند.
ارزش دانش کدگذاریشده
اگرچه نویسنده در ابتدا به پلاگینها با تردید مینگریست و آنها را ساده میدید، اما میپذیرد که پلاگینها میتوانند حاوی ابزارها، قلابها (Hooks) و دستورالعملهای مفیدی باشند. در واقع، بررسی تاثیر پلاگینهای Claude Code نشان میدهد که این ابزارها میتوانند در ارتقای مهارتهای عملی مدل نقش داشته باشند. برخی دانشهای انسانی «معدن طلا» هستند و ارزش کدگذاری شدن دارند، مانند:
- درک عمیق از مسئله.
- شناخت محدودیتهای خاص و دقیق پروژه.
- توانایی تشخیص موارد مهم بر اساس تجربه.
مدل میتواند به بیان این دانش در قالب یک سند قابل استفاده کمک کند تا نیاز به تکرار مداوم زمینه (Context) نباشد. اما نویسنده ارزش مستندات طولانی جریان کاری را که حاوی هیچ چیزی نیست که یک انسان نتواند با پرسش از همان مدل تولید کند، زیر سوال میبرد. تولید متن ارزان است؛ ارزش واقعی در دانش پشت آن متن نهفته است.
رابط جدید جریان کاری
نویسنده همچنین استفاده از رابطهای تبدیل گفتار به متن، بهویژه Wispr Flow را برای پالایش ایدهها توصیه میکند. این مقاله حاصل گفتگوهایی است که در آن نویسنده افکارش را دیکته کرده و از مدل خواسته است آنها را به چالش بکشد و بازجویی کند. این پرسشها به نویسنده کمک کرد تا معنای دقیقتری را بیان کند و انتقادات کلی خود از پلاگینها را اصلاح نماید.
به جای پرامپتهای سخت و خشک، فرآیند جدید شامل صحبتهای پراکنده، پاسخ به سوالات تولید شده توسط مدل و اصلاح مسیر از طریق گفتگو است. او ترجیح میدهد پاسخها را بخواند تا بتواند دقیقاً بررسی کند مدل چه چیزی را فهمیده و تصمیم بگیرد کجا را باید اصلاح کرد، به جای اینکه به صحبتهای مدل گوش دهد.
در نهایت، با انتشار هر مدل جدید، پیشنهاد میشود مدل از دستورالعملهای موجود و فایلهای Markdown بازبینی (Audit) بگیرد. این امر پذیرش این واقعیت است که آنچه برای یک نسخه از هوش مصنوعی کار میکرد، ممکن است برای نسخه جدید غیرضروری، مانع، یا از همان ابتدا چیزی باشد که هرگز بهطور سازگار دنبال نشده است. این تغییر در عمل به این معناست که اصطکاک باید روی «معیارهای پذیرش» قرار گیرد، نه روی «فرآیند تولید».
گام بعدی شما
- به جای پیچیدهتر کردن فایلهای
.mdیا پرامپتها، لیستی از تستهای مکانیکی (Unit Tests) بنویسید که خروجی مدل را مستقل از دستورات چک کند. - برای هر پروژه یک سند «معیارهای پذیرش» (Acceptance Criteria) کوتاه و انسانی داشته باشید و هر پیشنهاد مدل را با آن تطبیق دهید.
- در صورت بهروزرسانی مدل (مثلاً انتقال از Claude 3.5 به 4)، از خود مدل بخواهید دستورالعملهای قدیمی شما را نقد کرده و موارد زائد را حذف کند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو