
اگر توسعهدهنده هستید و برای هر قابلیت جدید در عاملهای هوش مصنوعی خود روی «شانس» حساب میکنید، زمان تغییر است. حالا میتوانید با یک دستور ساده ثابت کنید که یک پلاگین واقعاً باعث بهبود عملکرد Claude Code شده است یا صرفاً یک تزئین اضافی است.
طبق اعلام Anthropic در ۱۴ سپتامبر ۲۰۲۶، ابزار claude plugin eval توسعه پلاگینها را از حالت «دمو-محور» به «داده-محور» منتقل میکند. این ابزار دقیقاً مقدار افزایشی (Lift) را که یک مهارت خاص به نرخ موفقیت یک عامل (Agent) — شبیه به دستیاری که برای هر وظیفه ابزار خاصی در دست دارد — اضافه میکند، اندازهگیری میکند. این رویکرد در واقع پاسخی به چالشهای مقایسه عملکرد مدلهای پایه در برابر نسخههای پلاگیندار است تا توسعهدهندگان بتوانند تأثیر واقعی هر ابزار را بسنجند.
همانطور که در تحلیل قبلی ما دربارهی استفاده دانشآموزان از مدلهای زبانی و GPT-5 برای حل مسائل پیچیده ریاضی اشاره کردیم، تمرکز ابزارهای جدید اکنون روی جریان کاری حرفهایهاست. برای اکثر برنامهنویسان، افزودن ابزار به یک عامل هوش مصنوعی اغلب شبیه حدس زدن است؛ شما میبینید که ابزار یک بار در چت درست عمل میکند و فرض میکنید برای محیط عملیاتی (Production) آماده است. اما در واقعیت، ممکن است مدل پایه بدون آن پلاگین هم مسئله را حل میکرد و در نتیجه پلاگین شما زائد است.
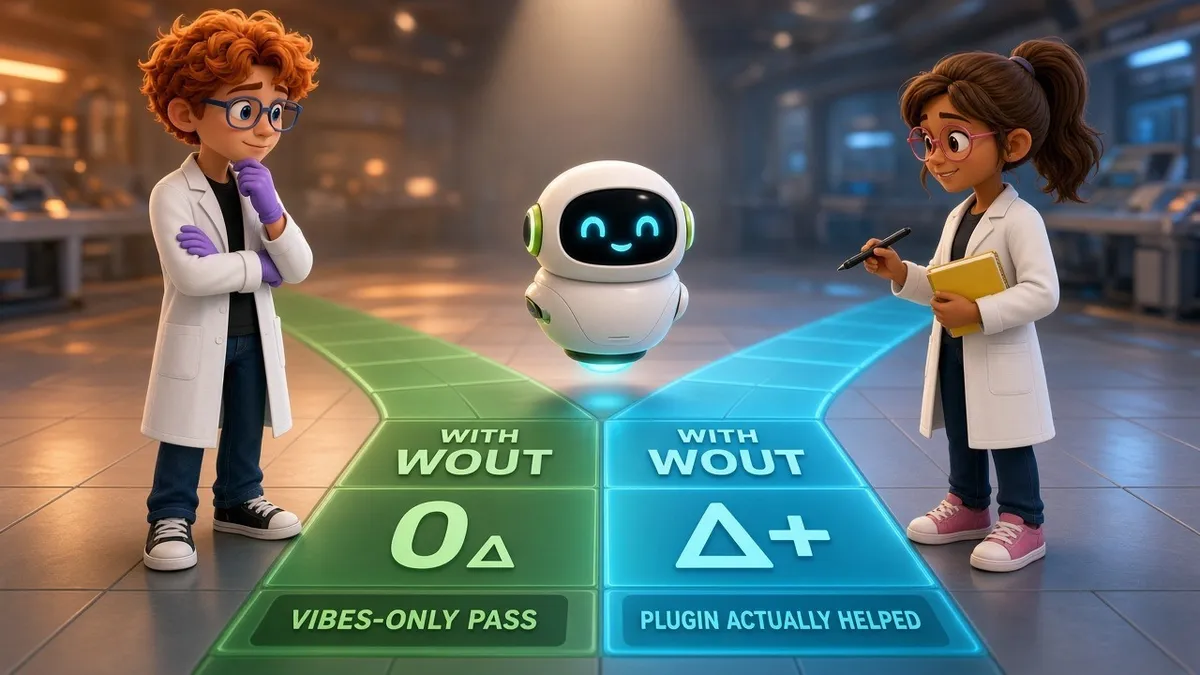
مکانیزم دلتا (Δ)
هسته این سیستم بر پایه آزمون «دو-بازویی» (Two-arm test) است. وقتی ارزیابی را اجرا میکنید، Claude Code (نسخه ۲.۱.۲۶۹ به بالا) مجموعه تستهای شما را دو بار اجرا میکند: یک بار با پلاگین بارگذاری شده (WITH) و یک بار بدون آن (W/OUT). سپس ابزار مقدار «دلتا» (Δ) را محاسبه میکند که همان تفاوت امتیاز بین این دو اجراست.
اگر هر دو امتیاز WITH و W/OUT بالا باشند، دلتا نزدیک به صفر است. این یعنی پلاگین شما تأثیر واقعی روی نتیجه نگذاشته و «عقربه» را تکان نداده است. بر اساس مستندات Anthropic، این سازوکار مانع از ادغام مهارتهای «بیفایدهای» میشود که مدل بهصورت پیشفرض و بومی (Natively) قادر به انجام آنهاست.
تیمهای عملیاتی اغلب متوجه میشوند که در حالی که دلتا نزدیک به صفر است، اما شاخص tool_used خطا میدهد. این نشان میدهد که کلود هنگام استفاده از عبارات طبیعی، هرگز آن مهارت را انتخاب نکرده است. در این شرایط، راهکار این است که روی توضیحات (Description) مهارت بازنگری کرده و دوباره ارزیابی را اجرا کنید. برای جلوگیری از ایجاد «بهبود کاذب»، امتیازات مربوط به داوران tool_used در حالت دو-بازویی از مجموع نمرات هر دو بازو حذف میشوند.
پیادهسازی فنی و داوران
توسعهدهندگان باید موارد تست را در پوشه evals/ در کنار فایل مانیفست پلاگین (plugin.json یا .claude-plugin/plugin.json) قرار دهند. هر مورد شامل یک پرامپت واقعی کاربر و یک یا چند «داور» (Grader) است که موفقیت را تعیین میکنند.
انواع داوران و هزینهها:
- داوران رایگان: ابزارهایی مثل
regex(عبارات منظم)،tool_used(استفاده از ابزار)،tool_order(ترتیب ابزارها) وfile_exists(وجود فایل) که سریعاً متن یا فایلها را بررسی میکنند و هزینه اضافی ندارند. - داوران پولی: مدلهای
llmوbaselineکه از یک مدل داور برای نمره دادن به خروجی استفاده میکنند و به تخمین قیمت نهایی هر اجرا اضافه میشوند.
برای مقابله با عدم قطعیت (Non-determinism) مدلهای هوش مصنوعی، سیستم بهصورت پیشفرض هر مورد را سه بار برای هر بازو اجرا میکند. این کار تضمین میکند که یک اجرای موفق اتفاقی، ارزش مهارت را بیش از حد واقعی نشان ندهد. برای تکرارهای ارزان در زمان پیشنویس، توسعهدهندگان میتوانند از فلگهای --runs 1 --ablation none استفاده کنند، اما برای اعتماد به نتایج، اجرای پیشفرض سه باره ضروری است.
راهنمای راهاندازی سریع
برای شروع باید نسخه ۲.۱.۲۶۹ یا بالاتر را داشته باشید. ابتدا با دستورات claude --version و claude update نسخه خود را بررسی و بهروز کنید. جریان کاری به این صورت است:
۱. اجرای claude plugin eval init --bare <case> برای ساخت یک قالب اولیه.
۲. تعریف پرامپت در evals/<case>/prompt.md. پرامپت باید یک درخواست طبیعی باشد (مثلاً «برای این تغییر یک پیام کامیت بنویس») بدون اینکه نام مهارت را صراحتاً ذکر کنید.
۳. افزودن داور نتیجه (llm یا regex) و یک داور فعالشدن مهارت در evals/<case>/graders/criteria.md با استفاده از نوع tool_used.
۴. اجرای claude plugin eval . و بررسی گزارش HTML تولید شده.
ادغام با خط لولههای CI/CD
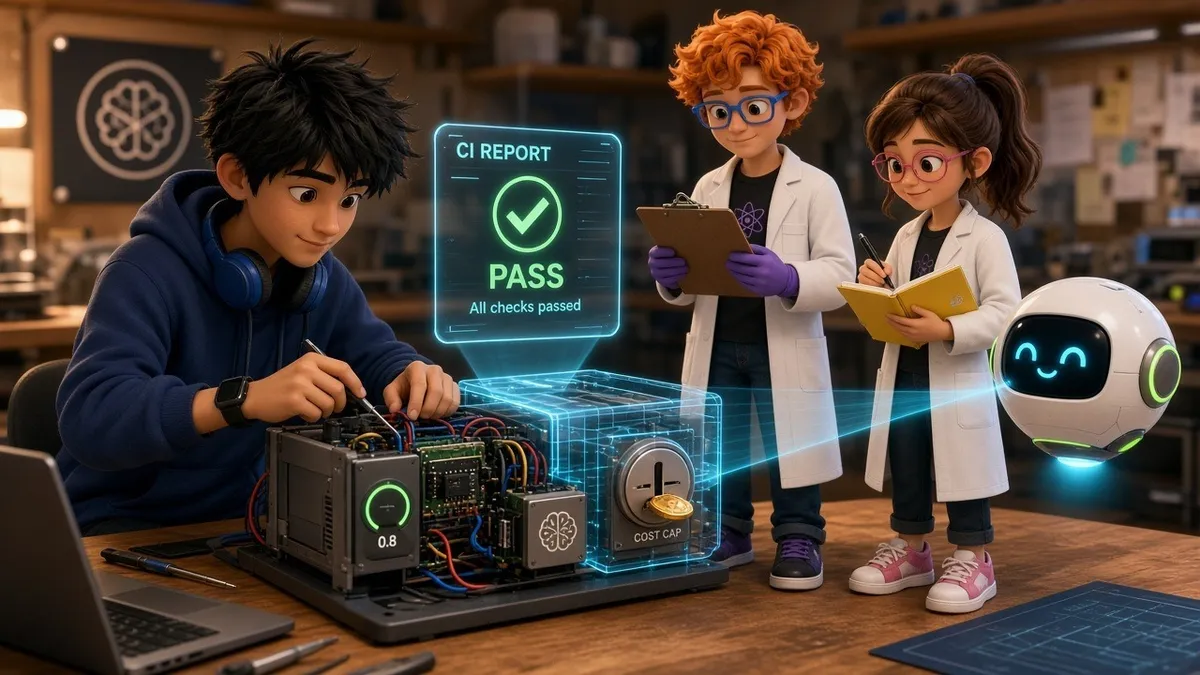
ارزش واقعی این ابزار برای تیمهای بزرگ در فلگهای CLI است که اجازه میدهد در محیط یکپارچهسازی مداوم (CI)، گیتهای خودکار (Automated Gating) قرار دهند. تیمها اکنون میتوانند اگر امتیاز پلاگین از حد مشخصی پایینتر رفت، بیلد (Build) را با خطا متوقف کنند.
پیکربندی CI و کدهای خروجی:
یک دستور پیشنهادی برای CI به این شکل است:claude plugin eval . --trust-plugin --json results.json --threshold 0.8 --model claude-sonnet-5 --judge-model claude-haiku-4-5 --no-publish --max-cost-usd 20
کدهای خروجی کلیدی برای گیتهای CI:
- ۰: تمام موارد از حد آستانه (
--threshold) عبور کردند. - ۱: یک مورد زیر آستانه بود، فایلها بارگذاری نشدند، یا فلگ
--trust-pluginبرای یک خروجی غیرمعتبر (Untrusted checkout) وجود نداشت. - ۲: اجرای ناقص به دلیل رسیدن به سقف هزینه
--max-cost-usdیا خطای احراز هویت؛ در این حالت فایل JSON همچنان با مقدارpartial: trueنوشته میشود.
توصیه میشود مدل (--model) و مدل داور (--judge-model) را ثابت (Pin) کنید تا بهروزرسانیهای ارائهدهنده با پسرفت (Regression) پلاگین اشتباه گرفته نشود. توسعهدهندگان همچنین میتوانند از --max-cost-usd برای سقفگذاری هزینهها و --no-publish برای محلی نگه داشتن گزارشها استفاده کنند. برای مهارتهای مبتنی بر پروتکل زمینه مدل (MCP)، ابزار از Mockها در مسیر evals/mocks/<server>/<tool>.md پشتیبانی میکند تا محیط CI نیازی به دسترسی به سرویسهای زنده تولید نداشته باشد.
استراتژی «کیت اختصاصی»
این ابزار بخشی از استراتژی گستردهتری به نام «مخازن کیت اختصاصی» (Owned Kit) است. بهجای تکیه بر محیطهای چت ایزوله، توسعهدهندگان مخزنی را نگه میدارند که شامل CLAUDE.md، پرامپتها و مهارتهایی است که همراه با محصول جابهجا میشوند.
سلسلهمراتب ارزیابی:
- قراردادهای مخزن: فایلهایی مثل
CLAUDE.mdیا.cursorrulesکه به عاملها کمک میکنند نقاط اتصال (Seams) پروژه را بیابند. در این راستا، استفاده از فایل CLAUDE.md برای کاهش توهمات در React Native نشان داده است که تعریف دقیق قوانین پروژه، دقت عامل را بهشدت افزایش میدهد. - پذیرش تغییرات: چکلیستهای عاملهای کدنویسی برای تایید اینکه آیا یک PR دقیقاً همان چیزی را که خواسته شده بود انجام داده است.
- مشارکت پلاگین: ابزار
claude plugin evalو محاسبه دلتا برای سنجش اینکه آیا یک مهارت امتیاز را نسبت به حالت بدون پلاگین افزایش داده است. - ویژگیهای AI محصول: یک حلقه ارزیابی LLM مجزا برای مدیریت مسیرهای مدل در سمت کاربر نهایی.
در این ساختار، ارزیابی پلاگین آخرین گیت پذیرش است. در حالی که فایل CLAUDE.md به عامل کمک میکند ساختار پروژه را بفهمد، مجموعه ارزیابی تضمین میکند هر مهارت اضافهشده، سهم اندازهگیریشدهای در توانمندی عامل دارد.
امنیت و اعتماد
اجرای claude plugin eval روی یک پلاگین، همان سطح اعتمادی را میطلبد که اجرای claude --plugin-dir دارد. فقط پلاگینهای مورد اعتماد را ارزیابی کنید. توجه داشته باشید که هوکها و سرورهای MCP واقعی که از طریق --allow-real-servers یا --mocks off فعال میشوند، خارج از محیط سندباکس عامل اجرا میشوند.
این تغییر، فرض بنیادی ابزارهای عاملمحور را عوض میکند. صنعت را از مقالاتی درباره مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن برای گرفتن بهترین جواب — به سمت یک چرخه مهندسی نرمافزار دقیق میبرد که در آن مهارتهای AI مانند داراییهای تولیدی (Production Assets) با بنچمارکهای الزامی مدیریت میشوند.
گام بعدی شما
- نسخه Claude Code خود را به ۲.۱.۲۶۹ بهروزرسانی کنید.
- با دستور
claude plugin eval init --bareاولین مورد تست خود را بسازید. - برای هر پلاگین، یک تست «بدون پلاگین» اجرا کنید تا ببینید آیا واقعاً به آن نیاز دارید یا خیر.
هدف این است که دیگر مهارتها را به این دلیل ادغام نکنید که «دمو خوب به نظر میرسید»، بلکه آنها را ادغام کنید چون مقدار دلتا (Δ) مثبت است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو