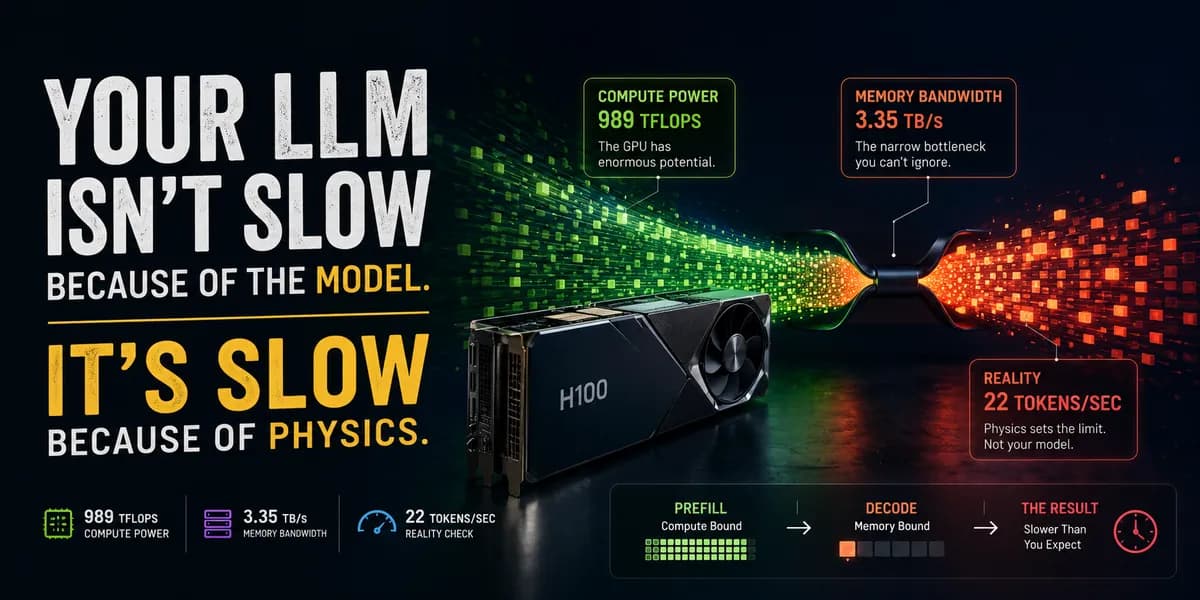
اگر امروز با تأخیر در پاسخهای مدلهای زبانی مواجه میشوید، مشکل احتمالاً قدرت تراشه نیست، بلکه یک سد فیزیکی به نام پهنای باند حافظه است. مطابق تحلیل فنی منتشر شده در ۱۲ ژوئیه ۲۰۲۶ در وبسایت dev.to، شکاف میان سرعت محاسبات GPU و سرعت انتقال دادهها، عامل اصلی تأخیر در استنتاج است.
این واقعیت سختافزاری، سقف توانمندی هر استقرار AI را تعیین میکند. در حالی که تمرکز ما اغلب بر لایهی نرمافزاری است، اما جابهجایی فیزیکی بایتها بین حافظه و واحدهای پردازشی است که تصمیم میگیرد کاربر یک پاسخ روان ببیند یا یک متن لکزن. با تکیه بر پوششهای قبلی ما در مورد اینکه چگونه تکنیکهای خاص پرامپتنویسی (مانند emotion-prompting) میتوانند تلاش مدل را هدایت کنند، اکنون مشخص است که توان سختافزار برای اجرای واقعی آن تلاش، جایی است که سقف واقعی وجود دارد.
برای درک این موضوع، یک آشپزخانه صنعتی را تصور کنید. شما میتوانید ۱۰ سرآشپز جهانی (قدرت محاسباتی) استخدام کنید، اما اگر مواد اولیه از انبار فقط یک دانه در هر بار (پهنای باند حافظه) ارسال شود، سرآشپزها بیشتر وقت خود را در حالت انتظار میگذرانند. به همین ترتیب، یک کامیون تحویل سریعتر هم خروجی را بهبود نمیبخشد اگر سرآشپز کافی برای پخت غذا نباشد. خروجی آشپزخانه توسط هر منبعی که زودتر به بنبست برسد — یعنی کامیون یا سرآشپز — محدود میشود.

چرا GPUها جایگزین CPU شدند؟
برای حل مشکل محدودیت حافظه، ابتدا باید تفاوت معماری CPU و GPU را بدانیم. یک واحد پردازش مرکزی (CPU) برای تطبیقپذیری کلی طراحی شده است. این واحد تعداد کمی هسته قدرتمند دارد که برای تأخیر کم بهینه شدهاند. به همین دلیل CPUها برای اجرای سیستمعاملها، پایگاههای داده، سرورهای وب و منطق برنامهها که در آنها هر دستور ممکن است با دستور قبلی متفاوت باشد، عالی هستند.
بار کاری AI بر اساس اصل متفاوتی عمل میکند. در طول استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه آشپزی واقعی و نه دورهی آموزش آشپز — عملیات ریاضی مشابه میلیونها یا حتی میلیاردها بار روی ماتریسهای بزرگ تکرار میشوند. به جای وظایف پیچیده و متنوع، سختافزار باید تعداد عظیمی از محاسبات ساده را بهطور همزمان انجام دهد. این نیاز اصلی برای AI مدرن است.
معماری واحد پردازش گرافیکی (GPU) این نیاز را با استفاده از هزاران واحد اجرایی کوچکتر به جای چند هسته قدرتمند پاسخ میدهد. این طراحی تعمداً عملکرد تکتک هستهها را فدای موازیسازی گسترده میکند. هدف این نیست که یک محاسبه سریعتر شود، بلکه هدف این است که بیشترین تعداد محاسبات مستقل در یک لحظه انجام شود. با درک این موازنه، مفاهیمی مثل وارپها (warps)، Tensor Cores و پهنای باند حافظه به اهرمهای اصلی عملکرد تبدیل میشوند.
دو تنگنای اصلی: محاسبات در برابر پهنای باند
طبق این گزارش، هر GPU دو منبع محدود دارد:
- محاسبات (Compute): این به شما میگوید که GPU با چه سرعتی میتواند عملیات ریاضی را انجام دهد.
- پهنای باند حافظه (Memory Bandwidth): این به شما میگوید که سختافزار با چه سرعتی میتواند دادهها را بین حافظه و واحدهای محاسباتی جابهجا کند.
یک مدل فقط به سرعت کندترین این دو منبع اجرا میشود. شتابدهندههای مدرن میتوانند حجم عظیمی از محاسبات را در ثانیه انجام دهند، اما این محاسبات تنها زمانی ممکن است که دادههای مورد نیاز به واحدهای اجرایی برسند. اگر GPU زمان بیشتری را منتظر داده بماند تا اینکه محاسبات انجام دهد، افزایش تعداد هستهها یا قدرت محاسباتی به تنهایی سرعت استنتاج را بیشتر نخواهد کرد. در همین راستا، بررسیهای اخیر نشان داده است که بهینهسازی پهنای باند حافظه میتواند علاوه بر سرعت، مصرف برق LLMها را نیز کاهش دهد.
درک شدت حسابی (Arithmetic Intensity)
مهندسان برای پیشبینی اینکه کدام منبع تبدیل به تنگنا میشود، از معیاری به نام «شدت حسابی» استفاده میکنند. این معیار دقیقاً اندازهگیری میکند که به ازای هر بایت دادهای که از حافظه جابهجا میشود، چه مقدار محاسبه انجام میگیرد.
- شدت حسابی بالا: GPU بیشتر وقت خود را صرف محاسبه میکند. بار کاری «محدود به محاسبات» (Compute-bound) است.
- شدت حسابی پایین: GPU بیشتر وقت خود را منتظر رسیدن دادهها میماند. بار کاری «محدود به حافظه» (Memory-bound) است.
این نسبت واحد پیشبینی میکند که کدام منبع پیش از شروع بهینهسازی یک بار کاری، به گلوگاه تبدیل خواهد شد. همین موضوع توضیح میدهد چرا مراحل مختلف استنتاج در مدل زبانی بزرگ، با وجود سختافزار یکسان، رفتارهای متفاوتی دارند.
شخصیت دوگانه استنتاج
استنتاج در مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — یک فرآیند یکنواخت نیست. اگرچه تولید پاسخ شبیه به یک فرآیند پیوسته به نظر میرسد، اما GPU در واقع دو نوع کار کاملاً متفاوت انجام میدهد: پیشپُرکردن (Prefill) و رمزگشایی (Decode). این مراحل بخشهای مختلفی از سختافزار را تحت فشار قرار میدهند.
۱. مرحله پیشپُرکردن (Prefill)
وقتی شما پرامپت را میفرستید، مدل تمام توکنها را بهطور همزمان پردازش میکند. این کار اجازه میدهد GPU عملیات ماتریسی عظیمی را بهصورت موازی اجرا کند.
- وضعیت سختافزار: هزاران هسته فعال هستند و Tensor Cores بهرهوری بسیار بالایی دارند.
- تنگنا: این یک بار کاری کلاسیک «محدود به محاسبات» است زیرا GPU بیشتر زمان را صرف انجام محاسبات میکند تا انتظار برای بارگذاری دادهها. برای درک عمیقتر این فرآیند، میتوان به مکانیسم ریاضیاتی Scaled Dot-Product Attention اشاره کرد که موتور محرک این محاسبات ماتریسی در مدلهای مدرن است.

۲. مرحله رمزگشایی (Decode)
پس از تولید اولین توکن، مدل وارد مرحله رمزگشایی میشود و توکنهای بعدی را یکییکی تولید میکند.
- وضعیت سختافزار: به جای پردازش موازی توالیها، GPU باید تکراراً وزنهای مدل و دادههای ذخیره شده در سیستم توجه را بارگذاری کند تا تنها یک توکن بعدی را پیشبینی کند.
- تنگنا: هر تکرار محاسبات نسبتاً کمی دارد اما جابهجایی دادههای زیادی میطلبد. این باعث میشود رمزگشایی یک بار کاری «محدود به حافظه» باشد.
به همین دلیل است که پردازش اولیه پرامپت اغلب بهطرز غافلگیرکنندهای سریع به نظر میرسد، اما تولید واقعی متن کند میشود، بهویژه در گفتگوهای طولانی. سختافزار یا مدل تغییر نکردهاند؛ بلکه نوع کار GPU تغییر کرده است. چالش دیگر سریعتر کردن محاسبات GPU نیست، بلکه یافتن راههایی برای کاهش یا پنهان کردن هزینه جابهجایی دادههاست.
مشکل KV Cache
علاوه بر وزنهای مدل، KV Cache (حافظه پنهان کلید-مقدار) مصرفکننده خاموش حافظه GPU است. اگر از اکثر مهندسان بپرسید چه چیزی حافظه را در طول استنتاج اشغال میکند، میگویند «وزنها»، اما KV cache نیمه دیگر داستان است. برای جلوگیری از محاسبه مجدد «توجه» (Attention) برای هر توکن قبلی در یک توالی، مدل تنسورهای کلیدی و مقاداری تولید شده در هر لایه ترنسفورمر را ذخیره میکند.

هر توکن جدید میتواند از این اطلاعات ذخیره شده استفاده کند و تولید خودبازگشتی (Autoregressive) را عملی کند. با این حال، این موضوع یک مالیات سختافزاری سنگین را تحمیل میکند:
- رشد: حافظه پنهان با تولید هر توکن جدید، بزرگتر میشود.
- مقیاس: یک گفتگوی کوتاه حافظه کمی میبرد، اما یک گفتگوی طولانی، یا صدها گفتگوی همزمان، میتواند سریعتر از آنچه اکثر مردم انتظار دارند، حافظه GPU را مصرف کند.
- ترافیک: پنجره زمینه (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد — هرچه بزرگتر شود، حافظه از بخشهای ابتدایی گفتگو بهتر عمل میکند، اما مقدار دادهای که باید در هر مرحله رمزگشایی خوانده شود افزایش مییابد. با رشد گفتگو، ترافیک حافظه نیز افزایش یافته و ماهیت «محدود به حافظه» این فرآیند را تقویت میکند.
مهندسی برای دور زدن قوانین فیزیک
از آنجا که تنگنا جابهجایی داده است، بهینهسازیهای سطح صنعتی به جای سریعتر کردن GPU، بر کاهش یا پنهان کردن این هزینه تمرکز میکنند. هدف این است که از پهنای باند موجود حافظه بهطور بهینهتری استفاده شود.
تکنیکهای بهرهوری حافظه
- دستهبندی (Batching): GPU به جای سرویسدهی به یک درخواست در هر بار، چندین درخواست را همزمان پردازش میکند. چون وزنهای مدل برای کل دسته مشترک است و دوباره استفاده میشوند، هزینه بارگذاری وزنها تقسیم شده و مقدار محاسبات مفید به ازای هر بایت فراخوانی شده از حافظه افزایش مییابد.
- کوانتش (Quantization): ذخیره وزنها با دقت پایینتر (مثل FP16، INT8 یا FP8) تعداد کل بایتهایی که باید از حافظه به واحدهای محاسباتی منتقل شوند را کاهش میدهد. در حالی که این کار اغلب به عنوان راهی برای کاهش محاسبات دیده میشود، بزرگترین مزیت آن در مرحله رمزگشایی، کاهش ترافیک حافظه است. این رویکرد در کنار روشهایی مانند هرس مدل (Pruning) قرار میگیرد، هرچند که هرس مدلها گاهی در مسیر استقرار در لبه (Edge) با چالشهای مهندسی متفاوتی روبروست.
- توجه برقآسا (FlashAttention): این تکنیک محاسبات را طوری بازسازی میکند که بخش بیشتری از کار در حافظه سریع رویتراشهای (On-chip) GPU بماند. با اجتناب از نیاز به نوشتن مکرر نتایج میانی توجه در حافظه اصلی GPU، ترافیک حافظه را بهطور قابل توجهی کاهش میدهد. ریاضیات دقیقاً یکسان میماند، اما جابهجایی بایتها به حداقل میرسد.
- PagedAttention: در فریمورکهایی مثل vLLM استفاده میشود و از ایدههای سیستمهای حافظه مجازی وام میگیرد. تخصیصهای سنتی حافظه ممکن است شکافهای استفاده نشدهای باقی بگذارند زیرا گفتگوها در زمانهای مختلف به پایان میرسند. PagedAttention حافظه KV Cache را در صفحاتی با اندازه ثابت تخصیص میدهد، تکهتکه شدن (Fragmentation) را کاهش داده و اجازه میدهد درخواستهای همزمان بیشتری روی سختافزار جای بگیرند.
- دستهبندی پیوسته (Continuous Batching): فریمورکهای مدرن این ابزارها را با دستهبندی پیوسته ترکیب میکنند که بهطور پویا درخواستهای ورودی را ادغام میکند (به جای انتظار برای پر شدن دستههای ثابت)، تا بهرهوری و توان عملیاتی GPU به حداکثر برسد.
موازنه مهندسی
این بهینهسازیها نحوه «تفکر» مدل یا هوش زیربنایی آن را تغییر نمیدهند و پارامترهای مدل را عوض نمیکنند. در عوض، آنها نرخ تغذیه داده به سختافزار را بهینه میکنند تا GPU بیکار نماند. اینها رویکردهای متفاوتی برای مدیریت یک منبع واحد هستند: حافظه GPU.
وقتی یک مهندس AI میپرسد چرا مدل کند است، سازندهترین سوال این نیست که مدل چقدر بزرگ است یا آیا تراشه «به اندازه کافی قدرتمند» است، بلکه این است: «سختافزار منتظر چیست؟»
آیا تراشه مشغول انجام محاسبات است یا در حالی که بایتها از گذرگاه حافظه عبور میکنند، بیکار نشسته است؟ با تغییر دیدگاه از «قدرت محاسباتی خام» به «جابهجایی داده»، تصمیمات عملیاتی از حالت جادویی خارج شده و به موازنههای مهندسی ساده تبدیل میشوند. هدف همیشه یکی است: به حداکثر رساندن کاربرد هر بایتی که از گذرگاه حافظه عبور میکند.
مدل ذهنی نهایی
درک داخلی GPUها — وارپها، Tensor Cores، حافظه مشترک، پهنای باند حافظه و کرنلهای CUDA — مفید است، اما نتیجه نهایی یک روش جدید برای تفکر درباره عملکرد است. وقتی یک بار کاری استنتاج «محدود به حافظه» توصیف میشود، این فقط یک اصطلاح فنی AI نیست، بلکه یک سرنخ خاص درباره وضعیت فیزیکی سختافزار است.
هرگاه استنتاج کند است، وسوسهبرانگیز است که مدل یا قدرت GPU را مقصر بدانیم. اما سوال واقعی این است که آیا GPU در حال انجام محاسبات است یا منتظر داده؟ این چرخش ساده در دیدگاه، تقریباً همه چیز را به هم متصل میکند: چرا پیشپُرکردن و رمزگشایی متفاوت هستند، چرا KV Cache حیاتی است و چرا تکنیکهایی مثل دستهبندی، کوانتش، PagedAttention و FlashAttention وجود دارند. همه اینها تلاشهایی برای استفاده بهتر از همان سختافزار هستند.
چه در حال تصمیمگیری در مورد سطح کوانتش باشید و چه در حال انتخاب یک فریمورک سرویسدهی، شما در حال مدیریت تنش بین محاسبات و پهنای باند هستید. وقتی این دیدگاه را بسازید، بهینهسازیها دیگر ترفندهای جداگانه به نظر نمیرسند، بلکه پاسخهای منطقی به محدودیتهای سختافزاری زیربنایی هستند. فریمورکهایی که استفاده میکنیم سادهتر میشوند، اما لایهی سختافزاری همچنان عامل تعیینکننده در عملکرد سرویسدهی LLM باقی میماند.
نتیجهگیری
هدف این تحلیل ساخت یک مدل ذهنی برای درک دلیل رفتار استنتاج مدلهای زبانی بود، نه آموزش برنامهنویسی CUDA. وقتی شروع کنید استنتاج را از دریچه محاسبات و پهنای باند حافظه ببینید، تکنیکهایی که در ابتدا راهحلهای نامرتبط به نظر میرسیدند، به هم متصل میشوند.
دستهبندی، کوانتش، مدیریت KV Cache، PagedAttention و FlashAttention ترفندهای عملکردی پراکنده نیستند؛ آنها پاسخهای مهندسی به محدودیتهای سختافزاری یکسانی هستند. دفعه بعد که با یک بار کاری استنتاج کند مواجه شدید، در برابر وسوسه مقصر دانستن فوری مدل یا GPU مقاومت کنید. در عوض، یک سوال سادهتر بپرسید: سختافزار منتظر چیست؟ در بیشتر مواقع، پاسخ به این سوال شما را به سمت گلوگاه واقعی هدایت میکند.
درک GPU به معنای تبدیل شدن به مهندس CUDA نیست. بلکه درک این است که چرا سیستمهای مدرن AI به این شکل رفتار میکنند. وقتی این دیدگاه را به دست آورید، بسیاری از بهینهسازیهای تولیدی دیگر جادویی نیستند، بلکه تصمیمات منطقی مهندسیاند.
گام بعدی شما
- اگر از vLLM استفاده نمیکنید، برای مدیریت بهینه KV Cache و افزایش توان عملیاتی، آن را در محیط تست بررسی کنید.
- میزان تأخیر (Latency) را در مراحل Prefill و Decode بهطور جداگانه اندازهگیری کنید تا گلوگاه واقعی سختافزار خود را بیابید.
- تاثیر کوانتش (Quantization) را نه فقط بر روی مصرف VRAM، بلکه بر روی سرعت تولید توکن (Tokens per second) در مدلهای خود بسنجید.
اما داستان سختافزاری این تحول در لایههای عمیقتر پیچیدهتر است — به تحلیل ما دربارهی معماری حافظههای HBM مراجعه کنید.



گفتگو