یک پرسوجوی SQL که از نظر فنی بینقص است، همچنان میتواند پاسخی فاجعهبار برای یک تصمیم تجاری تولید کند. این پارادوکس زمانی رخ میدهد که عاملهای هوش مصنوعی که دادههای سازمانی را استخراج میکنند، در تلههایی میافتند که یک تحلیلگر ارشد بهطور غریزی از آنها دوری میکند؛ مواردی مانند اشتباه گرفتن مجموع فاکتورها با درآمد شناساییشده یا استفاده از یک جدول منسوخ پس از یک عملیات مهاجرت داده (Migration).
این شکاف به این دلیل وجود دارد که اکثر سامانههای داده سازمانها بر «دانش مثبت» تمرکز دارند؛ یعنی چه جداولی وجود دارند و ستونها چه معنایی دارند. اما آنها «دانش منفی» را نادیده میگیرند: سوابق ماشینخوان از اشتباهاتی که سازمان پیش از این یاد گرفته است که نباید تکرار کند. این مسئله در واقع ریشه در شکاف معنایی موجود در طرحوارههای داده سازمانی دارد که مانع از درک درست مدلها از واقعیتهای تجاری میشود. طبق گزارشی که در ۲۵ اوت ۲۰۲۶ در وبسایت dev.to منتشر شد، نبود این لایه دلیل اصلی دشواریِ دستیابی به قابلیت اطمینان در مقیاس واقعی برای عاملهای هوش مصنوعی است.
برای دههها، پایگاههای داده برای انسانهایی طراحی شدند که بستر و زمینه (Context) گمشده را خودشان تأمین میکردند. یک مهندس باسابقه میداند که دو جدول خاص نباید مستقیماً به هم متصل شوند، حتی اگر شناسههای آنها یکسان باشد. اما وقتی عاملهای هوش مصنوعی (AI Agents) — شبیه دستیارهای دیجیتالی که میتوانند ابزارها را برای رسیدن به هدف به کار بگیرند — کنترل را به دست میگیرند، این دانش تجربی یا «دانش قبیلهای» (Tribal Knowledge) را ندارند و هر اتصال فنی ممکن را یک اتصال معتبر میپندارند.
شکست رویکرد «فقط زمینه» (Pure Context)
همانطور که در تحلیلهای پیشین ما دربارهی امنیت و همراستاسازی مدلهای زبانی اشاره کردیم، تکیه بر توصیفات متنی برای کنترل رفتار مدلها کافی نیست. بسیاری از تیمها سعی میکنند این مشکل را با دادن متادیتای بیشتر یا پرامپتهای طولانیتر به مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — حل کنند. اما مشکل، کمبود توصیف نیست؛ بلکه کمبود محدودیت است.
یک طرحواره (Schema) ممکن است ستونی به نام invoice_amount را نشان دهد و مدل بهدرستی از آن برای پاسخ به سؤال درآمد استفاده کند، بدون اینکه بداند سازمان قانونی دارد که میگوید invoice_amount درآمد شناساییشده محسوب نمیشود. برای درک بهتر، یک تعریف جدول استاندارد را در نظر بگیرید:CREATE TABLE invoice ( invoice_id BIGINT, customer_id BIGINT, invoice_amount DECIMAL(18,2), invoice_date DATE, status VARCHAR(20) );
یک هوش مصنوعی میتواند ارجاع مشتری، مبلغ و تاریخ را شناسایی کند. او میتواند SQL معتبری برای سؤال «درآمد شناساییشده در فصل گذشته چقدر بود؟» تولید کند. اما سازمان میداند که invoice_amount درآمد شناساییشده نیست. این یک حقیقت مربوط به طرحواره (Schema) نیست، بلکه یک دانش سازمانی است. بدون این دانش، عامل میتواند از نظر فنی متخصص باشد اما پاسخ اشتباه بدهد.
ماهیت دانش منفی
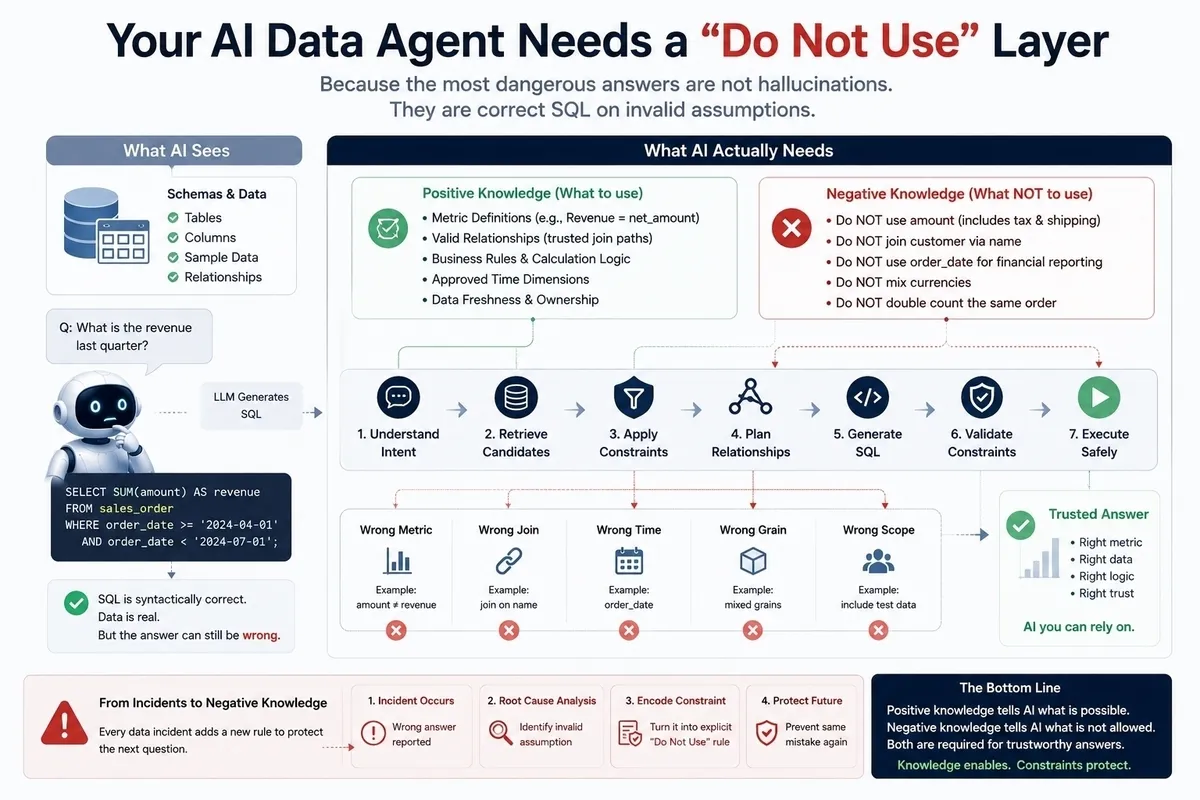
پلتفرمهای داده بهطور سنتی دانش مثبت را ثبت میکنند: چه جداولی وجود دارد، ستونها چه معنایی دارند، تعاریف معیارها چیست و موجودیتها چگونه به هم مرتبط هستند. اما کاربران خبره، مجموعهای موازی از دانش منفی را در ذهن دارند. این دانش شامل مواردی است مانند: دانستن اینکه کدام منبع گمراهکننده است، کدام اتصال (Join) خطرناک است، کدام فیلد درست به نظر میرسد اما نیست، و کدام برچسب زمانی (Timestamp) باید برای جلوگیری از شمارش مضاعف نادیده گرفته شود.
این دانش دقیقاً به این دلیل ارزشمند است که انتخاب اشتباه اغلب برای یک ماشین منطقی به نظر میرسد. بنابراین، یک عامل داده در محیط عملیاتی به هر دو نیاز دارد:
۱. دانش مثبت $ \rightarrow $ از چه چیزهایی میتوانم استفاده کنم؟
۲. دانش منفی $ \rightarrow $ از چه چیزهایی باید اجتناب کنم؟
پیادهسازی لایه «عدم استفاده» (Do Not Use)
برای حل این مشکل، سازمانها باید با دانش منفی بهعنوان یک دارایی دادهای درجهیک برخورد کنند. این کار مستلزم ایجاد محدودیتهای ساختاریافته است که به اشیاء داده متصل میشوند. این قوانین نباید یک لیست سیاه ساده باشند، بلکه باید زمینهمحور باشند؛ زیرا علامتگذاری یک فیلد بهعنوان «ممنوع» بیش از حد ابتدایی است، چرا که یک فیلد ممکن است برای یک قصد (Intent) معتبر اما برای قصدی دیگر نامعتبر باشد.
جزئیات و مثالهای محدودیتها
بر اساس بررسیهای فنی، این محدودیتها در سه سطح تعریف میشوند:
- محدودیتهای فیلد: ستونی مثل
invoice.invoice_amountممکن است برای تحلیل کلی فاکتورها (invoice_analysis) معتبر باشد، اما برای «درآمد شناساییشده» (recognized_revenue) صراحتاً نامعتبر باشد، زیرا مقدار آن ممکن است شامل مبالغی باشد که هنوز قوانین شناسایی درآمد را پاس نکردهاند. مالکیت این قانون بر عهده بخش مالی است. - محدودیتهای رابطه: اتصال مستقیم بین
customer.customer_idوorder.customer_idممکن است زمانی که ساختار حسابها تجمیعی (consolidated) است، ممنوع باشد. در چنین مواردی، مسیر مورد نیاز بایدcustomer$ \rightarrow $account$ \rightarrow $orderباشد تا از تکرار سفارشها در حسابهای فرزند جلوگیری شود. - محدودیتهای زمانی: برای گزارشهای مالی مربوط به درآمد شناساییشده، سیستم میتواند استفاده از
finance_revenue.recognition_dateرا اجباری و استفاده ازinvoice.invoice_dateیاsales_order.created_atرا صراحتاً ممنوع کند.
یک خط لوله (Pipeline) مقاوم
یکپارچهسازی این محدودیتها مستلزم انتقال آنها به مرحلهای پیش از LLM در خط لوله اجرا است. در یک مسیر ساده و ابتدایی، ترتیب به این شکل است: سؤال $ \rightarrow $ طرحواره $ \rightarrow $ مدل $ \rightarrow $ SQL. اما یک سیستم بالغ، چندین حفاظ (Guardrails) را اضافه میکند تا اطمینان حاصل شود که مدل در یک فضای دادهای شکلیافته عمل میکند. برای مثال، در ابزارهای پیشرفتهای مانند Claude Code، استفاده از لایههای حفاظتی برای مدیریت تغییرات دیتابیس به منظور جلوگیری از فجایع عملیاتی به کار گرفته میشود. در اینجا نیز ترتیب به این شکل است:
۱. تشخیص قصد تجاری: تعیین دقیق اینکه کاربر دقیقاً چه میخواهد (مثلاً «درآمد شناساییشده»).
۲. بازیابی کاندیدها: شناسایی تمام فیلدهای احتمالی مانند finance_revenue.recognized_amount ، invoice.invoice_amount ، sales_order.total_amount و payment.received_amount.
۳. فیلتر محدودیتها: حذف کاندیدهای نامعتبر پیش از آنکه به فضای تصمیمگیری مدل برسند. برای یک سؤال درباره درآمد شناساییشده، سیستم کاندیدها را با پایگاه دانش تطبیق میدهد. اگر تخلف سخت (Hard Violation) یافت شود (مثلاً invoice.invoice_amount)، آن فیلد حذف میشود. مدل مسئلهای پاکتر دریافت میکند، اما دلیل حذف برای عیبیابی (Debugging) ذخیره میشود.
۴. برنامهریزی روابط مورد اعتماد: اجبار عامل به استفاده از مسیرهای اتصال تأییدشده. بهجای اینکه از LLM بخواهیم توپولوژی اتصال را از روی نامها استنتاج کند، سیستم محدودیتها را بر گراف روابط اعمال میکند تا کوتاهترین مسیر مورد اعتماد را بیابد.
۵. ارائه زمینه مجاز: دادن تنها طرحواره و مسیرهای اعتبارسازیشده به مدل.
۶. استنتاج و تولید SQL: مدل پرسوجو را بر اساس بستر محدود شده تولید میکند.
۷. اعتبارسنجی پس از تولید: تجزیه و تحلیل SQL تولید شده (AST) برای اطمینان از اینکه هیچ منبع ممنوعهای استفاده نشده و فیلدهای زمانی مورد نیاز حضور دارند.
قوانین سخت در مقابل قوانین نرم
همه محدودیتها یکسان نیستند. سیستم باید بین قوانین سخت و نرم تفاوت قائل شود تا یا بیش از حد انعطافناپذیر نباشد یا بیش از حد اختیاری.
- محدودیتهای سخت (Hard Constraints): اینها غیرقابل مذاکرهاند. برای مثال، قانونی که میگوید
do_not_use: customer_legacyزمانی کهquery_date >= 2026-01-01است. تخلف از یک محدودیت سخت باید منجر به توقف اجرا یا بازتولید فوری پرسوجو شود. - راهنماییهای نرم (Soft Guidance): اینها ترجیحات هستند. برای مثال، قانونی برای
prefer: billing_regionبا یک جایگزینfallback: registered_region. تخلف از این قانون ممکن است رتبه نتیجه را کاهش دهد یا باعث بررسی انسانی شود، اما مانع اجرای پرسوجو نمیشود.
کامپایل حاکمیت در زمان اجرا (Runtime)
حاکمیت داده باید در کنترلهای زمان اجرا کامپایل شود. یک معیار حاکمیتی برای «درآمد شناساییشده» ممکن است منبع را finance_revenue.recognized_amount ، فیلد زمانی را finance_revenue.recognition_date و فیلترهای مورد نیاز را مانند status=recognized مشخص کند.
این تعریف به یک سیاست (Policy) تبدیل میشود که شامل required_source ، forbidden_sources (مانند invoice.invoice_amount) و required_filters است. این تعریف واحد حاکمیتی، بازیابی، ساخت بستر و اعتبارسنجی نهایی را هدایت میکند. در این حالت، دیگر به مدل اعتماد نمیشود که خودش مراقب باشد، بلکه سیستم او را هدایت میکند.
تبدیل شکستها به زیرساخت
بهترین منبع برای استخراج این قوانین، شکستهای تاریخی است. وقتی مشخص میشود یک داشبورد درآمدی به دلیل اتصال مستقیم سفارشها به مشتریان، اعداد را بیش از حد نشان میدهد، اکثر شرکتها داشبورد را اصلاح کرده و رها میکنند. اما یک سازمان با بلوغ بالا، علت ریشهای را ثبت کرده و آن را به یک محدودیت ساختاریافته تبدیل میکند:
شکست $ \rightarrow $ علت ریشهای $ \rightarrow $ قانون داده $ \rightarrow $ محدودیت ساختاریافته $ \rightarrow $ پیشگیری در آینده.
متخصصان نباید برای مستندسازی مصاحبه شوند، بلکه باید درباره اشتباهاتشان سؤال شود. پرسیدن این سؤال که «پنج اشتباهی که یک نیروی تازهوارد معمولاً با این دادهها مرتکب میشود چیست؟»، زیرساخت بسیار ارزشمندتری نسبت به توصیف ۵۰ ستون ایجاد میکند. آنها قوانین واقعی را ارائه میدهند: «از آن مبلغ بهعنوان درآمد استفاده نکن»، «بعد از مهاجرت از این جدول استفاده نکن» یا «قبل از حذف دادههای تکراری حسابها، آنها را SUM نکن».
نسخهبندی و مالکیت
از آنجا که قوانین تجاری تغییر میکنند، این محدودیتها باید دارای نسخه و مالک باشند. یک رکورد محدودیت باید شامل یک شناسه (مثلاً C-REV-014)، شماره نسخه، مالک (مثلاً بخش مالی)، وضعیت، تاریخ اجرا و دلیل قانون باشد. این امر تضمین میکند که سیستم بداند آیا یک قانون هنوز معتبر است یا توسط یک فرآیند تجاری جدید جایگزین شده است.
اندازهگیری موفقیت
برای اطمینان از عملکرد این لایه، سازمانها باید معیارهای خاصی را رصد کنند تا از مستندسازی ساده به سمت پیشگیری فعال حرکت کنند:
- پوشش محدودیتها: درصد معیارهای حیاتی که قوانین منفی صریح دارند.
- تخلفات پیشگیرانه: تعداد کاندیدهای نامعتبر که پیش از تولید SQL توسط مدل حذف شدهاند.
- نرخ تخلف SQL: درصد پرسوجوهایی که در مرحله اعتبارسنجی پس از تولید، با یک محدودیت شناختهشده برخورد کردند.
- تکرار اشتباهات شناختهشده: دفعاتی که یک حادثه مستند شده، پس از کدگذاری قانون مربوطه دوباره رخ داده است.
مرز استدلال
مهم است که هر قطعه از قضاوت انسانی را به یک قانون قطعی تبدیل نکنیم. برخی تصمیمات مبهم هستند یا استثنائات زیادی دارند. دانش منفی تنها زمانی باید کدگذاری شود که شناختهشده، تکرارشونده، پرتاثیر، مختص به کسبوکار و به اندازه کافی پایدار باشد تا بتوان بر اساس آن حاکمیت ایجاد کرد.
هدف، جایگزینی استدلال هوش مصنوعی با قوانین نیست، بلکه توقف استفاده از استدلال مدل برای اشتباهاتی است که سازمان پیش از این راه پیشگیری از آنها را میدانست.
اصل مهندسی بزرگتر
یک پاسخ غلط سازمانی همیشه توهم (Hallucination) نیست؛ بلکه اغلب یک محاسبه درست بر اساس یک فرض تجاری غلط است. یک اتصال (Join) بد میتواند بهطور کامل اجرا شود؛ یک معیار غلط میتواند بهدرستی جمع زده شود؛ یک جدول منسوخ میتواند ردیفهای واقعی برگرداند. به همین دلیل است که زمینه (Context) بهتنهایی کافی نیست و سیستم به مرز نیاز دارد.
ارزشمندترین دانش داده در سازمان، اغلب یک هشدار است: «از این فیلد برای آن معیار استفاده نکن». اگر این هشدارها در ذهن افراد بماند، هر عامل هوش مصنوعی اشتباهات قدیمی را تکرار خواهد کرد. اما اگر ساختاریافته و اجرایی شوند، به لایه «عدم استفاده» تبدیل میشوند؛ همان قطعه گمشده بین عاملی که فقط میتواند دادهها را بخواند و عاملی که میتواند بهطور قابلاعتماد از دادههای سازمانی استفاده کند.
گام بعدی شما
- فهرستی از ۵ اشتباه رایج تحلیلگران تازهوارد در سازمان خود تهیه کنید و آنها را به قوانین «عدم استفاده» تبدیل کنید.
- در خط لوله استنتاج خود، مرحله «فیلتر کاندیدها» را پیش از ارسال دادهها به مدل اضافه کنید.
- برای هر معیار حیاتی تجاری، یک مالک (Owner) مشخص کنید که مسئول بهروزرسانی محدودیتهای آن باشد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو