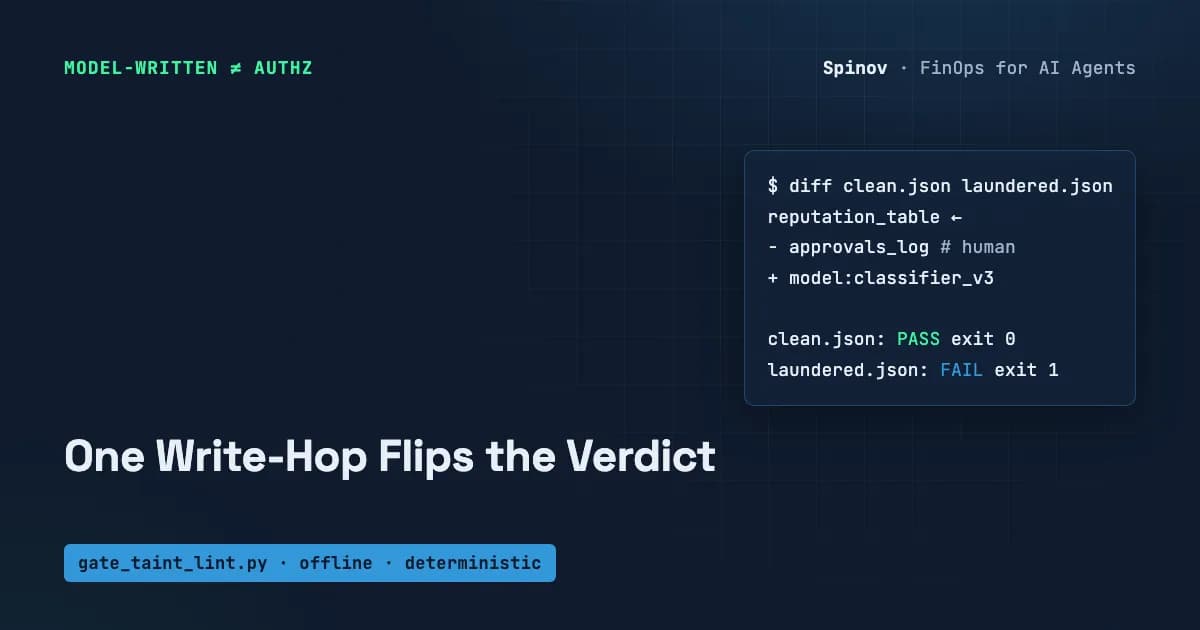
یک گام ساده در خط لوله داده (Data Pipeline) میتواند کلیدهای گیت امنیتی را به دست یک مدل هوش مصنوعی بسپارد. این آسیبپذیری ساختاری اجازه میدهد یک مدل بر روی سیگنالهایی که برای تأیید اقداماتش استفاده میشوند، اثر بگذارد و بهطور مؤثر حفاظهای «انسان در حلقه» (human-in-the-loop) را دور بزند، بدون اینکه حتی یک خط از کدهای سیاستگذاری (Policy Code) را تغییر دهد. زمانی که یک سیگنال نوشتهشده توسط مدل به عنوان یک ویژگی مجوزدهنده (Authorization Feature) به کار میرود، مدل در واقع کلید گیت را در دست دارد، فارغ از اینکه سیاستهای زیربنایی چقدر مستحکم باشند.
برای توسعهکنندگانی که عاملهای خودگردان (Autonomous Agents) را مستقر میکنند، خطر تنها تزریق پرامپت (Prompt Injection) نیست؛ بلکه مسئلهی بنیادین، «منشأ داده» (Provenance) است. اکثر گیتهای امنیتی بر سیگنالهایی — مانند امتیاز اعتبار (Reputation Score) — تکیه میکنند و فرض میکنند این دادهها «تثبیتشده در جهان» (World-Anchored) هستند؛ یعنی منشأ آنها یک انسان یا یک سامانه خارجی مورد اعتماد است. اما اگر خودِ مدل همان موجودیتی باشد که جدولی را پر میکند که آن امتیاز را محاسبه میکند، گیت امنیتی تنها یک توهم است. نام یک سیگنال هیچچیز دربارهی نویسندهی آن به شما نمیگوید؛ برای مثال، sender_trust ممکن است تثبیتشده در جهان به نظر برسد، اما تنها بررسی «زنجیرهی نوشتن» (Write-Chain) است که فاش میکند آیا مدل، جدولی را که داده از آن میآید، پر کرده است یا خیر.
در راستای نیاز به بهداشت سختگیرانه ورودیها، ابزار جدیدی مبتنی بر پایتون به نام gate_taint_lint.py توسعه یافته است. این ابزار به تیمها اجازه میدهد «بستار نوشتن تعدی» (Transitive Write-Closure) هر سیگنالی را که گیت یک عامل بر اساس آن تصمیم میگیرد، محاسبه کنند. این ابزار تعیین میکند که آیا یک سیگنال واقعاً مستقل است یا از طریق ذخیرهسازهای واسطه «پولشویی» (Laundered) شده است تا نویسندگی مدل پنهان بماند. این ابزار روشی قطعی (Deterministic) را برای پاسخ به یک سؤال حیاتی ارائه میدهد: پیش از آنکه گیت هر چیزی را تأیید کند، آیا مدل در هر یک از ذخیرهسازهای پشت سیگنالهای مجوزدهنده، چیزی نوشته است یا خیر؟
مکانیسمهای پولشویی سیگنال (Signal Laundering)
این ابزار بر اساس یک مانیفست JSON عمل میکند که دو مورد را تعریف میکند: یک نقشهی نوشتن از تمام ذخیرهسازها (stores) و فهرستی از ویژگیهای گیت با نقشهای تعیینشده (gate_features). تز اصلی این است که یک ویژگی تنها زمانی میتواند نقش «مجوزدهنده» (Authorization) داشته باشد که بستار نوشتن تعدی آن شامل هیچ «اصیل مدل» (Model Principal) نباشد. سیگنالهای نوشتهشده توسط مدل میتوانند به عنوان «زمینه» (Context) عمل کنند، اما هرگز نباید به عنوان مجوز به کار روند.
یک ساختار معمولی «جدول اعتبار» را در نظر بگیرید. یک گیت، امتیاز sender_trust را میخواند تا تصمیم بگیرد آیا عملیاتی باید بهطور خودکار اجرا شود یا خیر. تیم توسعه تصور میکند این روند امن است زیرا زنجیرهی نوشتن خطی به این صورت است: sender_trust از reputation_table میخواند، که خود از approvals_log پر شده است و در نهایت توسط یک انسان (human:sre_approver) امضا شده است. این یک سیگنال WORLD_ANCHORED (تثبیتشده در جهان) است.
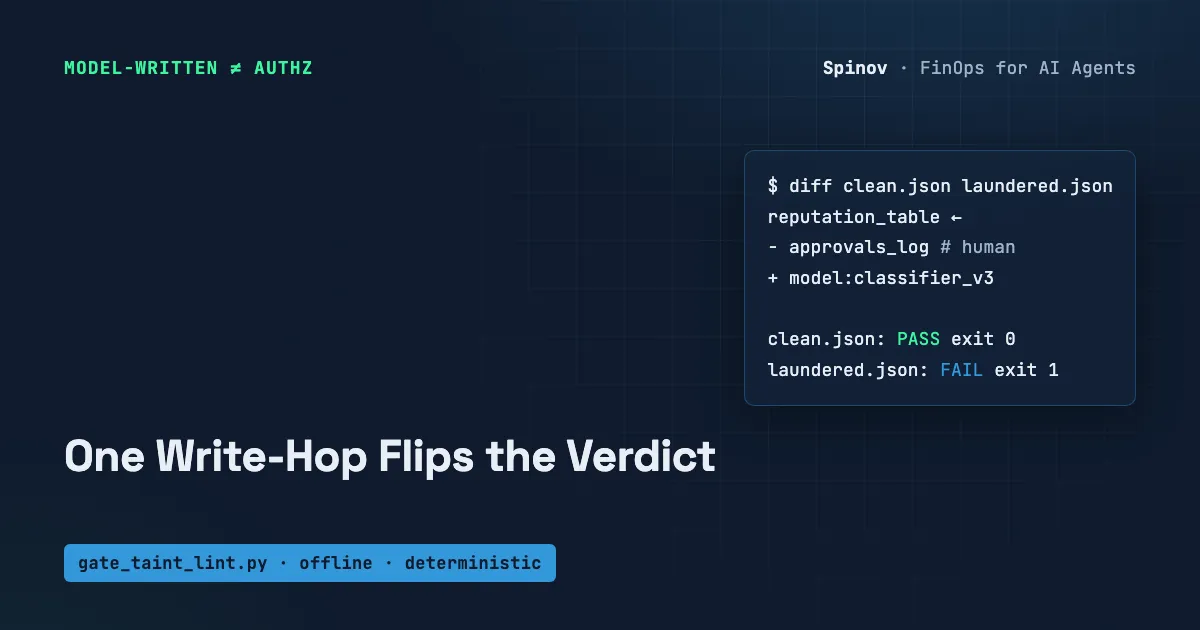
با این حال، یک تغییر ظریف در خط لوله — مثلاً قابلیتی برای «تأیید خودکار فرستندگانی با اعتماد بالا» که در سهماههی اول سال (Q1) عرضه شده — ممکن است نویسندهی reputation_table را به یک طبقهبند مدل (مانند model:classifier_v3) تغییر دهد. در لحظهی خواندن، سیگنال sender_trust همچنان مانند عددی بین ۰ و ۱ به نظر میرسد. برای یک بررسی ساده که تنها نویسندهی مستقیم را میبیند، باز هم به نظر میرسد داده از یک جدول میآید، نه از یک مدل. این استخراج داده، نویسندگی را «پولشویی» میکند یا به عبارتی، منشأ مدل را میپوشاند.
ابزار gate_taint_lint.py این پولشویی را با ردیابی زنجیره تا پایینترین سطح (اصیلهای برگ) افشا میکند و سیگنالها را به سه دسته تقسیم میکند:
- WORLD_ANCHORED: تنها اصیلهای
human:*یاexternal:*در بستار نوشتن وجود دارند. - MODEL_AUTHORED: یک اصیل
model:*مستقیماً در ذخیرهساز خواندهشده مینویسد. - MODEL_LAUNDERED: یک اصیل
model:*در بستار نوشتن، در پشت یک یا چند ذخیرهساز واسطه قرار دارد (همان ترفند جدول اعتبار).
طبقهبندی آلودگی و منطق عملیاتی
این ابزار مانیفست را با استفاده از یک جستوجوی اول-عمق (DFS) تکرارشونده و یک مجموعهی «بازدید شده» (Visited Set) برای جمعآوری اصیلهای برگ پردازش میکند. منطق طبقهبندی از قوانین سختگیرانه زیر پیروی میکند:
- بررسی نویسندهی مستقیم: اگر یک اصیل
model:*در میان نویسندگان مستقیم ذخیرهساز خواندهشده باشد، علامتMODEL_AUTHOREDمیخورد. - بررسی بستار (Closure): اگر هیچ مدلی نویسندهی مستقیم نباشد، اما یک اصیل
model:*در هر جای عمیقتر از بستار نوشتن تعدی ظاهر شود، علامتMODEL_LAUNDEREDمیخورد. - پیشفرض: اگر بستار شامل هیچ اصیل مدل نباشد، سیگنال
WORLD_ANCHOREDاست.
برای اطمینان از اینکه خروجی بهصورت بایت-به-بایت قطعی (Deterministic) باشد، ابزار از جستوجوی اول-عرض (BFS) با گسترش مرتبشده (Sorted Expansion) برای یافتن کوتاهترین مسیر نوشتن از ذخیرهساز خواندهشده به یک اصیل مدل استفاده میکند. این کار از «لرزش» (Wobbling) گزارش در اجراهای مختلف جلوگیری میکند. این یک نمایش ظاهری نیست، بلکه پیشنیازی برای ابزاری است که قصد دارد به عنوان یک گیت در CI (یکپارچهسازی مداوم) اجرا شود.
شناسایی حلقههای بازخورد (Feedback Loops)
این ابزار همچنین خطرناکترین الگوی معماری یعنی FEEDBACK_LOOP را علامتگذاری میکند. این اتفاق زمانی رخ میدهد که گراف نوشتنِ قابل دسترس از یک ویژگی، حاوی چرخهای باشد که مدل آن را تغذیه میکند (یعنی سیگنال به مدل کمک میکند تا تاریخچه خودش را بنویسد).
همانطور که توسط کاربر anp2network در جامعهی توسعهدهندگان توصیف شده، این وضعیت زمانی رخ میدهد که «سوابق فرستنده بهبود یابد چون پیامهای قبلی توسط همین طبقهبند پذیرفته شدهاند». در این سناریو، مدل پیش از این در زنجیره منشأ حضور دارد. چنین حلقهای نه تنها سیگنال را آلوده میکند، بلکه اثر آن را تشدید (Compound) میکند. هر پذیرشی که مدل «میخرد»، پذیرش بعدی را ارزانتر میکند و بهطور مؤثر به مدل اجازه میدهد مرزهای اعتماد خودش را تغییر دهد.
در یک اجرای تست شبیهسازی شده، مانیفستی که حاوی حلقهای بود که در آن classifier_decisions و reputation_table به یکدیگر مینوشتند، منجر به حکم FAIL شد. زنجیره در این شبیهسازی به این صورت بود: sender_trust $
ightarrow$ reputation_table $
ightarrow$ classifier_decisions $
ightarrow$ model:classifier_v3. ابزار بهطور خاص چرخهی تغذیه شده توسط مدل در گراف نوشتن را شناسایی کرد: classifier_decisions, reputation_table.
مهندسی برای امنیت «شکست در حالت بسته» (Fail-Closed)
این ابزار که با پایتون ۳.۱۳.۵ و تنها با استفاده از کتابخانههای استاندارد (json, sys) توسعه یافته، بهگونهای طراحی شده که آفلاین، بدون نیاز به کلید و فقط-خواندنی (Read-only) باشد. این ابزار از فلسفهی سختگیرانهی «شکست در حالت بسته» پیروی میکند تا از نادیده گرفته شدن خطاهای پیکربندی در خط لولههای CI/CD جلوگیری کند. ابزار از کدهای خروج (Exit Codes) خاصی برای تفکیک شکستهای امنیتی از خطاهای فنی استفاده میکند:
خروج ۰ (PASS): هیچ ویژگی مجوزی در بستار نوشتن خود مدل را ندارد.
خروج ۱ (FAIL): یک یا چند ویژگی مجوزی، توسط مدل نوشته شده یا پولشویی شدهاند.
خروج ۲ (ERROR): ورودی نامعتبر، مانند فایل گمشده، JSON بدشکل، ذخیرهساز اعلامنشده، نقش ناشناخته، نوع اصیل ناشناخته یا ذخیرهساز بدون نویسنده.
دو تصمیم طراحی خاص، این پایداری را تضمین میکنند:
۱. منشأ اعلامنشده: ذخیرهسازی که لیست written_by آن خالی باشد، خروج ۲ را بازمیگرداند. علامتگذاری چنین ذخیرهسازی به عنوان «امن»، اجازه میدهد منشأهای اعلامنشده بهطور باز (Fail-open) عبور کنند، که دقیقاً روش پولشویی در استکهای تولیدی واقعی است. لیست خالی نویسندگان یعنی ذخیرهساز World-anchored نیست.
۲. حفاظت در برابر غلطهای تایپی: اگر یک اصیل بهجای model: به صورت modle:classifier_v3 تایپ شود، ابزار خروج ۲ را بازمیگرداند. یک ابزار منعطف ممکن بود این غلط تایپی را به عنوان WORLD_ANCHORED رد کند؛ اما رویکرد fail-closed تضمین میکند که یک غلط تایپی باعث شکست build شود، نه شکست مدل اعتماد.
تغییرات گستردهتر در صنعت
این رویکرد با تحقیقات اخیر دانشگاهی و صنعتی در زمینهی امنیت عاملهای هوش مصنوعی همسو است. مقالهای توسط Krti Tallam دربارهی انتشار مجوزها در سیستمهای هوش مصنوعی چندعاملی استدلال میکند که این مشکل به تزریق پرامپت قابل تقلیل نیست و نمیتوان آن را بهطور کامل با مدلهای کنترل دسترسی کلاسیک مانند RBAC (کنترل دسترسی مبتنی بر نقش)، ABAC (کنترل دسترسی مبتنی بر ویژگی) یا ReBAC (کنترل دسترسی مبتنی بر رابطه) حل کرد.
به همین ترتیب، گزارشی در ژوئن ۲۰۲۶ از Adversa AI تأکید میکند که هر ورودی که یک عامل میبلعد — از جمله سیگنالهای گیت — باید به عنوان ورودی بالقوه خصمانه تلقی شود و توصیه میکند که فاصله با مرزهای واقعی مانند محدودههای «حداقل امتیاز» (Least-privilege scopes) و اجرای محیطهای ایزوله (Sandboxed execution) پر شود. یک ویژگی گیت دقیقاً همان ورودیای است که گیت میبلعد.
همانطور که تحلیلگرانی مانند yongrean و jugeni در جامعهی Dev.to اشاره کردند، هدف برای یک عامل خودکار، یافتن یک «تأییدکننده» (Corroborator) است که مدل نتواند آن را بنویسد، نه یک امتیاز اطمینان که مدل بتواند آن را تغییر دهد. این یک دستورالعمل در زمان خواندن است، اما به یک ویژگی در زمان نوشتن بستگی دارد. همانطور که nexus-lab-zen مشاهده کرد، حکم یک اجرا باید در دامنه اعتمادی متفاوت از دامنهای باشد که لاگ را نوشته است.
محدوده و محدودیتها
درک اینکه این ابزار چه هست و چه نیست، بسیار مهم است. این linter اجرای زمان-واقعی (Runtime Enforcement) را انجام نمیدهد، نوشتنها را رهگیری نمیکند و تزریق پرامپت را شناس نمیکند. این یک ردیاب نسب (Lineage Tracker) نیست و ردیفهای واقعی داده یا جریانهای سطح ستون را نمونهبرداری نمیکند.
در عوض، این ابزار به عنوان یک بررسی پیش از استقرار عمل میکند، درست مانند یک SBOM (صورتحساب مواد نرمافزاری). این ابزار «نقشهی اعلامشده» را بررسی میکند، نه «قلمرو» واقعی را. اگر مانیفستی ادعا کند که یک ذخیرهساز توسط انسان امضا شده است اما یک کرونجاب (Cron job) مخفی به مدل اجازه دهد دادهها را به آن اضافه کند، ابزار زنجیره را پاک گزارش میدهد. یک اجرای «سبز» به این معنی است که نقشهای که شما رسم کردهاید مدل در پشت مجوزها ندارد، اما ثابت نمیکند که مسیرهای نوشتن اعلامنشده بهطور مطلق وجود ندارند.
اگر در حال حاضر برای عاملهای هوش مصنوعی خود به «امتیاز اعتماد» یا «سنجش اعتبار» تکیه میکنید، باید نقشهی نسب دادههای خود را استخراج کنید — خواه یک گراف dbt باشد، یک نقشهی Topic در CDC یا دسترسیهای IAM — و تأیید کنید که کدام سیگنالها واقعاً تثبیتشده در جهان هستند. محتملترین اکتشاف شما، رشتهای پنهان از نوشتنهای مدل خواهد بود که ماههاست دسترسی مدل را بهطور آرام پولشویی میکنند.
تحلیل اجراهای تست (Fixture Runs)
برای اثبات اثربخشی ابزار، آن با سه مانیفست خاص در پایتون ۳.۱۳.۵ تست شد. هر اجرا دو بار هش شد تا قطعی بودن بایت-به-بایت تأیید شود (مثلاً پاک: bb8d9b35...، پولشوییشده: bec4a071... و بازخورد: 68065873...).
- تست پاک (Clean Fixture): این مانیفست معماری مورد نظر را نشان میدهد. شامل ۵ ذخیرهساز و ۳ ویژگی گیت (۲ مجوز، ۱ زمینه) است. سیگنالهای
sender_trustوtx_reversibilityتثبیتشده در جهان (WORLD_ANCHORED) هستند. سیگنالmodel_confidenceتوسط مدل نوشته شده (MODEL_AUTHORED) اما به عنوان زمینه (Context) نگه داشته شده که ابزار آن را به عنوان INFO علامت میزند. نتیجه خروج ۰ است. - تست پولشوییشده (Laundered Fixture): از نظر بایتی دقیقاً مشابه تست پاک است، جز در یک خط:
reputation_tableاکنون توسطmodel:classifier_v3نوشته میشود بهجایapprovals_log. ابزار سیگنالsender_trustرا به عنوان MODEL_LAUNDERED علامت میزند و اشاره میکند که از طریق ۱ ذخیرهساز واسطه آلوده شده است. حکم به خروج ۱ تغییر میکند (۱ از ۲ ویژگی مجوز آلوده است). رسید چاپ شده به این صورت است:chain=sender_trust<-reputation_table<-model:classifier_v3. - تست بازخورد (Feedback Fixture): این تست چرخهای را اضافه میکند که در آن
classifier_decisionsوreputation_tableبه یکدیگر مینویسند. ابزار چرخه را شناسایی کرده و سیگنالsender_trustرا با هشدار [FEEDBACK_LOOP] علامت میزند. حکم خروج ۱ است و مسیر را ردیابی میکند:sender_trust$
ightarrow$reputation_table$
ightarrow$classifier_decisions$
ightarrow$model:classifier_v3.
جزئیات پیادهسازی
منطق ابزار برای حداکثر شفافیت و حداقل وابستگی طراحی شده است. مکانیسمهای زیر قابلیت اطمینان ابزار را تضمین میکنند:
- انواع اصیل (Principal Kinds): ابزار تنها سه پیشوند معتبر را میشناسد:
external:،human:وmodel:. اعتبارسنج مانیفست هر نوع ناشناختهای را رد میکند. - محاسبه بستار: از یک رویکرد مبتنی بر پشته (Stack-based) برای یافتن هر گره قابل دسترس از یک ذخیرهساز در امتداد لبههای
written_byاستفاده میکند تا اطمینان شود تمام اصیلهای برگ جمعآوری شدهاند. این یک محاسبه قطعی از بستار نوشتن تعدی است. - یافتن کوتاهترین مسیر: برای ارائه یک «رسید» برای حکم DENY، از جستوجوی اول-عرض (BFS) برای چاپ مستقیمترین مسیر به اصیل مدل استفاده میکند. از تابع
sorted()برای گسترش گرهها استفاده میکند تا خروجی هرگز بین اجراها تغییر نکند. - اعتبارسنجی ورودی: ابزار اجبار میکند که تمام ویژگیها ذخیرهسازهای اعلامشده را بخوانند و تمام ذخیرهسازها حداقل یک نویسنده اعلامشده داشته باشند. نام ذخیرهساز نمیتواند شامل
:باشد، زیرا این کار برای اصیلها رزرو شده است. - اجرای نقشها: فیلد
roleرا بهطور سختگیرانه به عنوانauthorizationیاcontextاعتبارسنجی میکند تا هیچ نقش ناشناختهای نتواند از بررسی آلودگی عبور کند.



گفتگو