درون بحران پردازشی git.kernel.org؛ رندر HTML بهجای کلون مخازن
عاملهای جمعآوری داده (Scrapers) با رندر کردن صفحات HTML بهجای کلون کردن مخازن، ۲۰٪ از توان پردازشی سرورهای git.kernel.org را اشغال کردهاند. تیم لینوکس گزارش میدهد که این…
دستهبندی
تحلیلهای عمیق مدلها، مقالات و بنچمارکها — پیشچاپها، ارزیابیها، مدلهای زبانی پیشرو و پژوهش همراستاسازی.
۵٬۷۶۹ مقاله منتشر شده

عاملهای جمعآوری داده (Scrapers) با رندر کردن صفحات HTML بهجای کلون کردن مخازن، ۲۰٪ از توان پردازشی سرورهای git.kernel.org را اشغال کردهاند. تیم لینوکس گزارش میدهد که این…

گوگل با معرفی متد SKILL.state، تاریخچه کامل گفتگوها را با نمایشهای ساختاریافته جایگزین کرد. این رویکرد مصرف توکن را در جلسات طولانی تا ۹۴٪ کاهش میدهد بدون آنکه دقت مدل را به خطر…

تحلیل قیمتگذاری مدل GPT-5.6 Luna در پلتفرم مایکروسافت فاندری نشان میدهد که ترکیب ظرفیت رزرو شده (PTU) با مدل پرداخت بهازای مصرف (Pay-as-you-go)، هزینههای عملیاتی سالانه را…

قابلیت Codex Skills با جایگزینی دستورالعملهای دائمی با معماری بارگذاری پیشرونده، از «تورم زمینه» جلوگیری میکند. این روش باعث میشود عاملهای هوش مصنوعی تنها در زمان نیاز به…

عاملهای هوش مصنوعی در درک «چرایی» وجود کدهای قدیمی ناتواناند و اغلب با حذف قطعات حیاتی، باعث سقوط سیستمها میشوند. رویکرد جدیدی بر پایه «گراف مهندسی» پیشنهاد شده تا با اتصال…

ایالات متحده با تدوین نامهای رسمی، فشار بر کشورهای جهان را برای انتخاب بین استانداردهای هوش مصنوعی آمریکا یا چین افزایش داده است. این اقدام در پاسخ به تشکیل ائتلاف رقیب در…

یک گردشکار جدید برای مستندات فنی با استفاده از بودجههای توکن و «دروازه ادغام»، از انباشت متون تولیدشده توسط AI بدون صاحب جلوگیری میکند. این سیستم با الزام تعیین یک مالک انسانی…

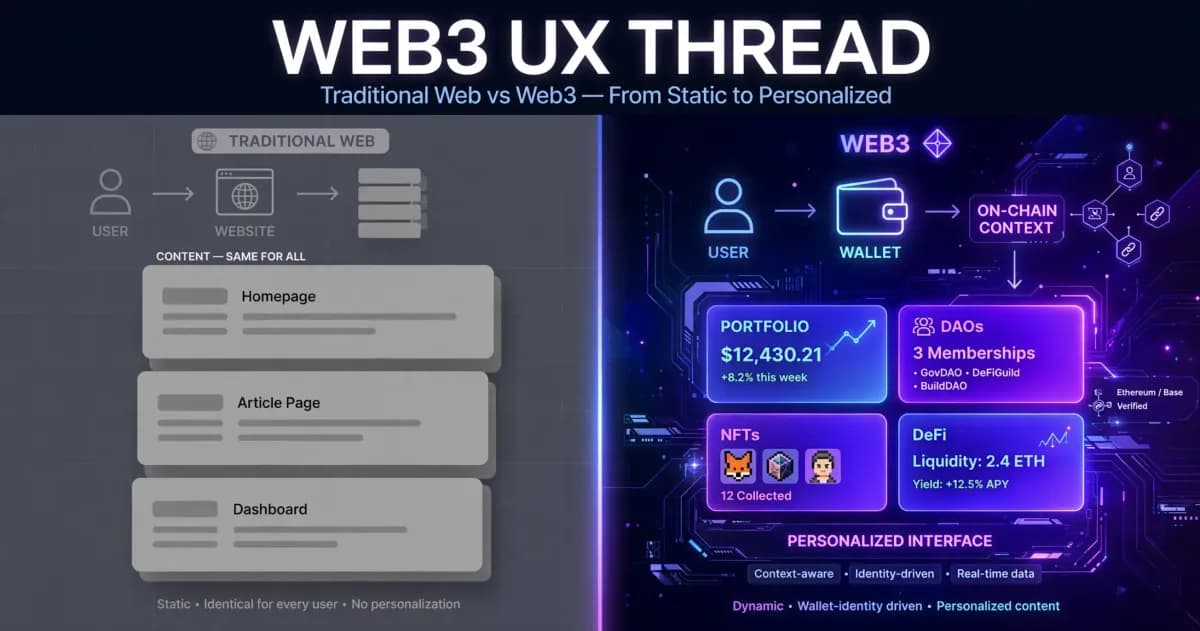
طراحی رابطهای کاربری در عصر هوش مصنوعی از تولید کامل وبسایتها به سمت استفاده از تاریخچه و داراییهای کیفپولهای Web3 برای نمایش مؤلفههای متناسب با هر کاربر تغییر میکند. این…

پلتفرم MonkeyCode با ارائه سرور و دسترسی رایگان به مدلها، امکان مقایسه دقیق ردپای اجرای عاملها را فراهم کرده است. این ابزار به توسعهدهندگان اجازه میدهد بدون هزینه برای…

پژوهشی در پروژه Automation Sandbox نشان میدهد وقتی یک المان UI حذف میشود، مدلهای زبانی بزرگ بهطور دستهجمعی روی جایگزین اشتباه توافق میکنند. این یافته ثابت میکند که اجماع…

مطالعهای جدید نشان میدهد دستیارهای کدنویسی پیشرفته قادر به پیشبینی زمان اجرای وظایف یا ارزیابی دقیق کیفیت خروجی خود نیستند. این فقدان آگاهی زمانی، نظارت بر عاملهای خودمختار در…

معیارهای داخلی GPTHuman تنها الگوهای نوشتاری انسانی و خوانایی را میسنجند و قادر به تأیید حقایق یا ارجاعات نیستند. برای حل این مشکل، یک چارچوب تست قطعی (Deterministic) معرفی شده…