پرش به محتوای اصلی

دسته‌بندی

تحلیل و بررسی تخصصی

تحلیل‌های عمیق مدل‌ها، مقالات و بنچمارک‌ها — پیش‌چاپ‌ها، ارزیابی‌ها، مدل‌های زبانی پیشرو و پژوهش همراستاسازی.

۵٬۸۲۰ مقاله منتشر شده

آیا یک دانشمند کامپیوتر می‌تواند مغز بسازد؟

مختصات سلسله‌مراتبی؛ راهکار زیست‌شناسی برای رفع شکاف اطلاعاتی ژنوم

تحلیلی فنی نشان می‌دهد سیم‌کشی مغز انسان پیچیده‌تر از آن است که در ژنوم ذخیره شود. زیست‌شناسی برای ساخت شبکه‌های عصبی عظیم از یک سیستم مقیاس‌پذیر از مختصات سلسله‌مراتبی و قوانین…

۳۵ دقیقه خواندن۲
ویژگی‌های پرت و چرا کوانتیزاسیون LLM بدون مدیریت آن‌ها از کار می‌افتد
آموزش کاربردی

«مدیریت مقادیر حدی»؛ کلید جلوگیری از فروپاشی مدل‌های زبانی فشرده

مدل‌های زبانی بزرگ در مقیاس‌های بالا «ویژگی‌های پرت» ایجاد می‌کنند که دقت کوانتش ۸ بیتی را به‌طور کامل تخریب می‌کند. مدیریت این مقادیر حدی، مرز میان یک مدل فشرده‌ی کاربردی و مدلی…

۵ دقیقه خواندن۱
خطای کمبود حافظه در مرحله کوانتیزاسیون، نه استنتاج
آموزش کاربردی

درون فرآیند کوانتش؛ تضاد میان وزن‌های دقت‌بالا و بهینه‌سازی حافظه

فرآیند کوانتش مدل‌ها به‌دلیل نیاز به وزن‌های دقت‌بالا و محاسبات آماری، حافظه بسیار بیشتری نسبت به استنتاج مصرف می‌کند. شناخت تفاوت‌های حافظه‌ای در متدهای GPTQ، AWQ و GGUF برای…

۵ دقیقه خواندن۲
کوانتایز کردن مدل تعبیه: چه کیفیتی واقعاً از دست می‌دهید
آموزش کاربردی

آیا می‌توان حافظهٔ ایندکس‌های برداری را بدون افت کیفیت کاهش داد؟

استفاده از کوانتش باینری می‌تواند فضای ذخیره‌سازی ایندکس‌های برداری را تا ۳۲ برابر کاهش دهد و ۹۶٪ از کیفیت بازیابی را حفظ کند. موفقیت این روش به شدت به پیاده‌سازی صحیح…

۵ دقیقه خواندن۱
قرنطینه کردن تست ناپایدار LLM بدون حذف آن
آموزش کاربردی

قرنطینه در برابر حذف؛ استراتژی مدیریت تست‌های ناپایدار در LLM

حذف تست‌های ناپایدار در خطوط لوله هوش مصنوعی باعث از دست رفتن دانش سیستمی می‌شود. استراتژی «قرنطینه» اجازه می‌دهد تست‌ها بدون مسدود کردن ادغام کدها اجرا شوند تا رگرسیون‌ها همچنان…

۶ دقیقه خواندن۲
بهینه‌سازی ۲۳۲ برابری هسته GPU با Codex در مسئله qr_v2: از تحقیق خودکار تا اجرا
آموزش کاربردی

بهینه‌سازی هسته‌های GPU با Codex؛ دستیابی به سرعت ۲۳۲ برابر در محاسبات QR

یک توسعه‌دهنده با استفاده از مدل Codex و یک چرخه پژوهشی خودکار، سرعت اجرای هسته‌های تجزیه QR را ۲۳۲ برابر نسبت به خط‌مبنای PyTorch افزایش داد. این دستاورد نشان می‌دهد که تبدیل…

۲۴ دقیقه خواندن۲
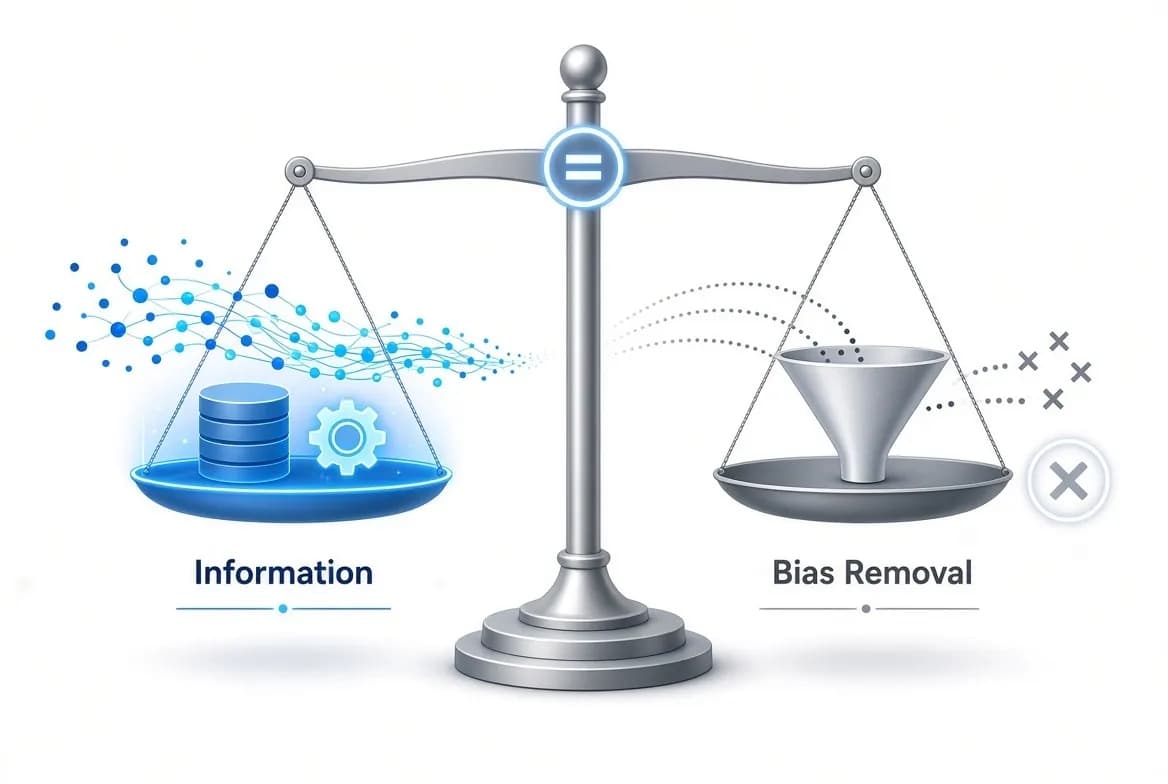
تصویر: یک ترازو با کفه‌های نابرابر، نماد سوگیری غیرقابل حذف در الگوریتم‌ها
آموزش کاربردی

تضاد ریاضی میان انصاف و دقت؛ چرا حذف سوگیری از هوش مصنوعی غیرممکن است

نظریه اطلاعات ثابت می‌کند که سوگیری یک ویژگی بنیادین در داده‌هاست، نه یک خطای نرم‌افزاری. حذف کامل سوگیری لزوماً منجر به از دست رفتن اطلاعات کلیدی و کاهش دقت مدل می‌شود.

۳ دقیقه خواندن۲
چرا مدل‌های زبانی بزرگ توهم می‌زنند و الگوهایی که واقعاً آن را متوقف می‌کنند
آموزش کاربردی

۵ الگوی معماری برای مهار توهم در مدل‌های زبانی بزرگ

توهمات در مدل‌های زبانی، یک نقص فنی نیست بلکه نتیجه‌ی ماهیت آماری آن‌ها در پیش‌بینی توکن‌هاست. برای ساخت سامانه‌های قابل‌اعتماد، باید از نگاه به مدل به‌عنوان «ماشین پاسخ‌گو» فاصله…

۳ دقیقه خواندن۲