«فراتر از ابزار»؛ نقش متدولوژی نویسندگی در انسانیسازی صدای مصنوعی
یک راهنمای جامع برای تولیدکنندگان محتوا نشان میدهد که کلید دستیابی به روایتهای طبیعی در هوش مصنوعی، بیش از آنکه به ابزار وابسته باشد، در تکنیکهای نوشتاری و مدیریت ضربآهنگ است.…
موضوع
Models that natively process text+image+audio+video
۱٬۶۶۴ مقاله منتشر شده
یک راهنمای جامع برای تولیدکنندگان محتوا نشان میدهد که کلید دستیابی به روایتهای طبیعی در هوش مصنوعی، بیش از آنکه به ابزار وابسته باشد، در تکنیکهای نوشتاری و مدیریت ضربآهنگ است.…
انویدیا مدل رایگان Nemotron 3 Diarization را برای شناسایی همزمان ۸ گوینده در محیطهای واقعی منتشر کرد. این مدل با ثبت رکورد جدید در محک VoiceArena، دقت تشخیص صدا را بهطور…
بررسی جامع ابزارهای تبدیل ویدیوهای بلند به کوتاه نشان میدهد که صنعت در حال شکاف میان دو رویکرد است: اتوماسیون یککلیکی برای سرعت، و ویرایشگرهای عاملمحور برای دقت. انتخاب ابزار…
یک راهنمای عملی جدید، فراتر از پرامپتنویسی ساده، یک خط لوله تولیدی ساختاریافته برای ویدیوهای کوتاه معرفی کرده است. این متد بر وابستگی متقابل فیلمنامه، صدا و تصویر برای تولید…
پلتفرم ElevenLabs با ارائه API توسعهدهندهمحور، امکان شبیهسازی صدای انسان و خودکارسازی گویندگی را فراهم کرده است. این فناوری با حذف نیاز به ضبطهای مکرر، مقیاسپذیری تولید…
تیم Sparkpix دریافت که نام بردن از یک مدل دوربین خاص، بسیار مؤثرتر از فهرست کردن صدها محدودیت فنی برای رسیدن به واقعگرایی در تصاویر هوش مصنوعی است. آنها با جایگزینی دستورات…
پژوهشگران راهکاری برای تبدیل مدلهای زبانی عمومی به مدلهای تصمیمگیرنده با سرعت بسیار بالا یافتهاند. این روش بهجای تولید متن، توزیع احتمالات توکنها را میخواند و در مدل…
پژوهشگران استنفورد رباتی انساننما توسعه دادهاند که با ساخت دوقلوهای دیجیتال از محیطهای جدید، کارهای پیچیده خانگی را بدون اسکریپتهای پیشنویس اجرا میکند. این سیستم با ترکیب…
رویکرد جدیدی به نام تقلیل دانش متقاطع (CMKD) به کاوشگرهای سیارهای اجازه میدهد تا با استفاده از دادههای غنی حسگرهای مداری، زمینشناسی پیچیده را حتی بدون داشتن تصاویر برچسبدار…
یک توسعهدهنده مستقل توانست با ترکیب هوش مصنوعی صوتی و عاملهای خودمختار، تمام فرآیندهای نگهداری نرمافزاری و رندرهای سهبعدی استودیوی خود را از روی کاناپه مدیریت کند. این تجربه…
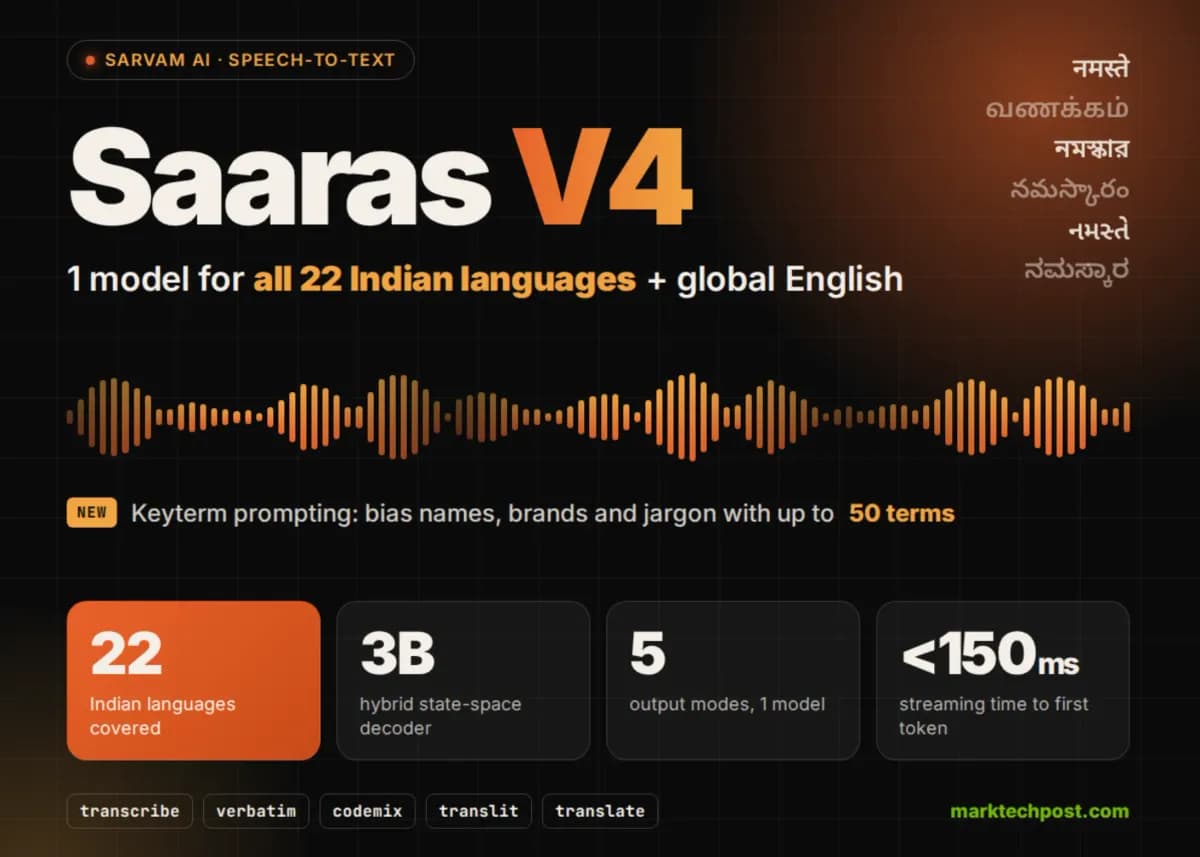
شرکت Sarvam AI مدل Saaras V4 را برای بازشناسی گفتار در ۲۲ زبان هندی و انگلیسی جهانی معرفی کرد. این مدل با استفاده از یک رمزگشای ترکیبی، دقت استخراج متن از فایلهای صوتی با نویز…
زیرساختهای هوش مصنوعی صوتی از ابر به لبه منتقل شدهاند و اکنون شبیهسازی فوقواقعگرایانه صدا روی دستگاههای موبایل در کمتر از یک ثانیه رخ میدهد. این تحول با ادغام قابلیتهای…