پرش به محتوای اصلی

موضوع

کاربردی

۳٬۳۱۶ مقاله منتشر شده

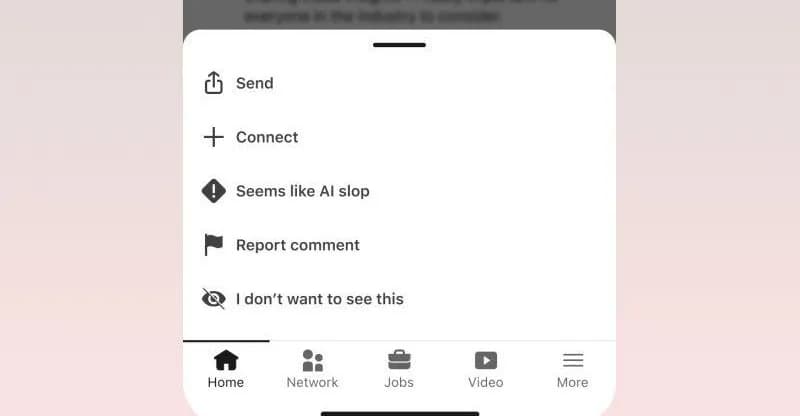
دکمه جدید لینکدین: «به نظر محتوای هوش مصنوعی است»

«AI Slop»؛ مبارزه با محتوای بی‌کیفیت هوش مصنوعی در شبکه لینکدین

لینکدین با معرفی دکمهٔ گزارش محتوای بی‌کیفیت، موجی از اعتراض کاربران به پست‌های تولیدشده توسط هوش مصنوعی را مدیریت می‌کند. این اقدام منجر به کاهش ۴۰ درصدی بازدیدها از محتوای…

۲ دقیقه خواندن۲
عامل یافتن ریشه مشکل تشدید با Gemini و ADK
آموزش کاربردی

درون سازوکار Gemini برای طبقه‌بندی خودکار پرونده‌های ارجاعی

یک مدیر خدمات مشتری در آمازون با استفاده از ابزارهای گوگل، عاملی برای تحلیل خودکار پرونده‌های ارجاعی ساخته است. این ابزار جایگزین بازبینی دستی سرپرستان شده و علت ریشه‌ای مشکلات را…

۳ دقیقه خواندن
من به منتقد LLM‌ام گفتم مخالف‌خو باش. شروع کرد به رد کردن طرح‌ها به خاطر «کافی دقیق نبودن».
آموزش کاربردی

حفاظ‌های کدنویسی، وسواسِ مدل‌های زبانی در بازبینی برنامه‌ها را مهار کردند

پروژه PlannerCritic نشان داد که مدل‌های زبانی در نقش بازبین، برنامه‌های ایمن را به‌دلیل وسواس در جزئیات مسدود می‌کنند. توسعه‌دهندگان با جایگزینی قضاوت مدل با یک لایه کدنویسی قطعی…

۴ دقیقه خواندن۱
بودجه به زیرعامل هوش مصنوعی بدهید، نه کلیدها را
آموزش کاربردی

Grantor-MCP دسترسی عامل‌های هوش مصنوعی را با بودجه‌های رمزنگاری‌شده محدود کرد

سرویس جدید Grantor به توسعه‌دهندگان اجازه می‌دهد به‌جای اعطای کلیدهای API کامل، بودجه‌های زمانی و عددی محدودی را به عامل‌های فرعی اختصاص دهند. این ابزار از دسترسی نامحدود عامل‌های…

۳ دقیقه خواندن
راهنمای ضروری هزینه کل مالکیت برای تیم‌های استفاده‌کننده از مدل Llama
آموزش کاربردی

میزبانی شخصی Llama تنها پس از ۳۶۱ میلیون توکن در ماه به‌صرفه می‌شود

تحلیل جدید هزینه‌های مالکیت نشان می‌دهد که جایگزینی APIهای ابری با سرورهای شخصی Llama تنها در حجم‌های بسیار بالا اقتصادی است. این مدل تأکید می‌کند که هزینه‌های نیروی انسانی و برق،…

۴ دقیقه خواندن
سیاه‌چاله‌های توجه در مدل‌های زبانی بزرگ: چرا اولین توکن می‌تواند جاذبه‌ای سیاه شود
آموزش کاربردی

StreamingLLM با حفظ توکن‌های اولیه پایداری استنتاج را در جریان‌های میلیونی

پژوهشگران دریافتند که مدل‌های زبانی از توکن‌های ابتدایی به عنوان «چاهک‌های توجه» برای تخلیه احتمالات اضافی استفاده می‌کنند. با حفظ این توکن‌ها در یک حافظه کش لغزنده، StreamingLLM…

۱۲ دقیقه خواندن۴
کاهش ۶۰٪ هزینه مدل رایگان با کش معنایی: راه‌اندازی ۳۰ دقیقه‌ای
آموزش کاربردی

کاهش ۵۷ درصدی فراخوانی مدل‌ها با پیاده‌سازی حافظهٔ معنایی

یک روش جدید برای کشینگ معنایی با استفاده از بردارهای معنایی، درخواست‌های تکراری کاربران را شناسایی کرده و تعداد فراخوانی‌های مدل زبانی را بیش از نصف کاهش می‌دهد. این رویکرد به‌جای…

۴ دقیقه خواندن۲