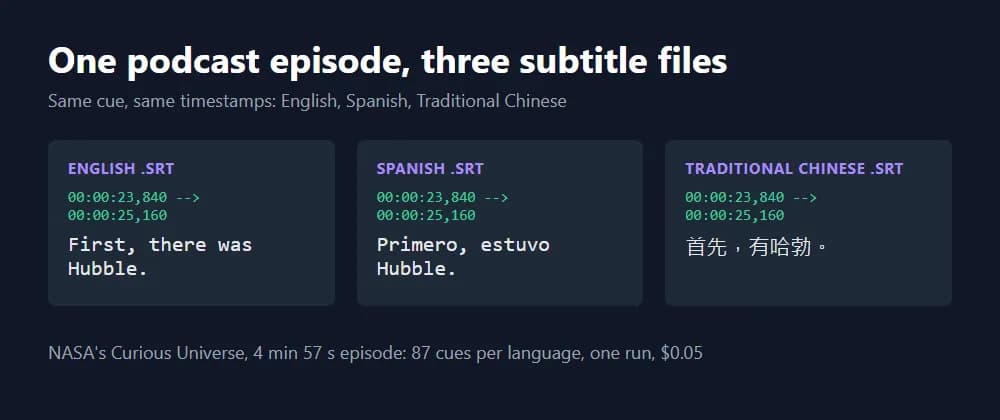
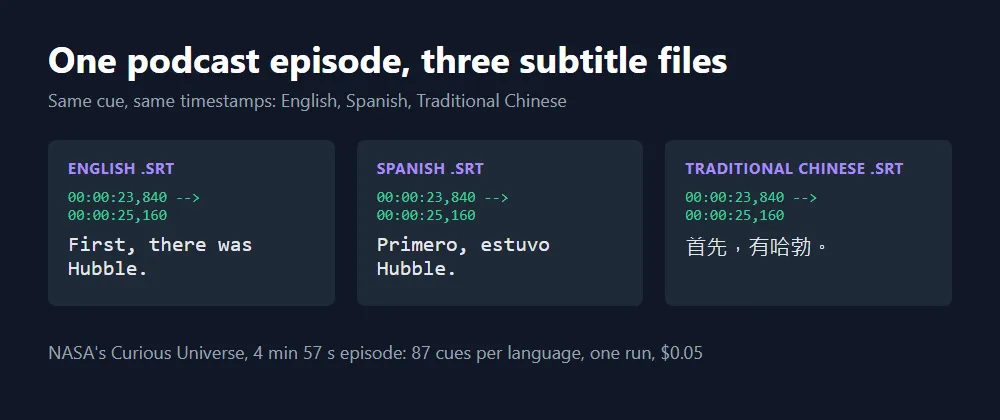
اگر تولیدکننده محتوایی هستید که میخواهید پادکستهای خود را برای مخاطبان جهانی بهینه کنید، دیگر نیازی نیست ساعتها وقت خود را صرف تکهتکه کردن متنها، تبدیل صوت به متن، تقسیم متن به بخشهای زمانی (Cues) و ترجمه دستی هر بخش کنید تا زمانبندیها بههم نریزد. اکنون با یک اجرای ساده در پلتفرم Apify، صوت پادکست شما به زیرنویسهای کاملاً همگام در حداکثر ۵ زبان مختلف تبدیل میشود.
بسیاری از ابزارهای ترجمه فعلی هنگام کار با فایلهای SRT، زمانبندیها را بههم میریزند یا بخشهای متنی را با هم ادغام میکنند، چون ساختار فایلهای زیرنویس را نمیشناسند. ابزار audio-transcriber با ادغام لایه ترجمه مستقیماً در فرآیند بازشناسی گفتار (ASR) — شبیه به مترجمی که همزمان با شنیدن حرفهای گوینده، ترجمه را روی کاغذ مینویسد تا هیچ ثانیهای جا نماند — تضمین میکند که هر بخش ترجمهشده، دقیقاً همان زمان شروع و پایان نسخه اصلی انگلیسی را داشته باشد.
طبق مستندات فنی منتشرشده در ۱ اکتبر ۲۰۲۶، این ابزار برای بازشناسی سریع و دقیق از مدل Whisper large-v3-turbo استفاده میکند. کاربران میتوانند لینک RSS، آدرس مستقیم فایلهای صوتی در قالبهای MP3, MP4, M4A, WEBM یا فایلهای آپلودی را به سیستم بدهند. این سامانه بهطور خودکار زبان منبع را تشخیص داده و خروجی را در هر دو قالب SRT و VTT ارائه میدهد.
تنظیمات و گزینههای ورودی
کاربران برای کنترل هزینه و محتوا میتوانند اجرای ابزار را با استفاده از چندین پارامتر خاص شخصیسازی کنند:
- podcastFeeds: پذیرش لینکهای RSS یا لینک نمایشهای اپل پادکست.
- titleIncludes: فیلتر کردن اپیزودها بر اساس عنوان؛ در صورت عدم استفاده از این گزینه، ابزار بر اساس پارامتر
maxEpisodesPerFeedجدیدترین اپیزودها را برمیدارد. - usePublisherTranscripts: اگر روی
falseتنظیم شود، ابزار را مجبور به انجام بازشناسی واقعی میکند. اگر رویtrue(پیشفرض) باشد، Actor در صورت موجود بودن تگ<podcast:transcript>ناشر از آن استفاده میکند و هیچ هزینهای برای دقایق صوتی دریافت نمیکند. - subtitleLanguages: پشتیبانی از حداکثر ۵ زبان از طریق نام یا کد زبان (مثلاً
esبرای اسپانیایی،jaبرای ژاپنی یاzh-TWبرای چینی تایوانی).
همانطور که در تحلیل قبلی ما دربارهی بهینهسازی هزینههای استنتاج در مدلهای بازمتن اشاره کردیم، کاهش لایههای پردازشی کلید افزایش سرعت است. در این ابزار نیز ادغام ترجمه و استنتاج، زمان پردازش را بهشدت کاهش داده است.
عملکرد فنی و تحلیل هزینهها
در یک تست واقعی روی اپیزود پادکست ناسا با عنوان «Launching Soon: NASA's Roman Space Telescope»، یک کلیپ ۴ دقیقه و ۵۷ ثانیهای (فایل MP3 با حجم ۷.۵ مگابایت) تنها در ۸۱ ثانیه پردازش شد. از این مقدار، ۷۵ ثانیه صرف بازشناسی و ترجمه شد. این اجرا ۱۰۷ اپیزود از مجموع ۱۰۸ اپیزود را فیلتر کرد تا کلیپ هدف را بیابد و در نهایت ۷۵۴ کلمه و ۸۷ بخش زیرنویس برای هر زبان تولید کرد.
هزینه این اجرا تنها ۰.۰۵ دلار بود که به این صورت محاسبه شد:
- بازشناسی: ۵ دقیقه صوتی × ۰.۰۰۶ دلار
- ترجمه: ۵ دقیقه × ۲ زبان × ۰.۰۰۲ دلار
برای فایلهای طولانیتر، سرعت خیرهکنندهتر است. یک فایل ۶۲ دقیقهای در ۱۴۴ ثانیه پردازش شد که یعنی تقریباً ۱۷ تا ۲۶ برابر سریعتر از زمان واقعی است. برای رفع مشکل مدل Whisper در نادیده گرفتن برخی بخشهای گفتار در فایلهای طولانی، این Actor اکنون هر شکاف ۵ ثانیهای یا بیشتر را بهطور خودکار باز-بازشناسی میکند؛ این قابلیت در تست فایل ۶۲ دقیقهای، ۹ بخش گمشده را بازیابی کرد. در مقایسه با زیرنویسهای رسمی NASA ScienceCasts، میانگین خطای زمان شروع بین ۰.۴۰ تا ۰.۵۱ ثانیه بود.
ساختار قیمتگذاری
استفاده از این Actor هزینه اولیه (Start Fee) ندارد و پرداختها صرفاً بر اساس دقایق صوتی است:
- بازشناسی استاندارد: ۰.۰۰۶ دلار برای هر دقیقه صوتی (۰.۳۶ دلار برای هر ساعت).
- برچسبگذاری گوینده (اختیاری): ۰.۰۱۵ دلار برای هر دقیقه.
- زیرنویس ترجمهشده: ۰.۰۰۲ دلار برای هر دقیقه صوتی به ازای هر زبان (تنها برای زبانهایی که با موفقیت ترجمه شوند).
بهعنوان مثال، یک اپیزود ۳۰ دقیقهای که به اسپانیایی و آلمانی ترجمه شود، ۰.۱۸ دلار برای متن اصلی و ۰.۱۲ دلار برای دو زبان زیرنویس هزینه خواهد داشت.
اتوماسیون و یکپارچهسازی
برای تولیدکنندگانی که برنامه هفتگی دارند، قابلیت newEpisodesOnly اضافه شده است. با تعریف یک monitorName ابزار اپیزودهای پردازششده را به خاطر میسپارد و فقط برای محتوای جدید منتشر شده پس از آخرین اجرا هزینه دریافت میکند. اگر در یک روز برنامهریزی شده، اپیزود جدیدی منتشر نشده باشد، اجرا هیچ متنی بازشناسی نمیکند و هزینهای دریافت نمیشود. همچنین اپیزودهای قدیمی را میتوان با فعال کردن backfillOlderEpisodes: true پردازش کرد.
توسعهدهندگان میتوانند از طریق کتابخانه پایتون apify-client یا درخواستهای HTTP ساده، این سیستم را در جریان کاری خود قرار دهند. خروجیها شامل یک مجموعه داده جامع است که برای هر اپیزود یک ردیف شامل متن، بخشها و پاراگرافها دارد. همچنین در صورت فعال بودن wordTimestamps: true آرایهای از کلمات (شامل کلمه، زمان شروع و پایان) در هر بخش بدون هزینه اضافی ارائه میشود. خروجی نهایی شامل srtUrl و vttUrl برای زبان اصلی و ترجمهشده و متادیتای اپیزود (عنوان پادکست، عنوان اپیزود، تاریخ انتشار و لینک اپیزود) است.
زیرنویسها بهطور خودکار به حداکثر ۷ ثانیه و دو خط در هر بخش محدود میشوند تا با استانداردهای پلتفرمهای ویدیویی سازگار باشند و از ایجاد بخشهای طولانی (بیش از ۲۰ ثانیه) که معمولاً توسط پلتفرمها رد میشوند، جلوگیری شود.
با این حال، نویسنده هشدار میدهد که ترجمههای ماشینی همچنان یک «پیشنویس قوی» هستند و نیاز به بازبینی دارند. در تستهای زبان چینی سنتی، ابزار گاهی از اصطلاحات چین اما mainland استفاده کرده (مثلاً نوشتن «哈勃» برای Hubble به جای «哈伯» تایوانی) یا نامهای خاص را بهطور ناقص ترجمه کرده است (مثلاً تبدیل Discovery به «迪斯covery»).
این تغییر در گردش کار به این معناست که تولیدکنندگان محتوا دیگر نیازی به مدیریت APIهای ترجمه مجزا یا ویرایش دستی فایلهای SRT ندارند. با تبدیل ترجمه به یک خروجی موازی در زمان بازشناسی، به جای اینکه یک مرحله پسپردازش باشد، ریسک جابهجایی زمانی (Timing Drift) حذف و سد ورود به بازارهای جهانی بهشدت کاهش یافته است.
اگر در حال گسترش یک استراتژی محتوای چندزبانه هستید، باید نظارت کنید که این خط لولههای خودکار چگونه با اصطلاحات منطقهای برخورد میکنند. گام بحرانی بعدی، ادغام حلقههای بازبینی توسط گوینده بومی (Native Speaker) مستقیماً در این جریانهای کاری مبتنی بر API خواهد بود.
گام بعدی شما
- اگر پادکست دارید، یک تست رایگان با مدل Whisper-turbo روی اپیزودهای کوتاه انجام دهید تا دقت همگامسازی را بسنجید.
- برای کاهش هزینهها، ابتدا بررسی کنید آیا ناشر پادکست شما تگ
podcast:transcriptرا فعال کرده است یا خیر. - در صورت استفاده برای زبانهای آسیایی، حتماً یک ویراستار بومی را برای بازبینی نهایی «پیشنویس» زیرنویسها در نظر بگیرید.
اما داستان سختافزاری این تحول و نحوه اجرای مدلهای Whisper در مقیاس بالا حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو