
تصور کنید میخواهید یک مجسمهٔ سنگی را با کمترین تعداد ضربهٔ تیشه و با همان دقتِ استادکار بسازید. در دنیای مدل انتشار (Diffusion Model) — که شبیه به تراشیدن یک تودهٔ نویز برای رسیدن به یک تصویر واضح است — هدف جدید دیگر تقلید از نتیجه نیست، بلکه فشردهسازی همین مسیر تراشیدن است.
به گزارش The Sequence در ۱۱ اوت ۲۰۲۶، تولید تصویر یک فرآیند تکمرحلهای نیست، بلکه یک مجسمهسازی تکرارشونده است که در آن مدل دهها برش کوچک میزند تا نمونهای منسجم را از دل نویز تصادفی بیرون بکشد.
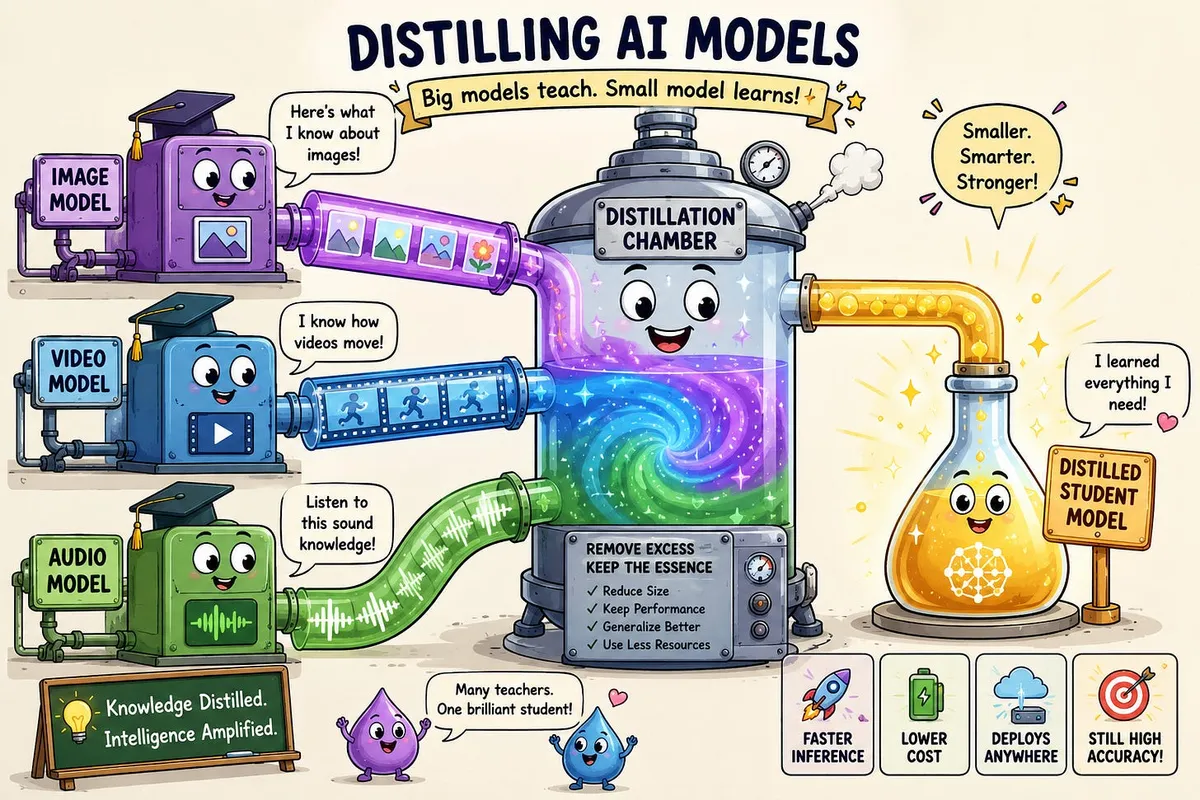
این سازوکار چالشی کاملاً متفاوت با مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — ایجاد میکند. در دیستیل (Distillation) متنی، مدل شاگرد صرفاً یاد میگیرد که چون استاد گفت «پاریس»، او هم بگوید «پاریس». این رویکرد یادگیری، یادآور بحثهای اخیر ماست که در آن بررسی کردیم آیا تقلید ساده از توالیها برای ارتقای مدلهای کوچک کافی است یا خیر. اما در مدلهای انتشار، شاگرد باید توزیع حرکت و هندسهٔ معنایی بین دنیای دادههای مختلف را بیاموزد.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مدلهای مولد اشاره کردیم، تمرکز صنعت اکنون از افزایش تعداد پارامترها به سمت بهرهوری در استنتاج تغییر کرده است. این روند با مفاهیمی چون تقطیر دادههای مصنوعی برای تبدیل مدلهای بزرگ به مدرسان هوش مصنوعی همسو است تا کیفیت خروجی در مدلهای کوچکتر حفظ شود. برای متخصصان، این یعنی هدف دیگر تقلید از خروجی نیست؛ بلکه هدف این است که مسیری که مدل برای رسیدن به خروجی طی میکند، بدون آسیب به ساختار تصویر، فشرده شود.
بر اساس مستندات فنی، این چرخش نشان میدهد که مرز بعدی کارایی مدلها در این است که یک مدل تا چه حد میتواند مسیرهای پیچیده تولید را میانبر بزند. اگر بتوانیم این مسیرها را دیستیل کنیم، به تولید تصاویری با کیفیت بالا اما با کسری از محاسبات فعلی دست مییابیم.
گام بعدی شما
- پژوهشهای جدید دربارهی «مدلهای سازگاری» (Consistency Models) را برای کاهش تأخیر در خطوط تولید تصویر دنبال کنید.
- تکنیکهای فشردهسازی مسیر (Trajectory Compression) را در محیطهای عملیاتی برای کاهش هزینه استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — بررسی کنید.
- تفاوت بین تقلید خروجی و فشردهسازی مسیر را در بنچمارکهای مدلهای کوچکشده بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ اثر این فشردهسازی بر مصرف حافظه VRAM را در گزارش بعدی بررسی خواهیم کرد.



گفتگو