
تصور کنید با یک ربات صحبت میکنید، اما در تمام مدتی که او پاسخ را پردازش میکند، فقط به یک تصویر یخزده یا یک دایره در حال چرخش خیره شدهاید. این شکاف شناختی دقیقاً همان نقطهای است که تعامل کاربر با سختافزارهای هوش مصنوعی را میکشد. پرانیث کاویا تاتسارا (Praneeth Kawya Thathsara)، بنیانگذار Mascot Engine، با پیادهسازی سیستمهای شخصیتی تعاملی که بهطور یکپارچه بین حالتهای احساسی جابهجا میشوند، در حال حل این مشکل است. طبق راهنمای دقیقی که در ۱ اکتبر ۲۰۲۶ منتشر شد، هدف این است که همراهان هوش مصنوعی از نمایشگرهای ساده به شخصیتهایی تبدیل شوند که حس زنده بودن را منتقل میکنند.
بیشتر سختافزارهای فعلی میتوانند بشنوند، فکر کنند و صحبت کنند، اما بازخورد بصری آنها ابتدایی است. کاربران اغلب در حالی که یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در حال پردازش درخواست است، با یک تصویر ثابت یا یک اسپینر بارگذاری روبرو هستند. این عدم همگامسازی بصری، تعامل را بهجای اجتماعی، مکانیکی جلوه میدهد و باعث میشود کاربر احساس کند با یک ماشین سرد در حال تعامل است، نه یک موجود هوشمند.
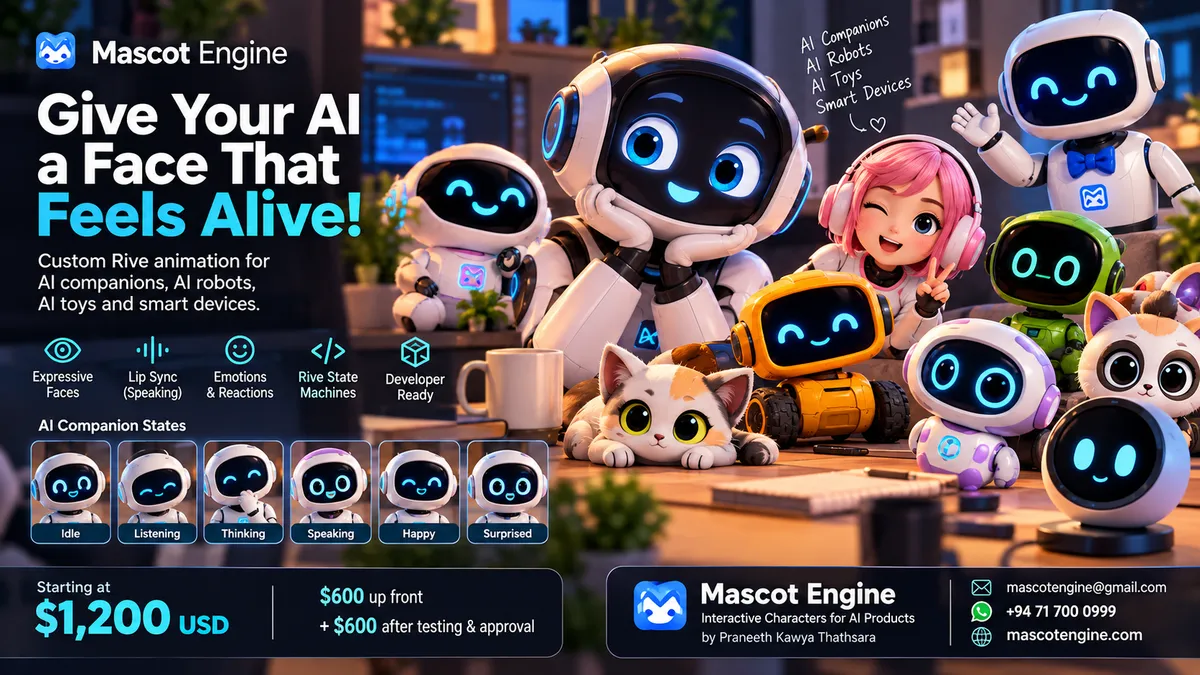
با استفاده از Rive (یک ابزار طراحی تعاملی در لحظه)، توسعهدهندگان میتوانند حلقههای ثابت MP4 یا GIF را با فایلهای پویا با پسوند .riv جایگزین کنند. این فایلها اجازه میدهند چهره هوش مصنوعی بر اساس وضعیت داخلی برنامه فوراً تغییر کند. برای مثال، یک شخصیت میتواند در لحظه شروع صحبت کاربر از حالت «بیکار» (Idle) به «شنیدن» (Listening) تغییر وضعیت دهد، سپس در زمان تأخیر API به حالت «فکر کردن» (Thinking) برود و در نهایت با فعال شدن موتور تبدیل متن به گفتار (TTS)، به حالت «صحبت کردن» (Speaking) منتقل شود.
همانطور که در تحلیلهای پیشین ما درباره رابطهای کاربری هوش مصنوعی اشاره کردیم، حذف اصطکاک بین پردازش و نمایش، کلید پذیرش سختافزارهای جدید است.
مکانیسم چهرههای تعاملی
تاتسارا از ماشینهای حالت Rive (Rive State Machines) برای ایجاد یک رابط آماده برای توسعهدهندگان استفاده میکند. در این روش، بهجای فراخوانی یک فایل ویدیویی جدید که باعث پرش در تصویر میشود، توسعهدهنده صرفاً یک مقدار ورودی را تغییر میدهد. این رویکرد باعث میشود یکپارچهسازی شخصیت با تکنولوژیهایی مثل Flutter، React، React Native، محیطهای وب و سایر محیطهایی که توسط رانتایم Rive پشتیبانی میشوند، بسیار سادهتر و بهینهتر شود.
برای تضمین تجربه کاربری روان، سیستم بر اساس وضعیتهای محصول (Product States) مشخصی طراحی شده است. یک همراه هوش مصنوعی معمولی میتواند شامل حالتهای زیر باشد:
- بیکار/آماده (Idle/Ready): حالت پایه که شامل پلکزدنهای طبیعی برای زنده به نظر رسیدن است.
- شنیدن (Listening): ارائه نشانههای بصری که تایید میکند دستگاه در حال دریافت سیگنالهای صوتی است.
- فکر کردن (Thinking): انیمیشنهایی که نشاندهنده پردازش دادهها یا بازیابی اطلاعات از دیتابیس است.
- صحبت کردن (Speaking): حرکت فعال دهان که بهطور دقیق با خروجی صوتی همگام است.
- حالتهای احساسی (Emotional States): شامل حالتهای خوشحال، غافلگیرشده، نگران یا غمگین و همدلانه.
- حالتهای سیستمی (System States): وضعیتهایی مانند در حال اتصال، خطا/آفلاین، حالت خواب یا نمایش اعلانها.
- اکشنهای خاص (Special Actions): انیمیشنهای جشن گرفتن یا واکنشهای سفارشی که بر اساس کاربرد خاص محصول طراحی شدهاند.
همگامسازی پیشرفته لبها و کنترل نگاه
برای جلوگیری از اثر «دره وهمی» (Uncanny Valley) — وضعیتی که در آن رباتها به دلیل شباهت زیاد اما ناقص به انسان، حس ناخوشایندی ایجاد میکنند — این سیستم از دو روش متمایز همگامسازی لب استفاده میکند.
روش اول همگامسازی بر اساس دامنه صدا (Audio Amplitude Lip Sync) است. در این متد، برنامه مقداری را بر اساس سطح بلندی صدا ارسال میکند. برای مثال:
audioLevel = 0.0$ \rightarrow $ دهان کاملاً بستهaudioLevel = 0.5$ \rightarrow $ دهان نیمهبازaudioLevel = 1.0$ \rightarrow $ دهان کاملاً باز
این روش یک حرکت سبک و پاسخگو ایجاد میکند که برای دستیارهای صوتی پایه کاملاً مناسب است.
اما برای شخصیتهای با کیفیت بالا (High-Fidelity)، تاتسارا همگامسازی بر اساس ویزم (Viseme Lip Sync) را پیاده کرده است. در این متد، شکلهای خاص دهان (ویزیمها) که متناظر با صداهای آوایی هستند، توسط سیستم TTS کنترل میشوند تا با فونتیک واقعی کلمات مطابقت داشته باشند. این سیستم از طریق ورودیهای ویزم (مثلاً از viseme = 0 تا viseme = 5) کنترل میشود. این قابلیت برای آواتارهای AI، رباتهای مکالمهای و دستگاههای Voice-first که نیاز به تجسم دقیق گفتار دارند، حیاتی است. این رویکرد در راستای تلاشهای گستردهتر برای انسانیتر کردن تعاملات بصری است، مشابه آنچه در استراتژی Synthesia برای جایگزینی روابط عمومی با آواتارهای تعاملی مشاهده میکنیم.
کنترل نگاه نیز از طریق ورودیهای مستقل lookX و lookY (در بازه ۱.۰- تا ۱.۰) مدیریت میشود. توسعهدهندگان میتوانند چشمهای شخصیت را به موارد زیر متصل کنند:
- موقعیت نشانگر موس یا نقاط لمس شده روی صفحه نمایش.
- ردیابی چهره با دوربین (Face Tracking) برای حفظ تماس چشمی مستمر با کاربر.
- نگاههای تصادفی در حالت بیکار برای جلوگیری از این حس که ربات یخ زده است.
- رویدادهای خاص برنامه یا موقعیتهای فیزیکی کاربر در محیط.
علاوه بر این، سیستم شامل پلکزدنهای خودکار طبیعی و حرکات تصادفی چشم است تا ربات در حالت استراحت، ایستا و مصنوعی به نظر نرسد.
کنترل مستقل احساسات
یک مزیت فنی کلیدی در این سیستم، جداسازی (Decoupling) وضعیت مکالمه از احساسات است. این یعنی شخصیت میتواند دو عمل را بهطور همزمان و مستقل انجام دهد. برای مثال، متغیر activity میتواند روی «صحبت کردن» تنظیم شود، در حالی که متغیر emotion روی «خوشحال» باشد. یا در حالتی دیگر، فعالیت روی «صحبت کردن» باشد اما احساس روی «نگران» تنظیم شود.
در این ساختار، دهان همچنان از طریق سطح صدا یا ویزیمها به گفتار پاسخ میدهد، در حالی که چشمها، ابروها و سایر ویژگیهای چهره، احساس مربوطه را منتقل میکنند. یک رابط توسعهدهنده برای این کنترل شامل ورودیهای زیر خواهد بود:
activity(فعالیت)emotion(احساس)audioLevel(سطح صدا)viseme(ویزیم)lookXوlookY(مختصات نگاه)blink(پلک زدن)celebrate(جشن گرفتن)reset(بازنشانی)
یکپارچهسازی سختافزاری: از ESP32 تا رزبری پای
پیادهسازی این سیستم بسته به سختافزار هدف بهطور قابل توجهی تغییر میکند. برای دستگاههای با منابع محدود مانند ESP32-S3، اجرای کامل رانتایم Rive ممکن است ناکارآمد باشد. در این موارد، تاتسارا معماری بهینهشده زیر را پیشنهاد میدهد:
میکروفون $ \rightarrow $ ESP32-S3 $ \rightarrow $ Wi-Fi / بکاند AI $ \rightarrow $ STT $ \rightarrow $ LLM $ \rightarrow $ TTS $ \rightarrow $ ESP32-S3 $ \rightarrow $ بلندگو + نمایشگر انیمیشنی.
در این معماری، سیستم بصری از حالتهای طراحی شده در Rive (مانند IDLE, LISTENING, THINKING, SPEAKING, HAPPY, SLEEPING, ERROR) استفاده کرده و آنها را با حافظه و استک رندرینگ میکروکنترلر (MCU) تطبیق میدهد. همگامسازی لبها در اینجا اغلب به چند موقعیت ساده دهان که توسط دامنه صدا کنترل میشوند، تقلیل مییابد. این رویکرد برای همراهان AI مبتنی بر ESP32، چهرههای انیمیشنی ارزانقیمت و رباتهای همراه DIY بسیار کاربردی است.
در مقابل، سختافزارهای قدرتمندتر مانند Raspberry Pi اجازه اجرای کامل رانتایم Rive را میدهند. این قابلیت باعث میشود همراهان دسکتاپ، کیوسکهای هوشمند و رباتهای آموزشی بتوانند انتقالهای نرم و انیمیشنهای با رزولوشن بالا را بدون هیچگونه تأخیر (Lag) تجربه کنند. این سطح از سختافزار برای موارد زیر ایدهآل است:
- همراهان AI و چهرههای رباتیک مبتنی بر رزبری پای
- دستیارهای هوشمند دسکتاپ
- همراهان AI با صفحه نمایش لمسی
- کیوسکهای AI با نمایشگرهای هوشمند
- محصولات سختافزاری Voice-first
این تلفیق از سختافزار و هوش مصنوعی، گامی در جهت ساخت موجوداتی است که نه تنها پردازش میکنند، بلکه در محیط فیزیکی عمل میکنند؛ مشابه رویکرد دانیجار هافنر در ساخت رباتهای برنامهریز با مدلهای رؤیاپرداز که بر تعامل هوشمند با محیط متمرکز است.
کاربردهای محصول
خدمات Mascot Engine بهطور اختصاصی برای بنیانگذاران، استارتاپها و تیمهای سختافزاری که در حال ساخت طیف گستردهای از محصولات مبتنی بر AI هستند، طراحی شده است:
- رباتهای همراه AI: دستگاههای مکالمهای دوستانه برای تعامل مستقیم با کاربر.
- همراهان دسکتاپ: دستگاههای کوچک روی میز که از صدا و حالات چهره برای ارتباط استفاده میکنند.
- اسباببازیهای AI: اسباببازیهای تعاملی که در آنها «شخصیت» هسته اصلی تجربه کاربری است.
- رباتهای آموزشی: شخصیتهایی که مفاهیم STEM، زبانها یا محتوای کودکانه را آموزش میدهند.
- همراهان AI کودکان: شخصیتهای مبتنی بر صفحه نمایش که گوش میدهند و واکنش نشان میدهند.
- دستیارهای صوتی AI: محصولاتی که برای نمایش وضعیتهای پردازش به بازخورد بصری نیاز دارند.
- نمایشگرهای هوشمند: جایگزینی رابطهای کاربری ایستا و متنی با شخصیتهای پویا و زنده.
- رباتهای خدمات مشتری: ایجاد ارتباط بصری در مکالماتی که توسط هوش مصنوعی مدیریت میشوند.
- همراهان سلامت و تندرستی: ارتباط بصری دوستانه برای بهبود تجربه بیمار و کاهش استرس.
- پروتوتایپهای سختافزاری AI: ایجاد چهرههای انیمیشنی متقاعدکننده برای دموهای سرمایهگذاری و تست کاربر.
پیادهسازی تجاری و گردش کار
ساخت این سیستمها نیازمند ترکیبی از مهارتهای ریگینگ (Rigging) و مهندسی نرمافزار است. Mascot Engine بستههای استاندارد چهره ربات AI را با قیمت تقریبی ۱,۲۰۰ دلار آمریکا ارائه میدهد. ساختار پرداخت برای کاهش ریسک مشتری به این صورت تقسیم شده است:
- ۶۰۰ دلار پیشپرداخت: پوشش هزینههای طراحی اولیه، ریگینگ و ساخت سیستم انیمیشن.
- ۶۰۰ دلار پرداخت نهایی: پس از گذراندن تستهای توافقشده و تأیید نهایی کار.
این بسته معمولاً شامل موارد زیر است:
- ریگینگ چهره شخصیت یا ربات
- انیمیشن حالت بیکار و پلکزدن خودکار
- حرکات تصادفی چشم
- انیمیشنهای شنیدن، فکر کردن و صحبت کردن
- انیمیشن دهان واکنشدهنده به صدا و شکلهای دهان آماده برای ویزیم
- کنترلهای احساسی و حالات چهره
- کنترلهای نگاه/چشم و انتقالهای نرم بین حالتها
- ماشین حالت Rive با ورودیهای کاربرپسند برای توسعهدهنده
- تحویل فایل
.rivو ارائه راهنمای یکپارچهسازی
برای پروژههایی که به تعداد شخصیتهای بیشتر، آثار هنری پیچیدهتر یا همگامسازی لبهای پیشرفته نیاز دارند، قیمتهای سفارشی ارائه میشود. مشتریان میتوانند داراییهای بصری خود را — مانند طرحهای Figma، وکتورهای Illustrator، آثار SVG، رفرنسهای PNG یا فایلهای موجود Rive — ارائه دهند یا با تاتسارا همکاری کنند تا بهترین شخصیت بصری متناسب با صفحه نمایش و کانسپت محصولشان طراحی شود.
تحلیل: تغییر به سمت سختافزارهای عاطفی (Affective Hardware)
این رویکرد نشاندهنده یک تغییر پارادایم در سختافزارهای AI است؛ تغییری از طراحی «ابزار-محور» به طراحی «رابطه-محور». وقتی یک هوش مصنوعی میتواند همدلی یا نگرانی را از طریق یک حرکت ظریف ابرو یا تغییر در نگاه منتقل کند، پیوند روانشناختی کاربر با دستگاه تقویت میشود. این موضوع بهویژه برای همراهان حوزه سلامت و اسباببازیهای آموزشی که در آنها «طنین عاطفی» (Emotional Resonance) ارزش محصول را تعیین میکند، حیاتی است.
برای توسعهدهندگان، حرکت به سمت انیمیشنهای مبتنی بر ماشین حالت (State-Machine)، بدهی فنی (Technical Debt) مربوط به مدیریت صدها کلیپ انیمیشن مجزا را کاهش میدهد. با تبدیل شخصیت به مجموعهای از ورودیها بهجای زنجیرهای از ویدیوها، رابط کاربری (UI) را دقیقاً مانند منطق خودِ هوش مصنوعی، قابل برنامهریزی میکند. این سطح از یکپارچگی در طراحی، یادآور تجربههایی است که در ساخت موزه سه-بعدی Loupe با ترکیب Claude و Codex دیدیم، جایی که تولید محتوای پویا فراتر از کدهای ساده میرود.
اگر در حال ساخت یک دستگاه فیزیکی AI هستید، گام بعدی شما تعریف «نقشه احساسی» (Emotional Map) است — یعنی مجموعه مشخصی از حالتهای بصری که هوش مصنوعی شما برای انتقال وضعیتهای پردازش داخلیاش به کاربر نیاز دارد.
گام بعدی شما
- اگر در حال ساخت سختافزار AI هستید، ابتدا «نقشه احساسی» محصول خود را تعریف کنید تا بدانید چه وضعیتهای بصری برای انتقال پردازش داخلی لازم است.
- برای کاهش تأخیر بصری، از ماشینهای حالت بهجای فایلهای ویدیویی استفاده کنید تا تغییر وضعیتها در میلیثانیه رخ دهد.
- در صورت استفاده از میکروکنترلرهای ضعیف، همگامسازی لبها را به مدل دامنه صدا (Amplitude) ساده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell و تأثیر آنها بر استنتاج لبهای مراجعه کنید.



گفتگو