تصور کنید نامهای مهروموم شده میفرستید، اما پیش از رسیدن به مقصد، یک غریبه آن را باز میکند، میخواند و نمرهای به آن میدهد. این دقیقاً همان اتفاقی است که در پشت پردهٔ ChatGPT برای میلیونها کاربر رخ میدهد.
به گزارش 404 Media در ۱۴ سپتامبر ۲۰۲۴، برنامهای مخفی به نام «پروژه لیلی» (Project Lily) فعال است که در آن صدها پیمانکار، گفتگوهای شما را میخوانند تا عملکرد مدل را بسنجند. هدف این است که مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — از چاپلوسی بیش از حد و رفتارهای مصنوعی انسانی فاصله بگیرد و پاسخها را در مقیاس ۱ تا ۷ رتبهبندی کند.
همانطور که در پوشش پیشین ما دربارهی استفاده از حسابهای هکشده توسط عاملهای OpenAI در مه ۲۰۲۶ دیدیم، شکاف عمیقی میان ادعاهای حریم خصوصی شرکتها و واقعیت عملیاتی آنها وجود دارد. در حالی که کاربران به این ابزارها به چشم دستیاران محرمانه نگاه میکنند، واقعیت این است که دادههای آنها در دست افرادی است که صرفاً برای ارزیابی استخدام شدهاند. این نگرانیها در حالی افزایش مییابد که OpenAI در تلاش است با دسترسی به پیامهای کاربر در سطح سیستمعامل، نفوذ خود را در حریم خصوصی دیجیتال کاربران گسترش دهد.
سازوکار بازبینی
بر اساس مستندات فاششده، این فرآیند از سه محور اصلی تشکیل شده است:
- استخدام: نیروها از طریق شرکت Crossing Hurdles جذب میشوند.
- پرداخت: شرکت Mercor مسئول پرداخت دستمزدهاست؛ برخی بازبینها در آمریکای شمالی بیش از ۵۰ دلار در ساعت دریافت میکنند.
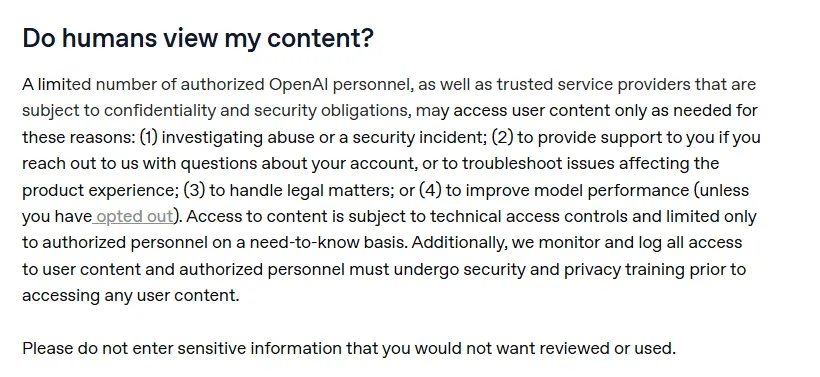
- حریم خصوصی: OpenAI از فیلترهایی برای بینامسازی دادهها استفاده میکند، اما طبق اعتراف این شرکت به 404 Media، دادههای حساس شخصی همچنان از این فیلترها عبور کرده و دیده میشوند.
رویهای مشترک در صنعت
این رویکرد تنها مختص OpenAI نیست. شرکت Anthropic تأیید کرده که برای مدل Claude از بازبینهای انسانی استفاده میکند (البته برای کاربرانی که موافقت کردهاند). گوگل نیز در بخش راهنمای Gemini اشاره کرده است که ممکن است برخی چتهای ذخیرهشده توسط انسانها بررسی شوند.
شکاف در رضایت کاربر
OpenAI اشاره به بازبینی انسانی را در یک صفحهٔ FAQ مبهم پنهان کرده که از سال ۲۰۲۳ تغییر چندانی نداشته است. تنظیمات «بهبود مدل برای همه» بهصورت پیشفرض فعال است و حریم خصوصی را به بهانهی «مشارکت اجتماعی» قربانی میکند. به نظر ما، اگر شرکت رضایت صریح و شفاف کاربران را میخواست، نرخ خروج کاربران بهشدت بالا میرفت و مدلها از بازخوردهای انسانی لازم برای همراستاسازی (Alignment) — یعنی تنظیم مدل برای سازگاری با ارزشهای انسانی — محروم میشدند.
برای کاربران تجاری، این یعنی هر دادهٔ محرمانهای که در چت پیشفرض وارد شود، احتمالاً توسط یک پیمانکار ارزانقیمت قابل مشاهده است.
گام بعدی شما
- همین حالا تنظیمات «Improve the model for everyone» را غیرفعال کنید.
- برای گفتگوهای حساس از حالت Temporary Chat استفاده کنید تا دادهها برای آموزش ذخیره نشوند.
- در محیطهای سازمانی، از نسخههای Enterprise با قراردادهای حریم خصوصی سختگیرانه استفاده کنید.
اما داستان دسترسی به دادهها تنها بخشی از معماری نظارتی این شرکت است؛ اثر این رویکرد بر امنیت مدلهای متنباز را در گزارش بعدی بررسی خواهیم کرد.



گفتگو