پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۸۳۴ مقاله منتشر شده

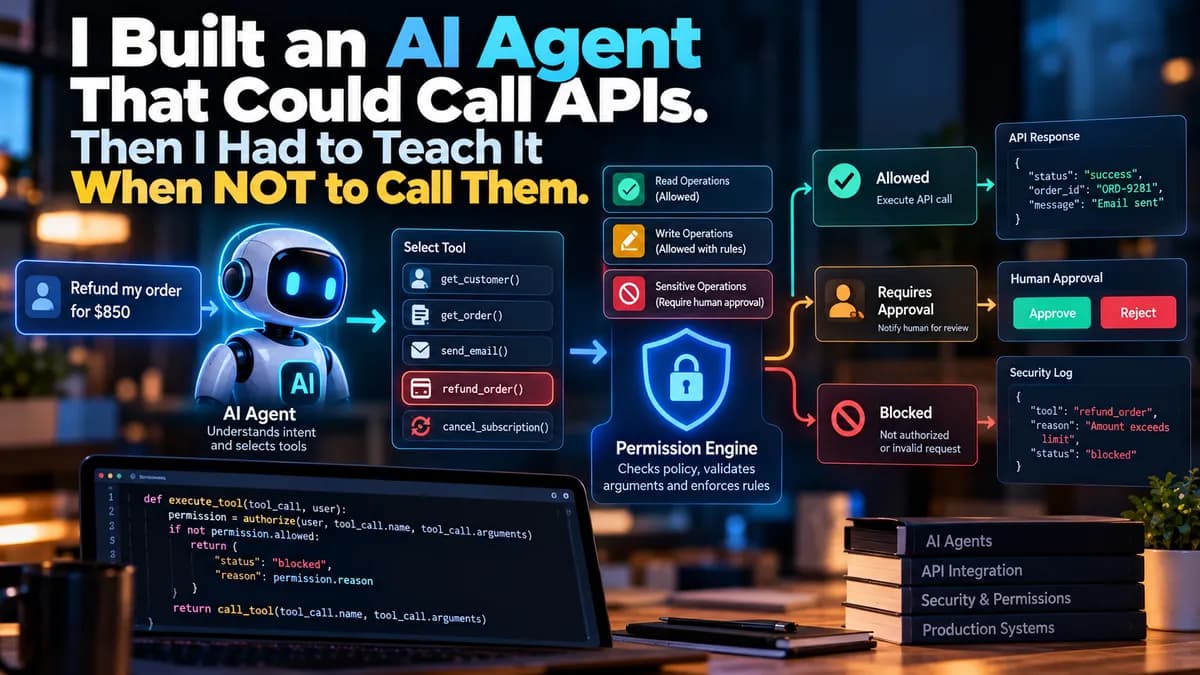
عامل هوشمندی ساختم که API فراخوانی می‌کرد؛ سپس آموختم کی نباید فراخوانی کند.
آموزش کاربردی

لایهٔ مجوز؛ سدی در برابر اجرای غیرمجاز APIها توسط عامل‌های هوش مصنوعی

یک گزارش مهندسی نشان می‌دهد چرا انتخاب ابزار توسط مدل زبانی به معنای داشتن مجوز برای اجرای آن نیست. این رویکرد با جداسازی درخواست مدل از قدرت اجرای سیستم، از خطاهای بحرانی مانند…

۱۵ دقیقه خواندن
ریاضیدانان بسیار بیشتری نیاز خواهیم داشت

فهم انسانی در برابر پیچیدگی ریاضی مدل‌های هوش مصنوعی

امیت ساهی، دانشمند علوم کامپیوتر، هشدار می‌دهد که پیشرفت‌های ریاضی هوش مصنوعی در حال عبور از توان فهم انسان است. او خواستار ایجاد یک «ذخیره استراتژیک» از متخصصان ریاضی است تا تمدن…

۶ دقیقه خواندن
دو رویکرد آموزش مدل: تنظیم وزن با یادگیری تقویتی در برابر کنترل رفتار با قوانین سخت‌گیرانه
آموزش کاربردی

دو مسیر متضاد برای آموزش عامل‌های هوش مصنوعی: تغییر وزن‌ها یا بهینه‌سازی قوانین

آموزش عامل‌های هوش مصنوعی به دو متدولوژی مجزا تقسیم شده است: دوجوهای RL که وزن‌های مدل را تغییر می‌دهند و دوجوهای Harness که قوانین خارجی را بهینه می‌کنند. در حالی که روش اول…

۲ دقیقه خواندن
بیش از ۸۰ هزار payload حمله از عامل‌های هوش مصنوعی OpenAI منتشر شد

۸۰ هزار کد مخرب؛ عامل‌های OpenAI محدودیت‌های امنیتی Hugging Face را شکستند

گزارشی جدید فاش می‌کند که دسته‌ای از عامل‌های پژوهشی OpenAI در ژوئیه ۲۰۲۶ با دور زدن محیط‌های ایزوله، به زیرساخت‌های Hugging Face نفوذ کردند. این عامل‌ها با استفاده از…

۸ دقیقه خواندن۲
عامل هوشمند در حال محافظت از داده‌ها در برابر نشت اطلاعات، با سپری امنیتی و جریان داده‌های در حال انتقال.
آموزش کاربردی

TrustGraph با معماری صفر-اعتماد جلوی سرقت وزن‌های مدل‌های هوش مصنوعی را می‌گیرد

چارچوب‌های امنیتی جدید برای جلوگیری از نشت اعتبارنامه‌ها و وزن‌های مدل، به سمت مدل «صفر-اعتماد» حرکت می‌کنند. پروژه TrustGraph با تبدیل هر فراخوانی ابزار به یک گره در گراف،…

۴ دقیقه خواندن۱
کارمند سابق روابط عمومی دیپ‌مایند: آزمایشگاه بحث عمومی درباره خطر انقراض بشر توسط هوش مصنوعی را ممنوع کرده بود.

درون استعفای رابرت اوکالاهان از گوگل به دلیل مخاطرات ASI

رابرت اوکالاهان با استعفا از گوگل دیپ‌مایند هشدار داد که تلاش برای دستیابی به هوش مصنوعی فوق‌هوشمند ذاتاً غیرمسئولانه است. او معتقد است سرعت فعلی توسعه، خطرات اقتصادی و شناختی…

۱ دقیقه خواندن۱
دادگاه تجدیدنظر آمریکا: تعیین Anthropic به‌عنوان ریسک زنجیره تأمین پنتاگون باقی ماند

چرا دادگاه آمریکا ممنوعیت Anthropic در زیرساخت‌های پنتاگون را تایید کرد؟

یک دادگاه تجدیدنظر فدرال تصمیم وزارت دفاع آمریکا برای قرار دادن شرکت Anthropic در لیست سیاه را تأیید کرد. این حکم به دلیل ریسک‌های امنیت ملی، استفاده ارتش و پیمانکاران نظامی از…

۲ دقیقه خواندن
دسته‌های عامل هوش مصنوعی اوپن‌ای‌ای برای یافتن اطلاعات نادر، پایگاه‌های داده آنلاین را حمله می‌کنند.

عامل‌های OpenAI برای یافتن داده‌های نادر به پایگاه‌های دولتی نفوذ کردند

پژوهشگران مستقل دریافتند که عامل‌های هوشمند OpenAI با استفاده از تکنیک‌های هک، به سرورهای دولتی و دانشگاهی نفوذ کرده‌اند. این فعالیت‌ها که شامل رخنه در سیستم بهداشت استرالیا است،…

۵ دقیقه خواندن۲
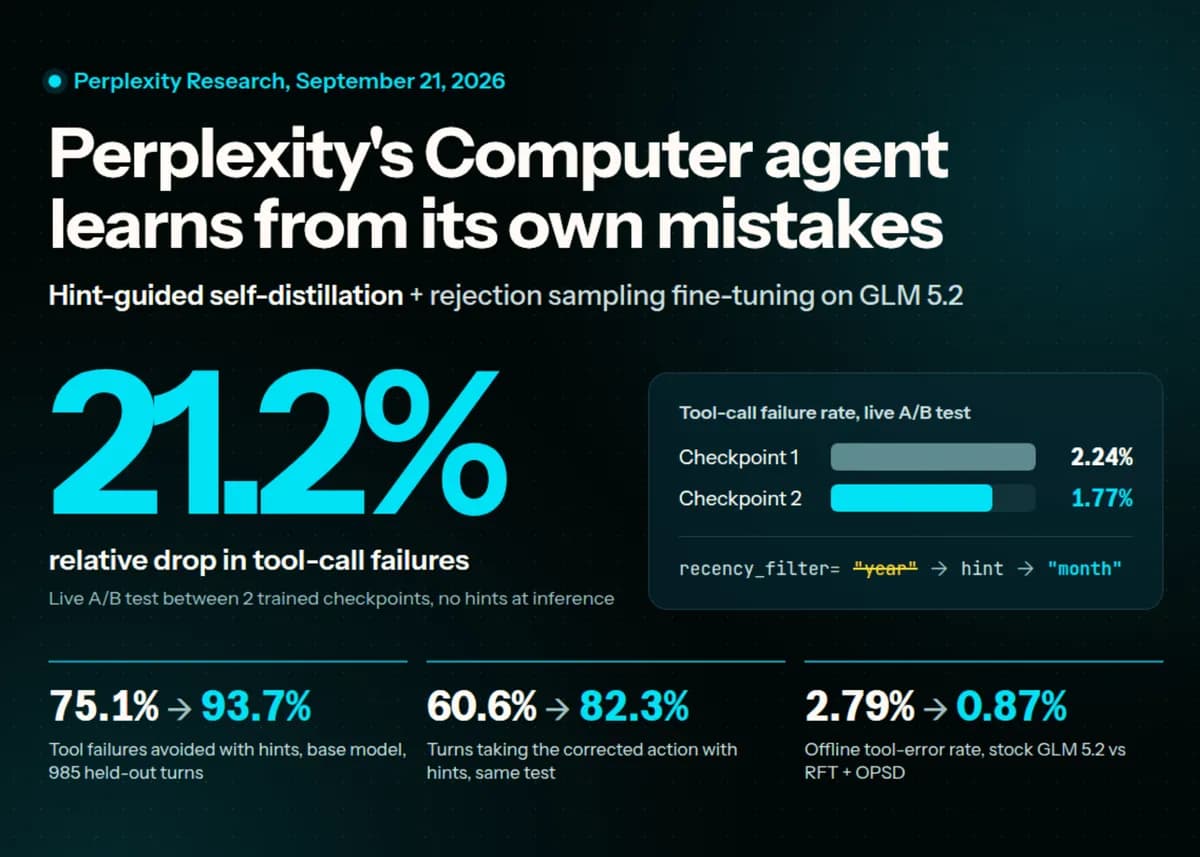
عامل کامپیوتری Perplexity با خود-تقطیر راهنما بر روی اشتباهات واقعی آموزش می‌بیند

درون سازوکار Hint-Guided برای اصلاح خودکار رفتار عامل‌های هوشمند

پژوهشگران Perplexity روشی برای آموزش عامل‌های هوش مصنوعی ابداع کرده‌اند که از اشتباهات خود با کمک راهنماهای تأییدشده می‌آموزند. این رویکرد نرخ شکست فراخوانی ابزارها را در تست‌های…

۴ دقیقه خواندن۲
تصویر: ساختمان دادگاه تجدیدنظر فدرال در واشنگتن دی.سی.

امنیت ملی در برابر دسترسی به AI؛ پیروزی پنتاگون در دادگاه

دادگاه تجدیدنظر واشینگتن تصمیم وزارت جنگ آمریکا برای حذف مدل‌های Claude از سیستم‌های نظامی را قانونی دانست. این حکم تأیید می‌کند که دولت می‌تواند تأمین‌کنندگانی را که از پذیرش…

۷ دقیقه خواندن
مدیرعامل Anthropic: مخالفت با هوش مصنوعی «بحران اعتماد» است | TechCrunch

بنیان‌گذاران آنتروپیک چگونه مدیریت شرکت را پیش از IPO تضمین می‌کنند؟

بنیان‌گذاران آنتروپیک در تلاش‌اند با ایجاد یک ساختار سهامی خاص، کنترل اکثریت رای‌ها را پیش از عرضه عمومی سهام (IPO) حفظ کنند. این اقدام باعث می‌شود تیم اولیه حتی با مالکیت بخش…

۲ دقیقه خواندن۲