تصور کنید در حال شرطبندی روی ترکیب دادهها برای آموزش یک مدل زبانی عظیم هستید و متوجه میشوید تمام پیشبینیهای شما در مقیاس بزرگ، غلط است. در ۲۱ سپتامبر ۲۰۲۶، شرکت Jane Street افشا کرد که واکنش مدلها به وزندهی دادهها با تغییر مقیاس بهطور بنیادی تغییر میکند و این یافته، فرض رایج مبنی بر تعمیمپذیری آزمایشهای مقیاس کوچک به مدلهای غولپیکر را به چالش میکشد.
هنگام آموزش شبکههای عصبی (Neural Network)، پژوهشگران زمان زیادی را صرف تصمیمگیری درباره این موضوع میکنند که مدل دقیقاً چه چیزی یاد بگیرد. این مسئله شامل پرسشهای حیاتی درباره ترکیب دادههاست؛ مثلاً ایجاد تعادل بین هوش عمومی در تمام وظایف کدنویسی در برابر تخصص در زبان OCaml، یا وزندهی به دادههای بازارهای قدیمی در مقابل دادههای تازه. در نهایت، اینها پرسشهایی درباره نحوه تخصیص ظرفیت بازنمایی مدل و عملیات اعشاری در ثانیه (FLOPs) است تا مشخص شود چه مقدار از دادههای باکیفیت تقویت شوند و در مقابل، مدل تا چه حد اجازه داشته باشد از تمام دادههای موجود یاد بگیرد.
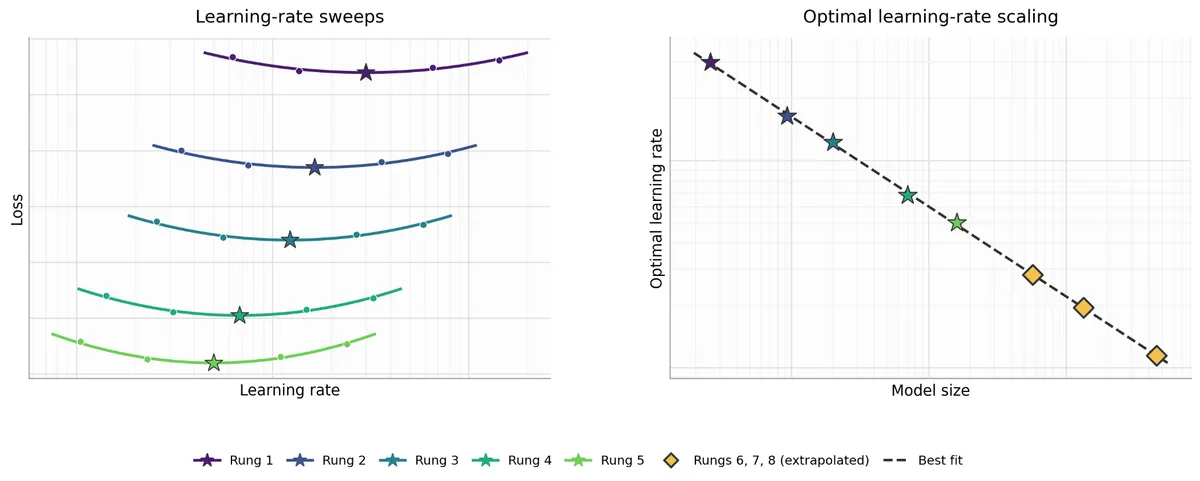
بسیاری از آزمایشگاههای هوش مصنوعی برای پیشبینی رفتار ابرپارامترها (Hyperparameter) در مقیاس بالا، به قوانین مقیاسپذیری (Scaling Laws) — مانند رویکرد Chinchilla — تکیه میکنند. هدف این است که از هزینههای گزاف اجرای جستوجوی شبکهای (Grid Search) روی مدلهایی با صدها میلیارد پارامتر اجتناب شود. اجرای چنین جستوجویی در مقیاسهای متوسط دشوار است و در مقیاسهای بزرگ، جایی که یک آزمایشگاه شاید فقط بتواند یک مدل را برای یک وظیفه خاص آموزش دهد، عملاً غیرممکن است. این چالشهای محاسباتی یادآور تلاشهایی است که در دستوردهٔ پیشآموزش Magic برای کاهش ۱۰ برابری هزینههای محاسباتی دیده شد تا بهرهوری در مقیاسهای بزرگ افزایش یابد.
همانطور که در بحثهای گذشته ما درباره امنیت مدلهای بازمتن اشاره کردیم، تکیه بر پیشفرضهای ساده در مقیاسهای بزرگ میتواند منجر به نتایج غیرمنتظره شود. پژوهش Jane Street رفتارهای «ناهنجار» در ترکیب دادهها را شناسایی کرده است که استخراج نتایج را خطرناک میکند. برای اینکه یک استخراج (Extrapolation) درست باشد، رفتارها باید یا نسبت به مقیاس تغییرناپذیر باشند (مانند نتایج MuP که در آن بسیاری از بهینههای ابرپارامتری پایدار میمانند) یا از طریق تغییرات مقیاس کوچک قابل پیشبینی باشند (مانند نتایج Kaplan که در آن کاهش زیان بهطور پیشبینیپذیری رخ میدهد). اما ترکیب دادهها بهشدت مستعد این رفتارهای غیرقابل پیشبینی و ناهنجار است.
برای جداسازی اثر وزن از کیفیت داده، این تیم «وزندهی توالی» را تحلیل کردند؛ روشی که در آن به هر توالی آموزشی در تابع زیان (Loss Function) یک وزن خاص اختصاص مییابد. این کار مانع از آن میشود که نتایج با تفاوت کیفیت دادهها در منابع مختلف یا تفاوت در منحصربهفرد بودن توکنهای حاشیهای در یک منبع خاص خلط شود.
آنها «توانِ وزنِ توالیِ مؤثر» (که با $p^$ نمایش داده میشود) را اندازهگیری کردند. این معیار ردیابی میکند که کاهش زیان مدل در یک توالی، تا چه حد به وزن آن توالی وابسته است. بهطور مشخص، $p^$ اندازهگیری میکند که کدام توان از وزن توالی، بیشترین تناسب را با کاهش زیان مورد انتظار مدل در آن توالی دارد.
کشف غیریکنواختی (Non-Monotonic)
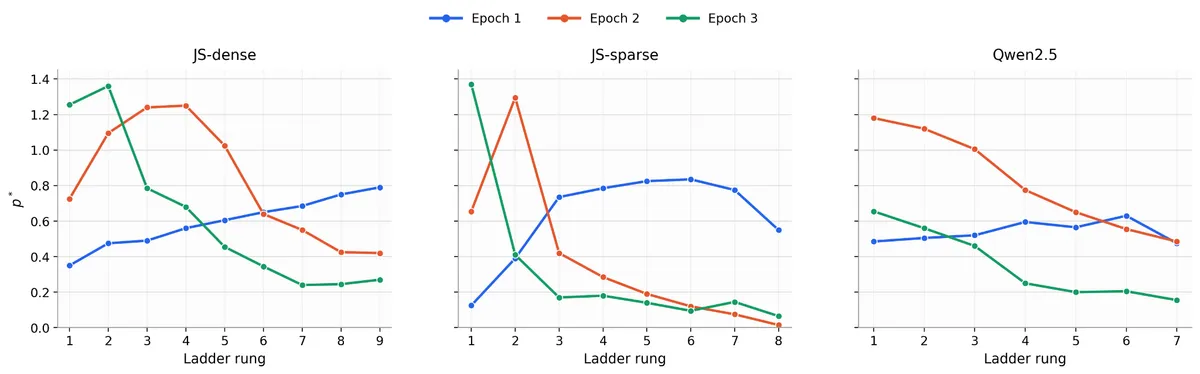
به نقل از مستندات این پژوهش، $p^*$ از یک قانون توانِ هموار پیروی نمیکند، بلکه مسیری صعودی و سپس نزولی را در مقیاسهای مدل طی میکند:
- مدلهای مقیاس کوچک: مقادیر $p^*$ کوچکی دارند. این مدلها روی یادگیری الگوهای عمومی در کل مجموعه داده تمرکز میکنند و وزن اختصاصیافته به توالیها را نادیده میگیرند. در این مرحله، کاهش زیان تا حد زیادی مستقل از وزن داده است.
- مدلهای مقیاس متوسط: با افزایش ظرفیت، $p^*$ بالا میرود. این مدلها به یادگیری الگوهای خاصِ دادهها، متناسب با وزنهای اختصاصیافته، تغییر وضعیت میدهند. در اینجا، کاهش زیان مدل به شدت به وزن توالی گره میخورد.
- مدلهای مقیاس بزرگ: وقتی مدلها به رژیم صدها میلیارد پارامتر میرسند، $p^*$ دوباره کاهش مییابد. این مدلها ظرفیت بازنمایی کافی برای یادگیری تمام الگوهای موجود در دادهها را دارند و در نتیجه، وزندهی دوباره بیاهمیت میشود.
متدولوژی آزمایش
خانوادههای مدل و مقیاس
پژوهشگران برای اطمینان از اینکه این روند یک ناهنجاری در یک معماری خاص نیست، آن را روی سه خانواده مدل متمایز آزمایش کردند:
- JS-dense: خانوادهای از مدلهای زبانی متراکم داخلی شامل ۹ مدل، از دهها میلیون تا صدها میلیارد پارامتر.
- JS-sparse: خانوادهای از مدلهای ترکیب خبرهها (Mixture of Experts) شامل ۸ مدل، که آنها نیز از دهها میلیون تا صدها میلیارد پارامتر را در بر میگیرند.
- Qwen 2.5: خانوادهای از مدلهای زبانی متراکم با وزنهای باز (Open Weights) از ۵۰۰ میلیون تا ۷۲ میلیارد پارامتر.
در تمام زمینههای آزمایش شده، محققان مشاهده کردند که عملکرد مدلها روی دادههای خارج از آموزش (Held-out)، بهطور مداوم با افزایش مقیاس بهبود مییابد.
فرآیند داده و وزندهی
آنها از یک محک متنی داخلی استفاده کردند که در آن وزنها بهصورت log-uniform بین ۰.۰۱ و ۱۰ توزیع شده بودند. مدلها برای ۳ Epoch آموزش دیدند و ارزیابیها پس از هر دوره برای ردیابی تغییرات $p^*$ انجام شد.
برای محاسبه $p^$، تیم مراحل زیر را دنبال کرد:
۱. آموزش مدل روی مجموعه داده با وزن $w_i$ برای هر توالی.
۲. ارزیابی مجدد مدل روی همان مجموعه داده.
۳. اندازهگیری کاهش زیان بهدستآمده برای هر توالی از مرحله آموزش.
۴. برازش $p^$ بهگونهای که کاهش زیان نرمالشده در یک توالی با وزن $w$، به بهترین شکل توسط $w^{p^*}$ توضیح داده شود.
درک معیار $p^*$
برای تفسیر نتایج، تیم سناریوهای زیر را برای این توان تعریف کرد:
- $p^ = 0$*: کاهش زیان مورد انتظار تحت تأثیر وزن نیست؛ توالیهای با وزن بالا و پایین کاهش مشابهی را تجربه میکنند.
- $0 < p^ < 1$*: توالیهای با وزن بیشتر، کاهش زیان بیشتری دارند، اما این مقیاس زیرخطی است.
- $p^ = 1$*: کاهش زیان دقیقاً متناسب با وزن آموزش است.
- $p^ > 1$: کاهش زیان بیش از حد روی توالیهای با وزن بالا متمرکز است، حتی بیشتر از آنچه خودِ وزنها القا میکنند (مثلاً اگر مدل فقط توالیهای با بالاترین وزن را حفظ کند و برای بقیه پیشبینیهای تصادفی ارائه دهد، $p^$ بسیار بالا خواهد بود).
نقش Epoching
این مطالعه نشان داد که آموزش برای دورههای (Epoch) بیشتر، نقطه اوج منحنی $p^*$ را به سمت مدلهای کوچکتر میبرد. در واقع، دفعات بیشتر عبور از دادهها به مدلهای کوچک اجازه میدهد الگوهای خاص و منحصربهفردی را ثبت کنند که پیشتر فقط برای مدلهای متوسط یا بزرگ در دسترس بود. این یعنی Epoching، گذار از یادگیری الگوهای عمومی به یادگیری الگوهای خاصِ وزندار را تسریع میکند.
فرضیه ظرفیت
به باور تحلیلگران Jane Street، این رفتار ناشی از تفاوت نرخ یادگیری الگوهای عمومی در برابر الگوهای خاص (Idiosyncratic) است. الگوهای عمومی، مانند درک زبان انگلیسی، بهخوبی تعمیم مییابند و ابتدا و مستقل از وزن یاد گرفته میشوند.
الگوهای خاص، مربوط به گروههای کوچکی از توالیها هستند. در مجموعه داده مورد استفاده، پتانسیل کاهش زیان از این الگوهای خاص بیشتر از الگوهای عمومی است. محققان پیشرفت مبتنی بر ظرفیت زیر را پیشنهاد میکنند:
۱. مدلهای کوچک ظرفیت محدود خود را برای الگوهای عمومی به کار میبرند و نمیتوانند الگوهای خاص را بازنمایی کنند.
۲. مدلهای متوسط ظرفیت کافی برای الگوهای عمومی و مهمترین الگوهای خاص (با بالاترین وزن) را دارند.
۳. مدلهای بزرگ ظرفیت یادگیری تمام الگوهای خاص را، فارغ از وزن آنها، دارا هستند.
این یافته مشابه روندی است که در گزارش فنی MAI-Thinking-1 (بخش ۲.۵.۲) ذکر شده بود؛ جایی که کیفیت نسبی آموزش با ترکیب دادههای متمرکز بر کد در برابر دادههای STEM، با افزایش اندازه مدل معکوس شد.
پیامدهایی برای قوانین مقیاسپذیری
این تغییر رفتار به این معناست که ترکیب دادهای که برای یک مدل ۱ میلیارد پارامتری بهینه شده، ممکن است برای یک مدل ۱۰۰ میلیارد پارامتری بهینه نباشد. وزن «بهینه» برای یک حوزه خاص — مانند کدنویسی OCaml یا دادههای اخیر بازار — یک هدف متغیر است که به ظرفیت کل بازنمایی مدل بستگی دارد.
علاوه بر این، محققان دریافتند که مقادیر واقعی $p^$ بین خانوادههای مختلف مدل متفاوت است و رابطه سادهای بین خانواده مدل و این توان وجود ندارد. برای مثال، کوچکترین مدل JS-sparse بهطور قابلتوجهی بزرگتر از کوچکترین مدل JS-dense بود، اما $p^$ کوچکتری داشت. به همین ترتیب، بزرگترین مدل JS-sparse بهطور قابلتوجهی بزرگتر از بزرگترین مدل Qwen 2.5 بود، اما $p^*$ بزرگتری داشت.
برای متخصصان، این بدان معناست که قوانین مقیاسپذیری برای ترکیب دادهها را نمیتوان یکبار تنظیم کرد و رها کرد. این پژوهش چند راهکار پیشنهاد میدهد:
- ارزیابی و استخراج نتایج ترکیب دادهها را فقط از مدلهایی انجام دهید که بهاندازه کافی بزرگ هستند تا از نقطه اوج $p^*$ عبور کرده باشند.
- وزنهای آموزش را بهطور خاص برای جبران $p^*$ مشاهدهشده در یک مقیاس معین تنظیم کنید.
Jane Street نتیجه میگیرد که حیاتیترین بخش پژوهشهای مقیاسپذیری، نه برازش منحنیها، بلکه درک علت انحراف مدلها از آنهاست. با شناسایی این رفتارهای ناهنجار، آزمایشگاهها میتوانند تجربیات خود را بهگونهای بازطراحی کنند که بزرگترین مدلها پیشبینیپذیر شوند. آنها فرآیند دقیقی برای اندازهگیری میزان انحراف مدلها از پیشبینیها دارند تا نقاط شکست قوانین مقیاسپذیری را شناسایی کرده و مدلهای بزرگتر و بهتری را با اطمینان بیشتری آموزش دهند.
گام بعدی شما
- اگر در حال مقیاسدهی به مدلهای خود هستید، از تکیه مطلق به نتایج مدلهای زیر ۱۰ میلیارد پارامتر برای تعیین وزن دادههای مدلهای ۱۰۰ میلیارد پارامتری پرهیز کنید.
- اثر Epoching را روی توزیع یادگیری الگوهای خاص در مدلهای کوچکتر بررسی کنید تا شاید بتوانید با هزینه کمتر به نتایج مدلهای متوسط برسید.
- در استراتژی ترکیب دادهها، ظرفیت بازنمایی مدل را به عنوان یک متغیر فعال در نظر بگیرید، نه یک ثابت.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو