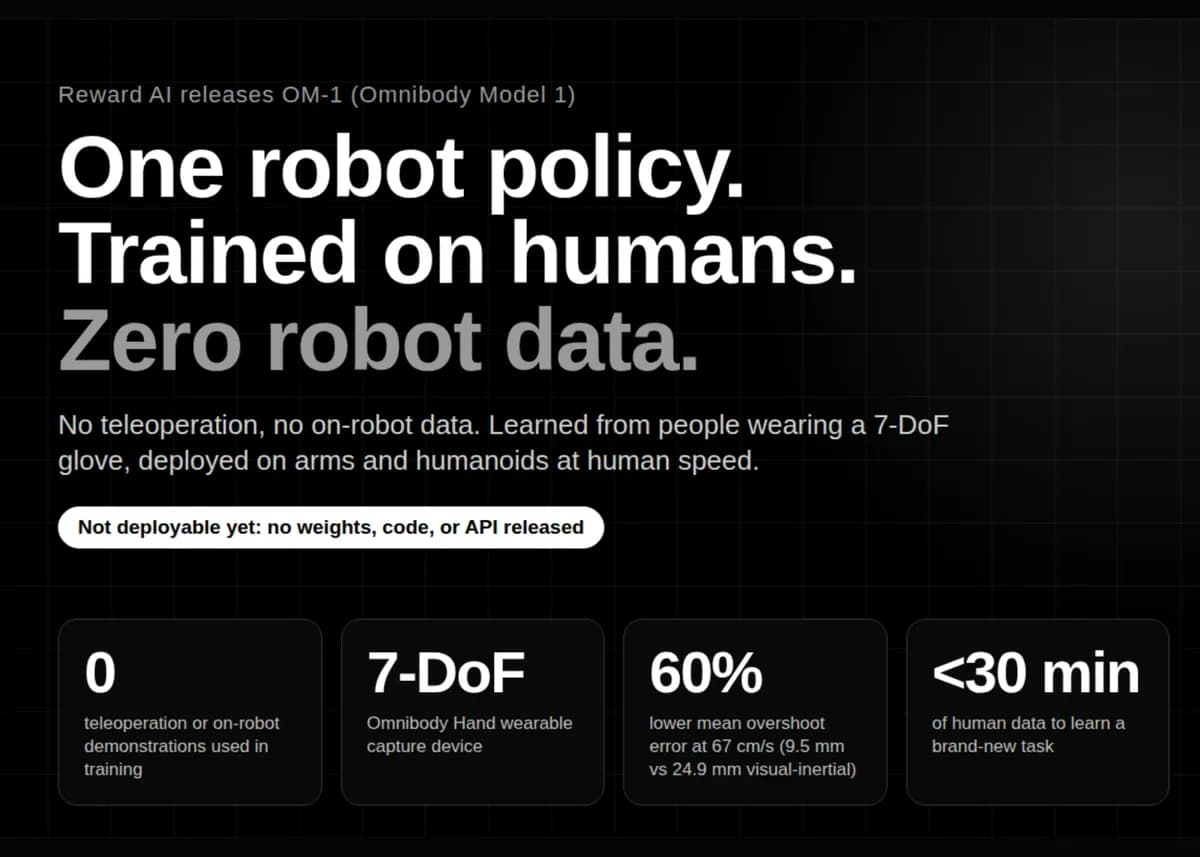
تصور کنید رباتی را که بدون یک ثانیه آموزش روی سختافزار خودش، تنها با تماشای حرکات دست شما، یاد بگیرد چگونه اشیایی را با دقت جابهجا کند. این ادعای جسورانه Reward AI است که با معرفی OM-1 (Omnibody Model 1)، بازی یادگیری رباتیک را تغییر داده است. این مدل توسط تیمی توسعه یافته است که پیشینهای در پروژههای پیشرویی مانند DexCap، HumanPlus و ALOHA دارند.
به نقل از مستندات این پروژه، OM-1 یک سیاست دستورزی (Manipulation Policy) چندمنظوره است که تمام مهارتهای خود را از نمایشهای انسانی بهدست میآورد. این نمایشها از طریق یک دستکش سنسوردار ضبط میشوند و نیاز به عملیات از راه دور (Teleoperation) یا جمعآوری دادههای مستقیم روی ربات را بهطور کامل حذف میکنند. این رویکرد، استاندارد فعلی صنعت را که در آن مدلهای بنیادی به سختافزارهای خاص وابسته هستند، به چالش میکشد. همانطور که در تحلیل قبلی ما دربارهی مدلهای دادهمحور رباتیک اشاره کردیم، پیش از این تصور میشد برای رسیدن به ظرافت دست انسان، نیاز به حجم عظیمی از دادههای جمعآوریشده توسط خودِ رباتها باشد؛ اما Reward AI با استناد به مفهوم «بیشتر، متفاوت است» (More Is Different) اثر اندرسون، معتقد است ظرافت انسانی از طریق محاسبات بیشتر یا دادههای رباتیک حاصل نمیشود، بلکه باید از منبع اصلی یعنی انسان استخراج شود. این رویکرد یادگیری سریع از دادههای انسانی، یادآور تلاشهای Generalist AI برای آموزش وظایف فیزیکی در زمانهای بسیار کوتاه است که مرزهای سرعت یادگیری در رباتیک را جابهجا کرد.
این سیستم بر اصل «یک مدل، یک رابط داده، هر بدنه» استوار است. تیم توسعهدهنده با طراحی یک خط لوله (Pipeline) واحد برای ثبت، یادگیری و کنترل، به این هدف دست یافته است که نمایشهای ضبطشده امروز بتوانند رباتهایی را آموزش دهند که هنوز حتی ساخته نشدهاند.
دست اومنیبادی (Omnibody Hand)
قلب این سیستم، Omnibody Hand است؛ یک پوشیدنی با ۷ درجه آزادی (7-DoF) که بر پایه تحقیقات پیشین تیم در پروژه DexCap برای ثبت حرکات قابل حمل ساخته شده است. این دستکش بهجای کپی کردن مفصلبهمفصل دست انسان، بر عملکردهای کلیدی تمرکز میکند: انتخاب نقاط تماس، تغییر جهت اشیا در دست و جابهجایی بین گیرشهای دقیق (Precision Grasps) و قدرتی (Power Grasps).
طبق اعلام Reward AI، این دستکش حرکاتی خاص را ثبت میکند، از جمله نیشگون انگشت شست و اشاره، خم شدن مفصلهای شست و اشاره، و حرکت جفتشدهی انگشتان میانی، حلقه و کوچک در مفصلهای MCP. برای حذف خطاهای ناشی از تفاوت طول انگشتان کاربران مختلف، یک مکانیزم خم شدن انتهایی (Distal Flexion) تعبیه شده است. این مکانیزم تفاوتهای فیزیکی انگشتان را جذب میکند تا نیاز به تنظیمات دستی برای هر کاربر از بین برود و از گیرشهای جبرانی (Compensated Grasps) که بر اثر لغزش یا محدودیتهای فیزیکی دستکش رخ میدهند، جلوگیری شود.
مشخصات فنی و ثبت دادهها
برای مدیریت تعاملات سریع — مانند جداسازی اشیا از روی نوار نقاله که در آن فرد در کسری از ثانیه شیء را شناسایی، میگیرد و پرتاب میکند — این دستکش از جریانهای دادهای چندوجهی (Multimodal) استفاده میکند:
- حسگرهای لمسی با فرکانس بالا و حسگرهای مجاورتی برای تشخیص لحظه پیش از تماس (Pre-contact approach).
- دوربینهای Global-shutter داخلی برای حفظ زمینه بصری و جلوگیری از تاری در حرکات سریع.
- حسگرهای الکترومغناطیسی ترکیب شده با سیستم جبرانسازی اغتشاشات برای ردیابی دقیق وضعیت دست.
- ثبت نیرو در طول مسیر حرکت، تا مدل علاوه بر مسیر، میزان فشار و تلاش وارد شده را نیز بیاموزد.
بر اساس بررسیهای فنی، دقت ردیابی این سیستم نسبت به روشهای رایج بصری-اینرسی (Visual-Inertial) جهش بزرگی داشته است. در آزمایشهایی که در آن دست بین نقاط توقف مکانیکی با هشت سرعت مختلف (از ۳ تا ۶۷ سانتیمتر بر ثانیه) حرکت میکرد، ردیابی الکترومغناطیسی میانگین خطای ۹.۵ میلیمتر را نشان داد، در حالی که این خطا در روشهای سنتی ۲۴.۹ میلیمتر بود؛ این یعنی کاهش ۶۰ درصدی خطا در بالاترین سرعت، همراه با پراکندگی کمتر در اجراهای متوالی.
معماری OM-1
مدل OM-1 اقدامات ربات را مستقیماً از جریانهای حرکتی انسان تولید میکند و نیازی به واسطههای رباتیک یا تبدیل رفتار به یک ربات میانی ندارد. برخلاف مدلهای سنتی، اینجا فرآیند آموزش تکمرحلهای است؛ یعنی هیچ تفکیکی بین پیشآموزش (Pre-training) و پسآموزش وجود ندارد و تمام دادهها در یک قالب واحد وارد مدل میشوند. در واقع، اولین نمایش ضبطشده و جدیدترین نمایش، هر دو یک سیاست واحد را آموزش میدهند. این متدولوژی در راستای رویکرد یادگیری از تکویدیو است که هدف آن کاهش وابستگی به مجموعهدادههای عظیم و تکراری است.
این مدل تصاویر، سیگنالهای لمسی، مجاورتی بین انگشتان و مسیرهای حرکتی را با نرخ نمونهبرداری بومی (Native Sampling Rate) پردازش میکند. با حذف کاهش نمونهبرداری (Downsampling) به یک فرکانس مشترک، جزئیات لمسی و حرکتی با فرکانس بالا در کنار دادههای بصری با فرکانس پایین حفظ میشوند. خروجیهای مدل شامل جهت حرکت، سرعت، نیرو و زمانبندی دقیق رویدادهایی مانند شروع گیرش است.
کنترل RL و استقرار
در لایهی زیرین این سیاست، یک لایهی کنترلی با فرکانس بالا قرار دارد که از طریق یادگیری تقویتی (Reinforcement Learning) در محیط شبیهسازی آموزش دیده است. این لایه وظیفه مدیریت دینامیکهای وابسته به سرعت و شتاب، اغتشاشات خارجی و تأخیرهای سیستم را بر عهده دارد و با ساعت داخلی خود عمل میکند.
این معماری به ربات اجازه میدهد حتی در مواجهه با بارهای غیرمنتظره — مانند باز کردن در یک یخچال کاملاً بسته یا بلند کردن جعبههایی با وزن نامعلوم — بدون متوقف کردن استنتاج (Inference) مدل اصلی، نقطه مرجع خود را حفظ کند. از آنجایی که پیشبینیهای متوالی ممکن است بهطور نرم به هم متصل نشوند، این لایه انتقال بین آنها را بهصورت آنلاین بهینه میکند. جالب اینجاست که همین فضای عملیاتی (Action Space)، هم دستورزی و هم ناوبری را برای رباتهای متحرک پوشش میدهد.
Reward AI ادعا میکند که OM-1 میتواند یک تکلیف کاملاً جدید با دینامیکهای دشوار و افقهای زمانی طولانی را در کمتر از ۳۰ دقیقه دادههای انسانی بیاموزد. شرکت تأکید کرده است که تمام کلیپهای منتشر شده با سرعت واقعی (1x) اجرا میشوند و این مدل روی بازوها، انساننمایهای پادار و رباتهای متحرک چرخدار قابل اجرا است.
با این حال، باید اشاره کرد که OM-1 در حال حاضر یک مدل داخلی است. هیچ وزنهای باز (Open Weights)، کد، مجموعهداده یا API برای آن منتشر نشده و نرخ موفقیتها در مقایسه با بنچمارکهای عمومی ارائه نشده است؛ بنابراین نتایج فعلی بیشتر بر پایه نمایشهای ویدیویی است تا دادههای آماری تأییدشده.
این تغییر رویکرد نشان میدهد که آینده رباتیک ممکن است در دادههای «مستقل از بدنه» (Embodiment-agnostic) نهفته باشد. اگر یک سیاست واحد بتواند سختافزارهای متنوع را با استفاده از یک رابط انسانی کنترل کند، گلوگاه صنعت از «جمعآوری ساعت-ربات» به «کیفیت ثبت حرکات انسانی» تغییر خواهد کرد. این تکامل در نهایت منجر به انتقال هوش مصنوعی فیزیکی از محیطهای شبیهسازی شده به خطوط تولید واقعی خواهد شد.
با این حال، باید اشاره کرد که OM-1 در حال حاضر یک مدل داخلی است. هیچ وزنهای باز (Open Weights)، کد، مجموعهداده یا API برای آن منتشر نشده و نرخ موفقیتها در مقایسه با بنچمارکهای عمومی ارائه نشده است؛ بنابراین نتایج فعلی بیشتر بر پایه نمایشهای ویدیویی است تا دادههای آماری تأییدشده.
این تغییر رویکرد نشان میدهد که آینده رباتیک ممکن است در دادههای «مستقل از بدنه» (Embodiment-agnostic) نهفته باشد. اگر یک سیاست واحد بتواند سختافزارهای متنوع را با استفاده از یک رابط انسانی کنترل کند، گلوگاه صنعت از «جمعآوری ساعت-ربات» به «کیفیت ثبت حرکات انسانی» تغییر خواهد کرد.
گام بعدی شما
- بررسی مقالات مربوط به DexCap برای درک عمیقتر از نحوه ثبت حرکات دست.
- دنبال کردن انتشار احتمالی API یا مجموعهدادههای Reward AI برای تست روی شبیهسازها.
- تحلیل مقایسهای بین رویکرد «دادههای انسانی» در مقابل «دادههای رباتیک» در مدلهای جدید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و نقش آنها در استنتاج سریع رباتیک مراجعه کنید.



گفتگو