عامل هوش مصنوعی شما میتواند پاسخی سریع و بدون خطای فنی ارسال کند، اما محتوای آن کاملاً غلط باشد. این فاصله میان «سلامت سیستم» و «کیفیت پاسخ»، دلیل اصلی رقابت شدید ابزارهایی مثل BotGauge و ۱۱ رقیب دیگر برای ورود به زیرساختهای تولیدی است؛ موضوعی که در مقایسهای کاربردی در اکتبر ۲۰۲۶ منتشر شد. این چالشها در واقع بخشی از ۲۰ استاندارد مهندسی برای تبدیل دموهای AI به عاملهای عملیاتی هستند که برای تضمین پایداری سیستمها در مقیاس صنعتی ضروریاند.
داشبوردهای سنتی مدیریت عملکرد (APM) فقط چراغهای سبز تأخیر و زمانِ بالا بودن سیستم را نشان میدهند. این ابزارها نمیتوانند تشخیص دهند که آیا یک عامل دچار توهم (Hallucination) — شبیه دوستی که خاطرهای را با اطمینان اما اشتباه تعریف میکند — شده است یا در میانه یک گردشکار، فراخوانی ابزاری را نادیده گرفته است. برای توسعهدهندگان، این یعنی یک فراخوانی موفق API همچنان میتواند به یک شکست تجاری منجر شود.
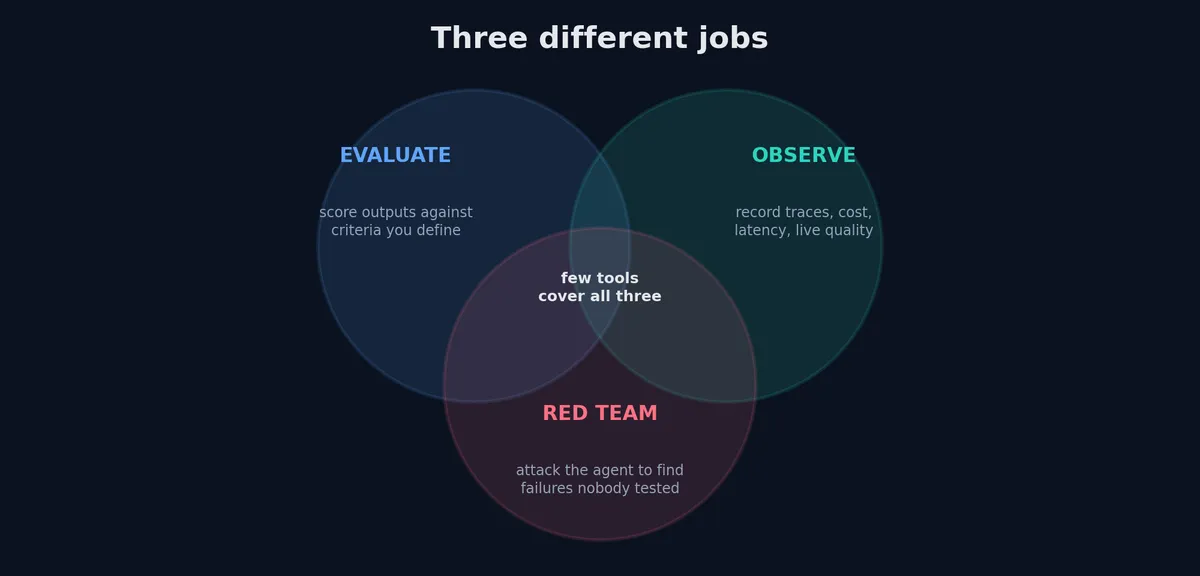
به گزارش منابع تخصصی، بازار اکنون به سه تخصص مجزا تقسیم شده است: ارزیابی (امتیازدهی به خروجیها بر اساس معیارهای مشخص)، نظارت (ثبت ردپای زنده، هزینه، تأخیر و کیفیت روی ترافیک واقعی) و تیم قرمز (Red Teaming) — یعنی حمله به عامل برای یافتن نقاط ضعفی که هنوز هیچ تستی برایشان نوشته نشده است. اکثر ابزارها تنها در یک یا دو مورد از این وظایف تخصص دارند. شناخت دقیق اینکه به کدام یک از این سه تخصص نیاز دارید، نیمی از مسیر تصمیمگیری است.
معیارهای انتخاب ابزار مناسب
برای اینکه صرفاً با ردپاهایی بدون زمینه مواجه نشوید و مطمئن شوید که ابزار شما واقعاً کاربردی است، طبق مستندات فنی باید به این سازوکارها دقت کنید:
- عمق ارزیابی: امتیازدهی به وفاداری (Faithfulness)، مرتبط بودن، ایمنی و میزان دستیابی به هدف با استفاده از مدل زبانی بهمثابه داور (LLM-as-a-judge)، متریکهای آماری یا بررسیهای کد سفارشی. در این راستا، مدلهایی مانند Gemini 3.7 Flash با دقت بالا در تحلیل داده میتوانند به عنوان ارزیابهای اقتصادی و کارآمد در این چرخه به کار گرفته شوند.
- ردیابی در سطح عامل: مشاهده هر پرامپت، فراخوانی ابزار، بازیابی داده (Retrieval) و هر شاخهبندی در تصمیمگیری؛ چراکه عاملهای چندمرحلهای اغلب در میانه یک زنجیره شکست میخورند.
- کشف شکستها: توانایی یافتن شکافهایی که مجموعههای آزمون استاندارد نمیبینند؛ این مورد برای عاملهایی که جابهجایی پول یا تغییر سوابق حساس را انجام میدهند، حیاتی است.
- هشارهای کیفی: اعلانهایی که هنگام افت امتیاز وفاداری یا ایمنی فعال میشوند، نه فقط هنگام خطاهای ۵۰۰ یا تأخیر زیاد در پاسخدهی.
- حلقه تولید به آزمون: گردشکاری که در آن شکستهای یافت شده در محیط عملیاتی، به تستهای رگرسیون تبدیل شوند که در خط لوله CI اجرا میگردند. این رویکرد در واقع همان مسیری است که در آن عاملهای هوش مصنوعی جایگزین اسکریپتهای سختگیرانه در اتوماسیون تست شدهاند تا انعطافپذیری سیستم افزایش یابد.
- تناسب تیمی: پشتیبانی از SSO، کنترل دسترسی، قیمتگذاری پیشبینیپذیر و سهولت استفاده برای مدیران محصول (PM) و تیم QA بدون نیاز به دخالت مداوم مهندس.
ابزارهای تخصصی بازار
برای تیمهایی که ارزیابی عمیق و ادغام کامل با CI را میخواهند، Braintrust بیش از ۲۵ امتیازدهنده داخلی و اکشنهای گیتهاب برای مسدود کردن PRهای بیکیفیت ارائه میدهد (شروع از ۲۴۹ دلار در ماه). با این حال، امکان میزبانی شخصی (Self-hosting) در این ابزار تنها به کاربران Enterprise محدود شده است. در مقابل، Confident AI بر دسترسی تمرکز کرده و به مدیران محصول و تیمهای QA اجازه میدهد بدون کمک مهندسی، بیش از ۵۰ معیار و هشدار را از طریق Slack یا PagerDuty رصد کنند، هرچند مدل قیمتگذاری آن بر اساس گیگابایت (GB) میتواند پیشبینی هزینهها را دشوار کند.
توسعهدهندگانی که در اکوسیستمهای خاص مستقر هستند، گزینههای متفاوتی دارند:
- LangSmith درختهای اجرای کامل را برای تیمهای LangChain و LangGraph فراهم میکند، از جمله صفهای حاشیهنویسی (Annotation Queues) برای بررسی توسط متخصصان، هرچند قیمتگذاری بر اساس کاربر (۳۹ دلار ماهانه) سریعاً مقیاس میگیرد و گران میشود.
- Datadog LLM Observability بازههای زمانی (Spans) مدل را مستقیماً در لاگها و ردپاهای APM موجود ادغام میکند، اما ارزیابی در آن یک ویژگی ثانویه است و قیمتگذاری بر اساس میزان استفاده میتواند غیرقابل پیشبینی باشد.
- Pydantic Logfire از OpenTelemetry استفاده میکند تا درخواستهای HTTP، حلقههای عامل، فراخوانیهای مدل و پرسوجوهای دیتابیس را در یک ردپای واحد و قابل پرسوجو با SQL قرار دهد، هرچند ارزیابیهای آن بیشتر بر روباریکهای سفارشی تکیه دارد تا متریکهای پیشفرض.
گزینههای متنباز و سبک
برای کسانی که از وابستگی به یک فروشنده (Vendor Lock-in) میگریزند، Langfuse ردیابی میزبانی شخصی، نسخهبندی پرامپت و ردیابی هزینه را با یک سطح رایگان و طرحهای پولی از ۲۹ دلار در ماه ارائه میدهد. کاربران باید توجه کنند که در این ابزار، عمدتاً باید ارزیابهای خودشان را تعریف و وارد کنند. Arize Phoenix رویکردی مبتنی بر نوتبوک دارد و به صورت محلی در داکر اجرا میشود؛ این ابزار با استفاده از خوشهبندی (Clustering)، گروههایی از ردپاهای در حال تخریب را شناسایی میکند، هرچند رابط کاربری آن نسبت به رقبای تجاری صیقلخوردهتر نیست.
برخی بازیگران کوچکتر روی حالتهای خاص شکست تمرکز کردهاند. Galileo از مدلهای ارزیاب کوچک و سریع استفاده میکند که هزینه آنها بسیار کمتر از یک داور LLM است تا حفاظها (Guardrails) — شبیه نردههای ایمنی در کنار پل که مانع سقوط میشوند — را در زمان اجرا ایجاد کند (شروع از ۱۰۰ دلار در ماه برای طرح Pro). Latitude نیز روی حلقه اصلاح تمرکز دارد؛ این ابزار شکستهای تکراری را خوشهبندی کرده و آنها را به عنوان ایشوهای ردیابی شده به عاملهای کدنویس میسپارد تا PRهای اصلاحی باز کنند، هرچند فاقد یک درگاه (Gateway) برای LLM است.
برای عاملهای پرریسک که با جابهجایی پول یا تغییر سوابق سروکار دارند، BotGauge در کمپینهای تطبیقی تیم قرمز تخصص دارد تا شکستهای کشفشده را به تستهای رگرسیون تبدیل کند. در حالی که محصول تیم قرمز آن در حال حاضر بر اساس لیست انتظار است و تحلیل هزینه توکنها را ندارد، اما شکاف میان نظارت و تست فعال را پر میکند. همچنین LangWatch شبیهسازیهای چندعاملی و صوتی را بصری میکند و شکستهای محیط تولید را به شبیهسازیهای CI تبدیل میکند (شروع از ۲۹ یورو برای هر کاربر در ماه).
نیازهای سازمانی و نظارتی
Fiddler سازمانهای تحت نظارت را با ردپاهای حسابرسی (Audit Trails)، تشخیص رانش (Drift Detection) و حفاظهای سریع برای هر دو مدل ML کلاسیک و LLM هدف قرار میدهد، هرچند یادگیری آن دشوار است و قیمتگذاری سفارشی دارد. بر اساس بررسی منابع متعدد، اکثر این ابزارها از جمله BotGauge به سمت حلقه «تولید به آزمون» حرکت میکنند تا شکستهای زنده بهطور خودکار به موارد آزمونی جدید تبدیل شوند.
این چرخش، فرض بنیادی توسعه AI را تغییر میدهد. ما از «مهندسی پرامپت» به سمت «مهندسی ارزیابی» میرویم؛ جایی که توانایی اندازهگیری یک شکست، ارزشمندتر از توانایی نوشتن یک پرامپت بینقص است.
در نهایت، انتخاب ابزار به پروفایل ریسک عامل شما بستگی دارد. اگر عامل شما فقط از یک پایگاه دانش (Knowledge Base) پاسخ میدهد، پلتفرمهایی مثل Langfuse یا Arize Phoenix کافی هستند. اما اگر عامل شما اقدامات واقعی در دنیای خارج انجام میدهد، به مکانیزم تیم قرمز نیاز دارید تا پیش از رسیدن خطا به حساب کاربر، آن را شکار کنید.
گام بعدی شما
- لاگهای شکست فعلی خود را بررسی کنید تا ببینید آیا «خطاهای خاموش» (پاسخهای فنی موفق اما محتوایی غلط) را از دست میدهید یا خیر.
- بر اساس ریسک عملیاتی عامل خود (اطلاعرسانی در برابر اقدام)، یکی از سه دسته ارزیابی، نظارت یا تیم قرمز را انتخاب کنید.
- اگر از LangChain استفاده میکنید، ابتدا LangSmith را تست کنید و سپس برای کاهش هزینه به گزینههای متنباز مثل Langfuse کوچ کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو