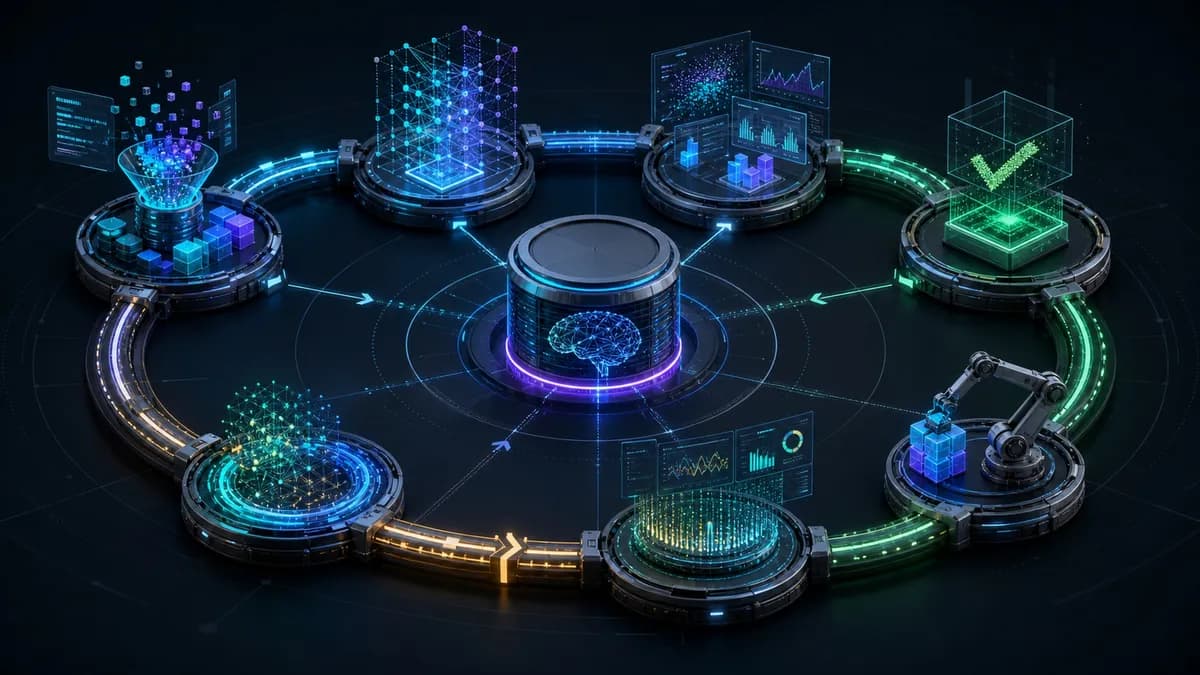
تصور کنید سیستمی دارید که مدلهای معیوب یا دادههای غلط را سریعتر از توانِ تشخیصِ هر انسانی، در محیط عملیاتی منتشر میکند. این اتفاق دقیقاً زمانی رخ میدهد که معیارهای پذیرش واقعی در گیتهای کنترلی کدگذاری نشده باشند؛ این همان نقطهٔ شکست مرکزی در تولید هوش مصنوعی مدرن است که MLOps (عملیات یادگیری ماشین) برای حل آن طراحی شده است.
برای بسیاری از تیمها، MLOps به مترادفی مبهم برای «هوش مصنوعی پیشرفته» تبدیل شده است. اما در واقعیت، این یک نظم دقیق مهندسی و حاکمیتی است. MLOps در واقع نظمِ ساخت، استقرار، مشاهده و بهروزرسانی سیستمهای یادگیری ماشین در محیط عملیاتی بهصورت تکرارپذیر است. تلقی کردن آن به عنوان مترادفی برای هوش مصنوعی پیشرفته، باعث میشود ادعاهای مربوط به آن غیرقابل تست شوند. MLOps شایسته یک توضیح دقیق است زیرا نام آن نشاندهنده یک جریان اطلاعاتی خاص، یک انتخاب در آموزش، یک مکانیزم زمان اجرا یا یک مرز حاکمیتی است.
بدون این سختگیری، مدلی که در دمو خیرهکننده به نظر میرسد، به محض مواجهه با ترافیک واقعی کاربران فرو میپاشد. تعریف MLOps شامل سه تعهد عملی است: یک ورودی شناساییشده، یک تغییر یا ویژگی تصمیمگیری که مختص MLOps است، و یک خروجی که بتوان آن را در برابر یک هدف تعیینشده سنجید. اگر یکی از این عناصر غایب باشد، این برچسب توصیف یک «آرزو» است، نه یک «مکانیزم اجرا شده».
تفاوت یک آزمایش آزمایشگاهی با یک خط تولید در این است که پژوهشگر میپرسد «آیا مدل میتواند کار کند؟»، اما مهندس MLOps میپرسد «آیا مدل در سختافزارهای مختلف، جمعیتهای متنوع کاربر و در برابر تغییرات دادهها بهطور مستمر کار میکند؟». یادگیری آماری، نمونههای محدود را به ادعاهایی درباره دادههای آینده تبدیل میکند. بنابراین، مفاهیمی مثل تقسیم دادهها (Splitting)، بهینهسازی، منظمسازی (Regularization) — که مثل گذاشتن ترمز برای جلوگیری از لغزش ماشین در پیچهای تند است — معیارها و نظارت، دیگر تکنیکهای جداگانه در کتابهای درسی نیستند، بلکه بخشی از یک مسئلهٔ واحد برای تعمیمپذیری مدل هستند.
این تغییر دیدگاه با افزایش قابلیتهای چندوجهی (Multimodal) — مدلهایی که مثل انسان همزمان متن، عکس و صدا را میفهمند — گسترش پنجرههای متنی، افزایش محاسبات زمان اجرا، دسترسی گستردهتر به ابزارها و ارتباطات عمیقتر با تصمیمات سازمانی، حیاتیتر شده است. در این شرایط، جزئیاتی که زمانی پژوهشی به نظر میرسیدند، اکنون تعیینکنندهٔ تأخیر، امنیت، دسترسیپذیری، هزینههای محیطی، کیفیت محصول و مسئولیتهای قانونی هستند. برای بهینهسازی این هزینهها در مرحله استنتاج، تکنیکهایی مانند کوانتایزیشن برای کاهش هزینههای عملیاتی بدون حذف پارامترهای مدل به ابزارهای کلیدی MLOps تبدیل شدهاند.
نقشهٔ عملیاتی MLOps
به نقل از راهنمای unite.ai، یک سیستم MLOps کارآمد، ورودیها را از طریق پنج عملیات مشاهدهپذیر به نتایج تبدیل میکند. این نمودار به عنوان یک نقشه علی (Causal Map) فشرده عمل میکند. اگرچه برخی سیستمها مراحل را ترکیب کرده یا آنها را در یک حلقه تکرار میکنند، اما این نقشه اجبار میکند که هر تغییر در اطلاعات یا سطح دسترسی، یک مالک، یک ورودی، یک خروجی و یک تست داشته باشد:
۱. نسخهبندی دادهها، کد، محیطها و مدلها: این زیربنای کار است. شما باید نه تنها کد، بلکه وضعیت دقیق دادهها و محیط اجرا را ثبت کنید. سؤال مفید این نیست که آیا این عملیات رخ داده است یا خیر، بلکه این است که چه اطلاعاتی مصرف شده، چه وضعیتی تغییر کرده و چه شواهدی ثابت میکند که این تغییر معتبر بوده است. این امر به بازبینیکننده اجازه میدهد نتایج را تحت همان شرایط بازتولید کند و فرآیند را از یک استقرار سادهٔ API متمایز سازد. این تحویل با هدف تعیینشده شروع شده و با نتیجهای پایان مییابد که از خط لولههای خودکار پشتیبانی کند. تیمها باید عدم قطعیتها، جایگزینهای رد شده، منابع مصرفی و هرگونه کنترل انسانی یا نرمافزاری اعمال شده در مرزها را ثبت کنند.
۲. اتوماسیون خطوط لولهٔ آموزش و اعتبارسنجی: اتوماسیون در اینجا برای سرعت نیست، بلکه برای ایجاد مسیری تکرارپذیر از ورودیهای نسخهبندی شده به یک مدل اعتبارسنجشده است. سیستم باید این خط لولهها را خودکار کند تا تضمین شود انتقال از مرحله نسخهبندی بدون نقص است. یک بازبینیکننده باید بتواند نتیجه را تحت همان شرایط اعلامشده بازتولید کند. این مرحله با نتیجهای پایان مییابد که ثبت مصنوعات تأییدشده و تبار (Lineage) را ممکن سازد. ثبت ردپای مصرف منابع و جایگزینهای رد شده به تیمها کمک میکند تشخیص دهند که آیا اتوماسیون صرفاً در حال ارسال سریعتر دادههای بد است یا خیر. در برخی رویکردهای نوین، برای تسهیل این فرآیند، آموزش شبکههای عصبی صنعتی حتی به محیط مرورگر منتقل شده است تا دسترسی به ابزارهای اعتبارسنجی سریعتر شود.
۳. ثبت مصنوعات تأییدشده و تبار (Lineage): شما نمیتوانید چیزی را که ردیابی نمیکنید، مستقر کنید. این مرحله شامل ثبت مدلهای تأییدشده و تبار آنهاست؛ یعنی بدانید دقیقاً کدام مجموعه داده و کدام ابرپارامتر (Hyperparameter) منجر به تولید یک مصنوع خاص شده است. این همان تبدیل متمایز در MLOps است. این تحویل با خط لولههای خودکار شروع شده و با نتیجهای پایان مییابد که استقرار با قابلیت بازگشت و انتشار مرحلهای را پشتیبانی کند. بدون این ثبت، سیستم فاقد شواهدی است که ثابت کند یک تغییر معتبر بوده است.
۴. استقرار با قابلیت بازگشت (Rollback) و انتشار مرحلهای: استقرار، مرزِ تأیید است. استفاده از روشهای Canary (انتشار برای بخش کوچکی از ترافیک) یا استقرار مرحلهای اجازه میدهد مدل پیش از لانچ کامل تست شود. نکته حیاتی این است که سیستم باید در صورت افت عملکرد، از بازگشت فوری (Rollback) پشتیبانی کند. این مرحله با مصنوعات ثبتشده شروع شده و با نتیجهای پایان مییابد که نظارت بر سرویس، دادهها و رفتار مدل را ممکن سازد. این مرحله به عنوان مرز محدودکننده و تأییدکننده عمل میکند.
۵. نظارت بر سرویس، دادهها و رفتار مدل: حلقه با نظارت بسته میشود. این فقط چک کردنِ فعال بودن سرور نیست، بلکه نظارت بر تغییر توزیع دادهها (Data Drift) و زوال مدل است. این بازخورد تعیین میکند که چه زمانی مدل نیاز به بازآموزی دارد یا باید از محیط عملیاتی حذف شود. این مرحله با استقرار شروع شده و با نتیجهای پایان مییابد که نظارت بیشتر یا یک تصمیم نهایی را پشتیبانی کند. این مرحله خروجی، بازخورد و قانون توقف (Stop Rule) سیستم را فراهم میکند.
تحلیل نقشه
برای استفادهٔ مؤثر از این نقشه، آن را برای درک تولید «رو به جلو» و برای تشخیص خطا «رو به عقب» بخوانید. تحلیل رو به جلو میپرسد که هر مرحله چگونه مرحله بعدی را تغذیه میکند. تحلیل معکوس از یک نتیجهٔ نادرست، کند، گران یا ناامن شروع میکند و ردیابی میکند که کدام فرض در مراحل ابتدایی اجازه داده این نتیجه رخ دهد. اغلب، مسیر معکوس فاش میکند که خطای تصمیمساز، مدتها پیش از آنکه مدل اولین خروجی را تولید کند، رخ داده است.
MLOps در برابر میانبر DevOps
بسیاری از سازمانها به اشتباه MLOps را «اعمال DevOps روی یک API» میبینند. این میانبر، چرخهٔ حیات داده و مدل را کاملاً نادیده میگیرد. در حالی که این دو ویژگیهای ظاهری مشترکی دارند، اما داستانهای علی آنها متفاوت است: شواهد متفاوتی موفقیت را ثابت میکند، منابع متفاوتی هزینهها را تعیین میکند و کنترلهای متفاوتی از آسیب جلوگیری میکند.
در DevOps استاندارد، کد متغیر اصلی است. اما در MLOps، داده یک متغیر زنده است. اگر چرخهٔ حیات داده را نادیده بگیرید، اتوماسیون شما به یک ریسک تبدیل میشود. در نهایت سیگنالهای غلط را رصد میکنید و محصولات ناهمسان را با هم مقایسه میکنید که منجر به ناپایداری سیستمیک میشود. این مرز، عملیاتی است نه اصطلاحی.
مقایسه دقیق MLOps و میانبر DevOps:
- تغییر محوری: MLOps یک تبدیل و نتیجهٔ قابل اندازهگیری را حفظ میکند؛ میانبر این مرز را حذف میکند.
- خروجی مورد اندازهگیری: MLOps بر چرخهٔ حیات مدل و داده متمرکز است؛ میانبر فقط روی API تمرکز دارد.
- ریسک اصلی: میانبر اجازه میدهد اتوماسیون دادههای بد یا مدلهای معیوب را سریعتر منتشر کند زیرا گیتهای کنترلی لازم را ندارد.
- واحد تحلیل: در حالی که یک مقاله ممکن است یک الگوریتم را ایزوله کند، یک سرویس مستقر شامل بازیابی (Retrieval)، مسیریابی، کش، سیاستها، هویت، رابطهای کاربری و نظارت است.
پیادهسازی ارزیابی سختگیرانه
برای فرار از «تلهٔ دمو»، تیمها باید از یک مثال عملی استفاده کنند؛ مثلاً پیشبینی تقاضایی که ماهانه بازآموزی میشود، تستهای داده و عملکرد را پاس میکند، به صورت Canary مستقر میشود و در صورت بروز Drift بازمیگردد. یک تست سختگیرانه شامل ساخت موارد عادی، دشوار و عمداً گمراهکننده پیرامون این سناریو است، در حالی که یک خط پایه (Baseline) بدون آن تکنیک حفظ شده و هم عملکرد متوسط و هم شدت شکستهای فردی ثبت شود.
برای تست بیشتر مکانیزم، یک فرض را تغییر دهید: یک ورودی ضروری را حذف کنید، یک سیگنال متناقض وارد کنید، محاسبات را محدود کنید، جمعیت کاربران را تغییر دهید یا سیستم را مجبور به خودداری (Abstain) از پاسخ کنید. مکانیزمی که فقط در یک دموی مرتبشده موفق است، ثابت نکرده است که به محیط عملیاتی تعمیم مییابد.
برنامهٔ ارزیابی باید شامل موارد زیر باشد:
- تعریف تصمیم: تصمیمی را که شواهد باید از آن حمایت کنند، بنویسید. جمعیت عملیاتی، پیامد یک نتیجهٔ غلط و سادهترین جایگزین معتبر را تعریف کنید.
- مقایسههای کنترلشده: استفاده از یک مجموعه دادهٔ آزمون دستنخورده برای ارزیابی آفلاین تا نسخهها با هم قابل مقایسه باشند.
- محیط عملیاتی: استفاده از حالت Shadow، Canary یا محدودیت نرخ (Rate Limits) برای دیدن اینکه ترافیک واقعی، حلقههای بازخورد و انسانها چگونه رفتار را تغییر میدهند.
- شرایط توقف: تعیین شرط صریح برای توقف انتشار، به جای فرض اینکه هر بهبودی لایق انتشار کامل است.
- نسخهبندی تبار: نسخهبندی تمام ورودیها: دادههای منبع، پیشپردازش، توکنساز/انکودر، وزنهای مدل، پیکربندی، پرامپت/سیاست، ایندکس بازیابی، مجموعه ارزیابی، فرضهای سختافزاری و کد سرویسدهی.
هزینهٔ شکست
شکست در MLOps فقط یک باگ نیست، بلکه اغلب یک تخریب خاموش کیفیت است. این میتواند خود را در افزایش تأخیر، آسیبپذیریهای امنیتی یا مسائل مربوط به مسئولیت قانونی نشان دهد. محدودیت مرکزی این است که اتوماسیون میتواند دادهها یا مدلهای بد را سریعتر منتشر کند، مگر اینکه گیتها معیارهای پذیرش واقعی را کدگذاری کنند.
این شکست باید کل فرآیند را از ابتدا شکل دهد: جمعآوری دادهها، معماری، دسترسیها، ارزیابی، گیتهای انتشار و نظارت. کنترلها با ترتیب خاصی همگام با حرکت سیستم به سمت پیامدهای دنیای واقعی اجرا میشوند:
۰۱. حفظ تست $\rightarrow$ ۰۲. آموزش مدل $\rightarrow$ ۰۳. اعتبارسنجی انتخابها $\rightarrow$ ۰۴. اندازهگیری بخشها $\rightarrow$ ۰۵. نظارت بر Drift
یک کنترل تنها زمانی مفید است که پیش از یک پیامد گران یا برگشتناپذیر عمل کند. تیمها باید زودترین پیشنشانههای مشاهدهپذیر شکست را شناسایی کرده، آستانهای تعیین کنند، یک مالک مسئول اختصاص دهند و بازیابی را تست کنند. بازیابی ممکن است به معنای خودداری از پاسخ، بازگشت به یک سیستم سادهتر، درخواست شواهد بیشتر، ارجاع به انسان، بازگرداندن مدل یا توقف کامل یک اقدام باشد.
تحلیل راهبردی
برای متخصصان، این به معنای تغییر تعریف موفقیت است. «هوشمندتر بودن» یک معیار پذیرش برای MLOps نیست. در عوض، موفقیت با تصمیمات و اندازهگیریها سنجیده میشود:
- نرخ خطا در موارد دشوار.
- سرعت بازیابی پس از دریافت شواهد متناقض.
- هزینه در یک صدک خاص از ترافیک.
- زمان بازبینی انسانی و کالیبراسیون.
- درصد اقداماتی که در محدودهٔ اختیارات تعریفشده باقی ماندهاند.
این نظم، شواهد را قابل انتقال میکند. وقتی تیمی از چارچوب استاندارد MLOps استفاده میکند، تیم دیگر میتواند قضاوت کند که آیا این دستاوردها در صورت تغییر سختافزار، زبان یا تحمل ریسک، باقی میمانند یا خیر. این رویکرد، هوش مصنوعی را از یک «صنعت دستی» مبتنی بر شهود، به یک «نظم مهندسی» مبتنی بر شواهد تبدیل میکند. به جای فشرده کردن هر نتیجه در یک میانگین، توزیعها، دستههای شکست، تأخیرهای دم (Tail Latency)، مصرف منابع و زیرگروههای آسیبدیده را گزارش کنید.
پرسشهایی پیش از پذیرش MLOps
تیمها باید پیش از پذیرش به این سؤالات پاسخ دهند تا مطمئن شوند فقط یک برچسب را نپذیرفتهاند:
- هدف: MLOps قرار است کدام گلوگاه قابل اندازهگیری را حل کند؟
- مکانیزم: کدام یک از ۵ مرحله حاوی تغییر متمایز است؟
- خط پایه: این روش در برابر DevOps ساده یا جایگزینهای دیگر چه وضعیتی دارد؟
- شواهد: کدام موارد عادی، دشوار، خصمانه و زیرگروهها تست شدهاند؟
- عملیات: هزینههای تأخیر، حافظه، محاسبات، انرژی، نگهداری و بازبینی در مقیاس بالا چقدر است؟
- ریسک: تیم چگونه متوجه میشود که اتوماسیون در حال پخش دادههای بد است؟
- بازیابی: آیا سیستم میتواند پیش از ایجاد آسیب، از پاسخ دادن خودداری، بازگشت یا ارجاع دهد؟
بر اساس مستندات منابعی مانند راهنمای انتخاب مدل scikit-learn، قوانین ML گوگل و NIST AI RMF، نقاط شروع معتبری برای این مسیر هستند. اینها باید در کنار مستندات مربوط به مدل، مجموعه داده، سختافزار و حوزه قانونی مربوطه خوانده شوند. یک منبع کلی میتواند مکانیزم را تعریف کند، اما فقط شواهدِ مربوط به استقرار واقعی است که مناسب بودن یک سیستم را ثابت میکند.
MLOps یک مکانیزم تعریفشده در یک سیستم اجتماعی-فنی بزرگتر است. ارزش آن از بهبود یک نتیجه خاص تحت شرایط صریح میآید، نه از خودِ برچسب. قانون عملی این است: هدف را تعریف کنید، با یک خط پایه معتبر مقایسه کنید، شکستی را که بیشترین اهمیت را دارد تست کنید و شواهد لازم برای نظارت بر تغییر را حفظ کنید. بدون این قطعات، MLOps تنها یک نام امیدوارکننده است که به یک ریسک عملیاتی ناشناخته متصل شده است.
گام بعدی شما
- بررسی کنید آیا در خط لولهٔ فعلی شما، گیتهای پذیرش (Acceptance Criteria) بهصورت کدگذاریشده وجود دارند یا بر اساس شهود انسانی هستند.
- یک «تحلیل معکوس» روی آخرین شکست مدل خود در محیط عملیاتی انجام دهید تا ببینید خطا در کدام یک از ۵ مرحلهٔ نقشه رخ داده است.
- برای مدلهای حساس، استقرار را از حالت مستقیم به حالت Canary یا Shadow تغییر دهید تا اثر ترافیک واقعی را پیش از لانچ کامل بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو