اگر امروز برای استقرار مدلهای کدنویسی بودجه تخصیص میدهید، باید بدانید که هزینه آموزش مدلهای سطح بالا در حال سقوط است. مدل Qwen3.8-Flash-Next نتایجی برتر در کدنویسی و کارهای اداری ارائه میدهد، در حالی که هزینه آموزش آن تنها یکنهم مدل پیشین یعنی Qwen3.7-Plus است.
طبق اعلام شرکت علیبابا در ۲۶ اوت ۲۰۲۶، این مدل چندوجهی (Multimodal) — شبیه انسانی که همزمان متن، عکس و صدا را میفهمد — از معماری ترکیب خبرهها (Mixture of Experts) استفاده میکند و پیشنمایشی از ساختار Qwen4 است. این رویکرد در راستای استراتژی جدید این شرکت است که بهینهسازی شدید استنتاج را هدف اصلی معرفی مدلهای جدید قرار داده است.
این عرضه در حالی رخ میدهد که آزمایشگاههای هوش مصنوعی از تعقیب اندازه پارامترها به سمت «بهرهوری نهایی هزینه» حرکت کردهاند. در حالی که مدلهای پرچمداری مثل Qwen3.8-Max برای بالاترین سطح عملکرد طراحی شدهاند، نسخه Flash-Next قصد دارد قابلیتهای نزدیک به پرچمدار را با هزینهای ناچیز فراهم کند. این در حالی است که مدل Qwen3.8-Max با ۲.۴ تریلیون پارامتر به عنوان قدرتمندترین نسخه برای کارهای پیچیده عرضه شده بود. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی مدلهای بازمتن اشاره کردیم، کاهش هزینه استنتاج اکنون اولویت اول صنعت است.
جزئیات معماری
علیبابا روی «هوش پراکنده» تمرکز کرده است. این تیم ثابت کرد که با فعال کردن بخش کوچکی از مغز مدل برای هر کلمه، میتوان کیفیت خروجی را در حوزههایی مثل مهندسی نرمافزار بالا برد.
این رویکرد مستقیماً مدلهای بزرگتر را به چالش میکشد. برای مقایسه، مدل Qwen3.7-Plus دارای ۳۹۷ میلیارد پارامتر است که ۱۷ میلیارد از آنها برای هر توکن فعال میشوند؛ یعنی تقریباً سه برابر مدل Flash-Next.
بهرهوری این مدل از یک طراحی ترکیبی میآید. مدل در مجموع ۱۲۵ میلیارد پارامتر دارد اما برای هر توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک — تنها ۶ میلیارد پارامتر را فعال میکند. نوآوری اصلی، لایه بردار معنایی (Embedding) با ۵۱ میلیارد پارامتر است که مثل یک «دیکشنری عبارات» برای گروههای رایج کلمات عمل میکند.
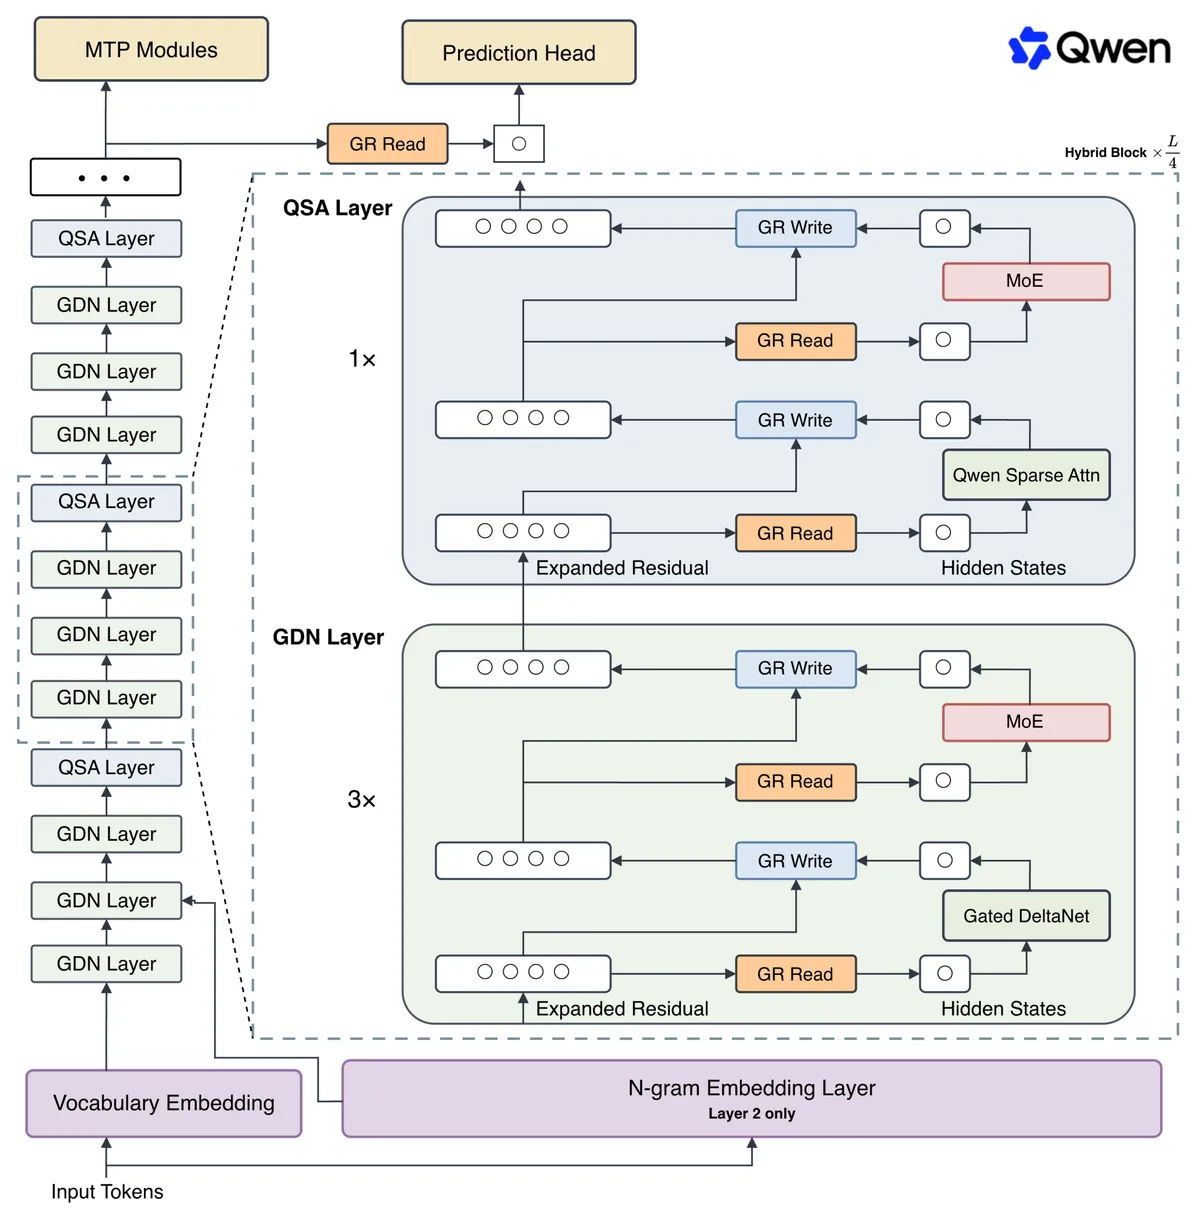
بر اساس مستندات فنی، این لایه برخلاف لایههای استاندارد، در رم سیستم قرار میگیرد نه در حافظه گرانقیمت GPU (واحد پردازش گرافیکی). این لایه اطلاعات سطح عبارت را با هزینه کم به ابتدای شبکه میفرستد. همچنین مدل از پنجره زمینه (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جای چند ورق دارد — با اندازه ۲۶۲,۱۴۴ توکن پشتیبانی میکند که با استفاده از YaRN تا یک میلیون توکن قابل گسترش است.
تحلیل عملکرد
به نقل از گزارش فنی تیم Qwen در گیتهاب، این مدل در گردشهای کاری عاملمحور (Agentic) — یعنی وقتی هوش مصنوعی باید مستقل باگها را در پروژههای واقعی پیدا و رفع کند — درخشان ظاهر شده است:
- کدنویسی: امتیاز ۵۸.۷ در DeepSWE و ۶۲.۵ در SWE-bench Pro را کسب کرد و از DeepSeek-V4-Flash و Claude Opus 4.6 (Max) پیشی گرفت.
- بهرهوری: در CoWorkBench به امتیاز ۷۳.۹ رسید که بهطور قابلتوجهی بالاتر از ۴۵.۱ مدل DeepSeek است.
- جریانهای کاری حرفهای: امتیاز ۵۵.۷ در JobBench را به دست آورد که تقریباً دو برابر امتیاز ۲۷.۶ مدل Qwen3.7-Plus است.
- هوش عمومی: امتیاز ۸۱.۳ در IFBench و ۵۱.۲ در Agents' Last Exam ثبت کرد.
در استدلال علمی رقابت نزدیک است. در محک GPQA Diamond، مدل Flash-Next امتیاز ۹۱.۷ و در LiveCodeBench v6 امتیاز ۹۱.۹ را گرفت. با این حال، Claude Opus 4.6 همچنان در آزمون «آخرین امتحان بشریت» پیشتاز است.
برای کاربر تجاری، این یعنی کاهش شدید قیمت. نسخه تولیدی یعنی Qwen3.8-Flash با قیمت ۰.۱۶ دلار برای هر میلیون توکن ورودی و ۰.۴۷ دلار برای هر میلیون توکن خروجی عرضه شده است. این قیمت تقریباً ۱۲ برابر ارزانتر از پرچمدار Qwen3.8-Max است.
این استراتژی فشار شدیدی به OpenAI و Anthropic وارد میکند. OpenAI پیش از این با تخفیفهای شدید در خط GPT-5.6 واکنش نشان داد تا از مهاجرت توسعهدهندگان به مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده — جلوگیری کند.
در حالی که رشد درآمد ارائهدهندگان هوش مصنوعی به دلیل این جنگ قیمتی کند میشود، کاربر نهایی برنده است. کدنویسی عاملمحور با کارایی بالا، از یک سرویس لوکس به یک کالای عمومی تبدیل میشود.
توسعهدهندگان اکنون میتوانند وزنهای مدل را در Hugging Face و ModelScope برای تست محلی دریافت کنند.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای اتوماسیون کدنویسی استفاده میکنید، مدل Qwen3.8-Flash را جایگزین کنید تا هزینههایتان تا ۹۰٪ کم شود.
- معماری N-gram embedding را در پروژههای بهینهسازی حافظه بررسی کنید.
- مدل را روی سختافزارهای محلی تست کنید تا سرعت استنتاج در محیطهای بسته را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو