
تصور کنید به جای سالها آزمون و خطا در آزمایشگاه، یک مدل هوش مصنوعی در چند ساعت دهها کاندیدای مولکولی تولید کند که واقعاً در دنیای فیزیکی کار میکنند. این دیگر یک پیشبینی شبیهسازیشده نیست، بلکه واقعیتی است که در لولههای آزمایش تأیید شده است.
به نقل از گزارش منتشر شده در ۲۳ اوت ۲۰۲۶، مدلهای Claude موفق شدند برای ۱۴ هدف از ۱۵ هدف تعیینشده، پروتئینهای پیونددهنده (Protein Binders) فعال طراحی کنند. در دنیای طراحی پروتئین، هدف ساخت مولکولی است که به یک هدف خاص بچسبد؛ فرآیندی که معمولاً به دلیل پیچیدگی، بسیار کند و هزینهبر است. این دستاورد در ادامه پیشرفتهای اخیر آنتروپیک است که نرخ موفقیت مدلهای Claude در طراحی پروتئینهای De Novo را به سطح جدیدی رسانده است.
همانطور که در تحلیلهای قبلی ما دربارهی کاربرد مدلهای زبانی در علوم سخت اشاره کردیم، تفاوت میان «تولید محتوا» و «کشف علمی» در قابلیت تأیید است. مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در اینجا نه به عنوان یک پاسخدهنده، بلکه به عنوان یک موتور تولید کاندیدا عمل کردهاند. در این راستا، پرسش بنیادین این است که آیا مدلهای پیشرو واقعاً قادر به استخراج ایدههای نو از مراجع پژوهشی هستند یا صرفاً الگوهای موجود را بازتولید میکنند.
بستر اعتبارسنجی
این دستاورد مشابه الگوی مشاهده شده در اثباتهای ریاضی Astra است؛ جایی که مدل گامهای اولیه را میزند و یک هسته سختافزاری یا نرمافزاری (مانند Lean) صحت آن را تأیید میکند. در اینجا، نقش مدل این نیست که هر بار کاملاً درست باشد، بلکه باید آنقدر بهرهور باشد که سیل عظیمی از گزینهها را برای یک تأییدکنندهٔ قابلاعتماد تولید کند.
برای تأیید این نتایج، Anthropic با شرکتهای Adaptyv Bio و Twist Bioscience همکاری کرد. این شرکا طرحهای هوش مصنوعی را به صورت فیزیکی سنتز کرده و با واکنشگرهای واقعی در یک آزمایشگاه تر (Wet Lab) آزمایش کردند. این یعنی نتایج صرفاً امتیازاتی «محتمل» از یک مدل دیگر نیستند، بلکه واقعیتهای فیزیکی هستند؛ هوش مصنوعی پیشنهاد داد و آزمایشگاه حکم نهایی را صادر کرد. این رویکرد سنتز فیزیکی یادآور موفقیت دانشمندان استنفورد در طراحی ویروسهایی با AI است که توانستند باکتریها را در محیط واقعی نابود کنند.
شکاف عملکردی
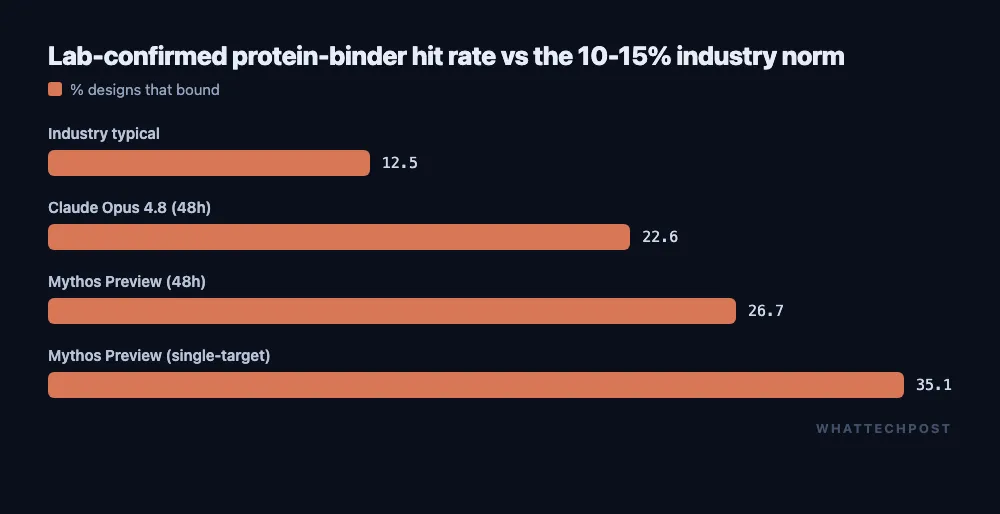
بر اساس مستندات منتشر شده، از میان ۱,۳۲۰ طرح، ۳۵۴ پیونددهنده فعال تأیید شد. این دادهها جهشی قابلتوجه نسبت به روشهای سنتی را نشان میدهد:
- نرخ موفقیت کلی: ۲۲ تا ۲۷ درصد در کمپینهای ۴۸ ساعته (در مقابل استاندارد صنعتی ۱۰ تا ۱۵ درصد).
- اهداف متمرکز: موفقیت تا ۳۵ درصد در زمان تمرکز مدل روی یک هدف واحد.
- هدف RBX1: مدل Claude به نرخ موفقیت ۴۰ درصد رسید، در حالی که رقبای انسانی تنها ۳.۷ درصد موفق بودند.
جزئیات فنی و دادهها
علاوه بر طراحی پروتئین، آنتروپیک نشان داد که Claude میتواند دادههای خام NMR و دادههای شیمی آزمایشگاهی را پردازش کند. طبق گزارش این شرکت، خوانشهای خلوص مدل در محدوده ۰.۱ درصد با ابزارهای فیزیکی آزمایشگاه تفاوت داشت. این سطح از دقت، یک معیار قابلسنجش ارائه میدهد و از ادعاهای مبهم درباره «عالی بودن در علم» فاصله میگیرد.
این موفقیت یک الگوی حیاتی برای پیادهسازی AI را آشکار میکند: «تولید» میتواند مصرفی و یکبارمصرف باشد، اما «تأییدکننده» باید مطلق و بیخطا باشد. در این گردشِ کار، مدل در ۹۶ درصد مواقع اشتباه میکرد؛ اما چون بررسی آزمایشگاهی قابلاعتماد و در مقایسه با دستاورد نهایی ارزان بود، سیستم در نهایت پیروز شد.
برای توسعهدهندگان نرمافزار، این یک تغییر بنیادین در رویکرد است. به جای صرف ساعتها وقت برای مهندسی پرامپت (Prompt Engineering) — که شبیه هنر سؤال درست پرسیدن از یک مشاور باتجربه است — برای رسیدن به اولین پاسخ کامل، ارزش واقعی در ساخت یک بررسیکننده مکانیکی است که خروجی فعال را از خروجی «شبیه به فعال» جدا کند. نمونههایی از این ابزارها عبارتاند از:
- تستهای ویژگی (Property tests)
- بررسیکنندههای نوع (Type checkers)
- شبیهسازها
- مقایسه (Diff) با رفتارهای تاییدشده
اگر تنها راه شما برای تأیید کدِ هوش مصنوعی، خواندن آن توسط یک انسان است، کندترین نسخهٔ ممکن از این چرخه را اجرا میکنید. هدف، ساخت سیستمی است که آنقدر قابلاعتماد باشد که دیگر نیازی به خواندن خروجی برای اطمینان از کارکرد آن نباشد.
گام بعدی شما
- اگر از AI برای تولید کد یا داده استفاده میکنید، تمرکز خود را از «بهبود پرامپت» به «ساخت سیستمهای تأیید خودکار» منتقل کنید.
- ابزارهای تست واحد (Unit Test) و شبیهسازها را به عنوان فیلترهای خروجی مدل در خط لوله (Pipeline) خود قرار دهید.
- منتظر بمانید و ببینید آیا آزمایشگاههای دیگر نیز ادعاهای «پشتیبانیشده با آزمایش» (Assay-backed) جایگزین نمرات بنچمارک میشوند یا خیر.
این تنها آغاز ماجراست؛ اثر موجگونهی این رویکرد بر اعتبار مدلهای استدلالی را در گزارش بعدی بررسی خواهیم کرد.



گفتگو