
تصور کنید ابزاری دارید که تمام منابع یک مقاله علمی را میبیند، اما نمیتواند حدس بزند نویسنده از این منابع چه نتیجهی جدیدی گرفته است. این دقیقاً همان نقطهضعفی است که مدلهای پیشرو در مواجهه با خلاقیت انسانی تجربه میکنند. مدلهای پیشرو در بازتولید جهش خلاقانه محوری پژوهشگران انسانی شکست میخورند و در محک بازسازی نمرات بسیار پایینی کسب میکنند.
طبق گزارشی که در ۲۳ اوت ۲۰۲۶ منتشر شد، مدلهای پیشرو در محک بازسازی (Reconstruction Benchmark) تنها بین ۳٪ تا ۱۵٪ موفق شدند. این مطالعه نشان میدهد در حالی که مدلها میتوانند دادههای موجود را پردازش کنند، اما در ابداع ارتباطات نوینی که تعریفکننده پژوهشهای علمی اصیل است، دچار مشکل هستند. این یافته در حالی منتشر میشود که بسیاری از ادعاهای «هوش مصنوعی برای علم» — مانند طراحی پروتئینها یا تسلط بر جدولهای پیشرو در کدنویسی — بهدلیل نشت داده (Data Leakage) بیش از حد بزرگنمایی شدهاند؛ یعنی مدلها پیشتر مقالاتی را که مورد آزمایش قرار میگیرند، در دادههای آموزشی خود دیدهاند.
برای جلوگیری از این خطا، این محک بهطور خاص از نقاط زمانی سختگیرانه و شناسههای ناشناس استفاده کرده تا اطمینان حاصل شود اثر مورد نظر، پس از پایان آموزش مدل نوشته شده است. این رویکرد یادآور متدولوژیهای پیچیده برای استخراج دقیق تاریخ قطع دانش است که برای شناسایی مرزهای اطلاعاتی مدلها به کار میروند. همانطور که در تحلیلهای پیشین ما دربارهی امنیت و اعتبار مدلهای زبانی اشاره کردیم، تفکیک میان «تکرار داده» و «استدلال واقعی» سختترین چالش فعلی است. برای تضمین عدالت در این آزمون، سازندگان از سه مکانیزم سختگیرانه استفاده کردند:
- نقاط زمانی قطع: آثار هدف دقیقاً پس از بازه زمانی آموزش مدلها منتشر شدهاند تا دسترسی پیشین مدل به آنها غیرممکن باشد.
- ایزولاسیون اطلاعات: بذر اولیه (Seed) بهطور کامل از نتیجه نهایی هدف جدا شده است.
- کتابشناسیهای منجمد: مدلها فقط به همان منابع دقیقی دسترسی داشتند که پژوهشگر اصلی در زمان نوشتن مقاله در اختیار داشت.
به نقل از تحلیلهای فنی dev.to، این محک ۷ مدل پیشرو را روی ۶۴۳ مقاله در حوزههای یادگیری ماشین و پنج قلمرو علمی خانواده Nature آزمایش کرد. وظیفه مدلها این بود که تنها با استفاده از کتابشناسی موجود پیش از نگارش مقاله، سهم اصلی مقاله در پیشبرد علم را استنتاج کنند. این آزمون بررسی میکند که آیا یک مدل میتواند همان ارتباط نوآورانهای را تولید کند که یک پژوهشگر واقعی با استفاده از مواد اولیه یکسان پیدا کرده است یا خیر.
نتایج نشان داد که تفاوت فاحشی میان مدلهای تکنفره و سامانههای سازمانیافته وجود دارد. در رویکرد سامانه چندعاملی (Multi-Agent System) که از یک خط لوله «فقط-مرجع» (Reference-only) بدون اجازه جستوجوی وب استفاده میکرد و در آن ساختار «تورنمنت سوئیسی» برای بررسی فرضیات کاندید و بازبینی متقاطع بین مدلها به کار گرفته میشد، نتایج تغییر کرد:
- مدلهای تکنفره: نرخ تطابق ناچیزی بین ۳٪ تا ۱۵٪ داشتند.
- خط لولههای چندعاملی: نرخ موفقیت در ۶ حوزه مختلف به ۲۳ تا ۴۲٪ رسید.
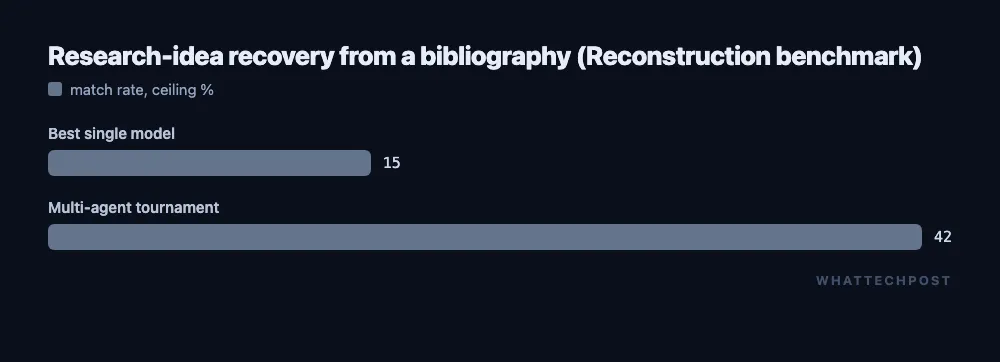
این جهش ۲.۴ برابری نسبت به بهترین مدل تکنفره نشان میدهد که یک «هارنس» یا ساختار سازمانیافته میتواند قابلیتهایی را استخراج کند که مدل بهتنهایی قادر به بیان آنها نیست. این نتیجه، بهجای تکیه بر «حس کلی»، یک عدد concrete و ملموس به تز سامانههای چندعاملی اضافه میکند. با این حال، واقعیت تلخ این است که سقف موفقیت در اینجا ۴۲٪ است. یعنی حتی با سازماندهی پیشرفته، این سامانهها اکثریت ایدههای پژوهشی را که دانشمندان واقعی از منابع یکسان استخراج کردهاند، گم میکنند. سازماندهی چندعاملی یک ضربکننده معنادار روی یک پایه پایین است، اما حلال جادویی برای سنتز اصیل و نوآوری واقعی نیست.
برای متخصصان فنی، این داده مرز فعلی توانمندیهای AI را روشن میکند. مدلها در تولید و تأیید پاسخهایی که راه حلشان پیشتر در دادههای آموزشی وجود داشته، «ابرانسانی» هستند، اما در سنتز اصیل — یعنی عمل ابداع ارتباطی که هنوز به صورت مکتوب در نیامده است — همچنان ضعیفاند. در این راستا، بررسی نحوه نفوذ مدلهای کوچک به زنجیره تفکر مدلهای پیشرو نشان میدهد که حتی در لایههای استدلالی، مرز میان بازتولید و تفکر واقعی همچنان مبهم است.
این تمایز، نحوه تفویض وظایف را تغییر میدهد. اگر پروژه شما نیاز به یافتن یا بررسی یک پاسخ موجود دارد، هوش مصنوعی ابزار اصلی است. اما اگر کار شما ابداع راه حلی از سیگنالهای پراکنده است، باید با AI بهمثابه یک شریک برای طوفان فکری برخورد کنید، نه یک پژوهشگر مستقل. این پرسش که آیا تورنمنتهای چندعاملی در نهایت میتوانند این سقف ۴۲ درصدی را به سطح برابری با انسان برسانند یا خیر، همچنان یک سوال باز است. دادههای فعلی نشان میدهد که سازماندهی یک ضربکننده است، اما نه راهکاری جادویی برای مسئله نوآوری واقعی.
برای متخصصان فنی، این داده مرز فعلی توانمندیهای AI را روشن میکند. مدلها در تولید و تأیید پاسخهایی که راه حلشان پیشتر در دادههای آموزشی وجود داشته، «ابرانسانی» هستند، اما در سنتز اصیل — یعنی عمل ابداع ارتباطی که هنوز به صورت مکتوب در نیامده است — همچنان ضعیفاند.
این تمایز، نحوه تفویض وظایف را تغییر میدهد. اگر پروژه شما نیاز به یافتن یا بررسی یک پاسخ موجود دارد، هوش مصنوعی ابزار اصلی است. اما اگر کار شما ابداع راه حلی از سیگنالهای پراکنده است، باید با AI بهمثابه یک شریک برای طوفان فکری برخورد کنید، نه یک پژوهشگر مستقل. این پرسش که آیا تورنمنتهای چندعاملی در نهایت میتوانند این سقف ۴۲ درصدی را به سطح برابری با انسان برسانند یا خیر، همچنان یک سوال باز است. دادههای فعلی نشان میدهد که سازماندهی یک ضربکننده است، اما نه راهکاری جادویی برای مسئله نوآوری واقعی.
گام بعدی شما
- در پروژههای پژوهشی، از مدلهای زبانی برای «خلاصهسازی» استفاده کنید، اما برای «استنتاج ایدههای نو» هرگز روی خروجی تکمدلی تکیه نکنید.
- اگر توسعهدهنده هستید، برای کارهای پیچیده استدلالی، بهجای تک-پرامپت، از معماریهای چندعاملی با مکانیزم بازبینی متقاطع (Cross-Review) استفاده کنید.
- نتایج این محک را با ادعاهای شرکتهای بزرگ درباره «کشف دارو» یا «اثبات ریاضی» مقایسه کنید تا میزان نشت داده در ادعاهای آنها را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو