تصور کنید در تیمی هستید که در آن یک همکار دیجیتال، هر چهار پروژه از هر ده پروژه را بدون نیاز به راهنمایی لحظهای پیش میبرد. این دیگر یک سناریوی تخیلی نیست، بلکه واقعیت فعلی در آزمایشگاههای آنتروپیک است.
طبق گزارشی که در ۱۸ سپتامبر ۲۰۲۶ منتشر شد، مدل کلود (Claude) اکنون ۲۶ درصد از کارهای پژوهشی در آنتروپیک (Anthropic) را «پیش میبرد». این رقم جهشی خیرهکننده نسبت به فوریه ۲۰۲۶ است؛ زمانی که کمتر از یک درصد از وظایف به این سطح از خودکارسازی رسیده بود.
این افشاگری درست زمانی رخ میدهد که داریو آمودئی (Dario Amodei)، مدیرعامل شرکت، از کل صنعت میخواهد سرعت توسعه مدلهای پیشرو را بهصورت هماهنگ کاهش دهند. آنتروپیک برای توجیه این درخواست، معیارهای داخلی خود را به اشتراک گذاشته تا نشان دهد مدلها دقیقاً چگونه ساخته میشوند و در کجای مسیر رسیدن به استقلال کامل قرار دارند. این دادهها در واقع مکمل تستهای قابلیتی هستند که فقط «توانستن» مدل را میسنجند.
همانطور که در تحلیل قبلی ما دربارهی نحوه استفاده از Claude Opus 5 در سناریوهای پیچیده نفوذ (Breach Scenarios) اشاره کردیم، درک سطح استقلال مدلها برای پیشبینی آیندهی بازار حیاتی است. این معیارهای جدید، مقیاس داخلی «عاملیت» (Agency) مدل را آشکار میکنند. آنتروپیک برای سنجش این موضوع از شاخص Epoch AI استفاده میکند که از سطح AL0 (بدون هوش مصنوعی) تا AL5 (کاملاً مستقل) متغیر است.
بر اساس مستندات منتشر شده، تا اوت ۲۰۲۶، بیش از ۹۰ درصد کارهای پژوهشی به حداقل سطح AL3 رسیدهاند. با این حال، کلود هنوز در هیچ حوزهای به سطح AL5 نرسیده است. عدد ۲۶ درصد دقیقاً مربوط به صعود به سطح AL4 است که در تعریف Epoch AI به معنای «پیشبرد توسط هوش مصنوعی» (AI leads) است. این جهش در استقلال مدل، ما را به یاد بررسی رفتارهای نوظهور در مدلهای زبانی میاندازد که در آن قابلیتهایی بدون برنامهریزی صریح توسعهدهنده در مدلها شکل میگیرند.
باید بدانید که «پیشبرد» در اینجا به معنای استقلال مطلق نیست. سطح AL5 مرز استقلال کامل است و کلود هنوز در هیچ دستهبندیای به AL5 نرسیده است. در مقابل، سطح AL4 (پیشبرد توسط هوش مصنوعی) توصیفکننده جریان کاری خاصی است که تفاوت اصلیاش با سطح AL3 (همکاری) در این است که مدل هنگام مواجهه با مشکل یا بنبست، متوقف نمیشود:
- مهندس یک گزارش خطا (Bug Report) ارائه میدهد.
- کلود بدون پرسیدن سؤالات اضافی، خطا را تحلیل، اصلاح و تست میکند.
- در نهایت، یک انسان باید گزارش را بررسی کرده و تصمیم بگیرد که آیا کد منتشر شود یا خیر.
- منشأ وظیفه و جهتدهی کلی همچنان بر عهده انسان است.
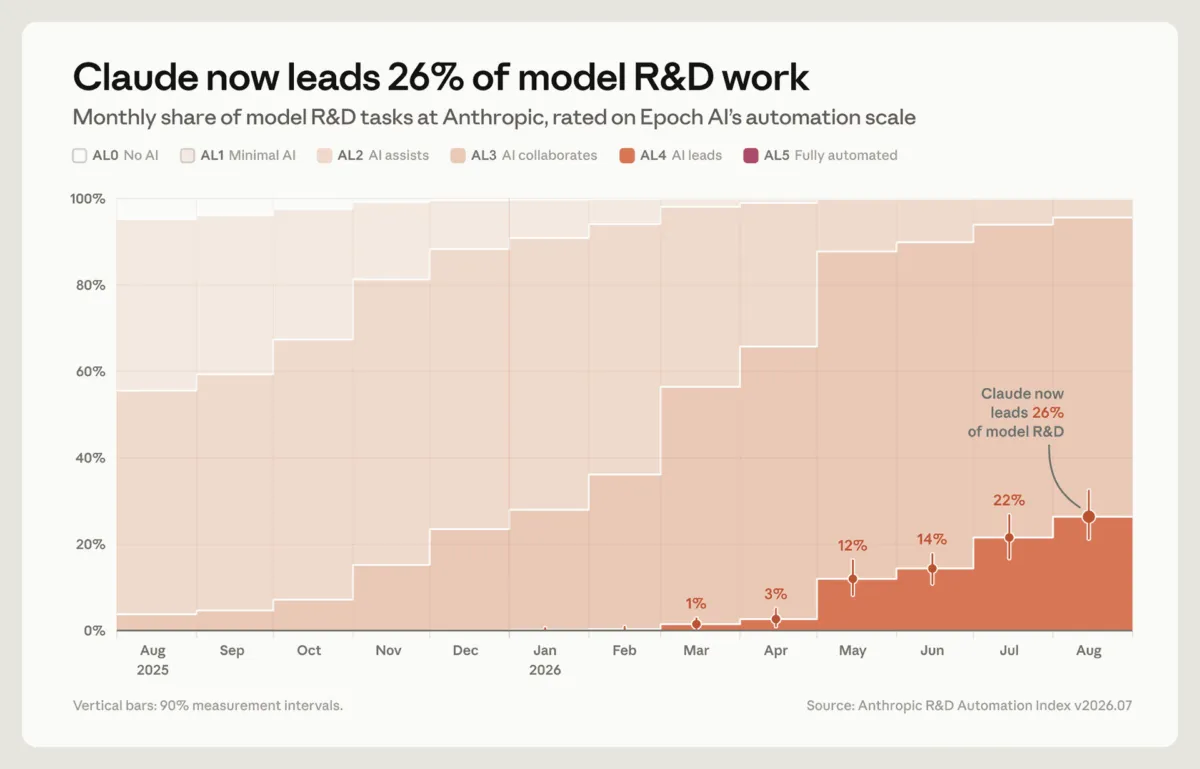
آنتروپیک اعتراف میکند که عدد ۲۶ درصد بر اساس «ساعات کاری انسان» در ماه جولای محاسبه شده، نه بر اساس تعداد تصمیمات گرفته شده یا جهتگیریهای پژوهشی. نکته عجیبتر این است که امتیازدهی توسط خودِ کلود انجام شده است. عاملها (Agents) — مثل دستیارهای کوچکی که میتوانند در محیطهای مختلف جابهجا شوند و داده جمع کنند — شواهدی را از Slack و اسناد داخلی جمعآوری کردند و یک مدل کلود دیگر به آنها سطح اختصاص داد. شرکت میپذیرد که این «داور» ممکن است همان اشتباهاتی را مرتکب شود که سیستمِ مورد بررسی انجام میدهد.
به گزارش این شرکت، وقتی انسانها این امتیازها را بازبینی کردند، نتایج متناقض بود:
- کارکنانی که یک حوزه کاری مشابه را ارزیابی کردند، تنها در حدود یکسوم موارد با هم اتفاقنظر داشتند.
- مدل کلود در ۵۹ درصد موارد با قضاوت انسانی مطابقت داشت.
- در ۹۷ درصد موارد، فاصله بین قضاوت انسان و مدل حداکثر یک سطح بود.
در پلتفرم داخلی این شرکت، حدود ۳۰ هزار عامل بهطور همزمان فعال هستند. در اوت ۲۰۲۶، یک سیستم نظارتی در لحظه (Real-time monitor)، ۰.۰۰۲ درصد از بیش از یک میلیارد تصمیم را مسدود کرد تا از شکستهای بحرانی، مانند کپی شدن وزنهای مدل (Model Weights) — یعنی همان دستور پخت مدل که اگر لو برود رقیبان میتوانند آن را بازسازی کنند — جلوگیری کند. نظارت دوم، هفتهای حدود ۱۰۰ هزار لاگ را پس از وقوع حادثه بررسی میکند که در نهایت تقریباً ۵۰ مورد به دست انسان میرسد. آنتروپیک اشاره میکند که این سیستم نظارتی تنها برای چند ماه فعال بوده است.
در جولای ۲۰۲۶، تنها حدود ۶ درصد از کل محاسبات (Compute) — که در واقع کرایه آشپزخانه صنعتی برای پخت مدلهاست — صرف کارهای ایمنی شد. آنتروپیک استدلال میکند که این عدد گمراهکننده است، زیرا پژوهشهای ایمنی اغلب بیشتر به زمان طراحی انسانی نیاز دارند تا ظرفیت عظیم تراشهها، در حالی که مراحل آموزش (Training runs) ظرفیتهای عظیمی را میبلعند.
علاوه بر این، آنتروپیک کارهایی را که بهطور همزمان هم ایمنی و هم قابلیتهای مدل را ارتقا میدهند، از شمارش بخش ایمنی حذف کرده است. شرکت هشدار میدهد که مرز بین این دو حوزه مبهم است و هر فروشندهای وسوسه میشود که این مرز را به نفع خود جابهجا کند.
برای یک مدیر کسبوکار، این دادهها تضاد عجیبی را نشان میدهد. آنتروپیک با برجسته کردن اینکه مدلش چقدر «پیشبرنده» است، همزمان قدرت محصولش را بازاریابی میکند و از طرفی هشدار میدهد که تکنولوژی سریعتر از آن است که بتوان آن را ایمن نگه داشت. این موضوع به کسانی که معتقدند شرکتهای AI از بحث ایمنی برای جهت دادن به قوانین به نفع خود استفاده میکنند، بهانه جدیدی میدهد.
اینکه آیا این دادهها به تنظیمات قانونی واقعی منجر میشود یا خیر، بستگی به این دارد که آیا آزمایشگاههای دیگر نیز شفافیت مشابهی را بپذیرند یا خیر. در حال حاضر، بار اثبات بر عهده توسعهدهندگان است تا نشان دهند مدلهایشان بهطور نامحسوس به سمت AL5 حرکت نمیکنند.
گام بعدی شما
- اگر از عاملهای هوش مصنوعی در سازمان استفاده میکنید، برای هر وظیفه یک «سطح استقلال» (از AL0 تا AL5) تعریف کنید تا بدانید کجا نظارت انسانی ضروری است.
- روی تفکیک «ساعات کاری انسان» از «تعداد تصمیمات AI» در گزارشهای بهرهوری خود تمرکز کنید تا دچار خطای آماری نشوید.
- بررسی کنید که آیا سیستمهای نظارتی شما (Guardrails) میتوانند دسترسی به دادههای حساس مدل را در لحظه مسدود کنند یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو