
آموزش مدلهای کوچک دیگر یک بازی حدس و گمان نیست. تیمی در اپل (Apple) به سرپرستی دن باسبریج، نخستین قوانین سختگیرانه مقیاسپذیری را برای این فرآیند تدوین کردند و بهصورت مؤثر «هنر» آموزش مدلهای کوچک را به یک علم پیشبینیپذیر تبدیل نمودند.
سالها بود که صنعت برای تصمیمگیری درباره اینکه آیا یک مدل معلم قویتر منجر به دانشآموز بهتری میشود یا خیر، به تجربیات پراکنده تکیه میکرد. طبق گزارشهای فنی، متخصصان اغلب با نتایج متناقضی مواجه میشدند که در آن مدلهای معلم بزرگتر بهطور غیرمنتظرهای عملکرد دانشآموز را کاهش میدادند؛ موضوعی که اجرای آموزشهای گرانقیمت را به یک قمار تبدیل میکرد. این چالشها در واقع بخشی از بحثهای گستردهتر پیرامون نقش مدلهای بزرگ به عنوان مدرسان هوش مصنوعی است که در آن کیفیت دادههای تولید شده توسط معلم، تعیینکننده نهایی است.
در اوایل سال ۲۰۲۵، اپل جامعترین مطالعه کنترلشده روی تقطیر (Distillation) را از نظر حجم محاسبات انجام داد. بر اساس مستندات منتشرشده در thesequence.substack.com، پژوهشگران متغیرهای زیر را مورد آزمایش قرار دادند:
- مدلهای دانشآموز با بازه ۱۴۳ میلیون تا ۱۲.۶ میلیارد پارامتر (Parameters).
- مدلهای معلم در بازه مشابه.
- مجموعهدادههای آموزشی تا سقف ۵۱۲ میلیارد توکن (Token).
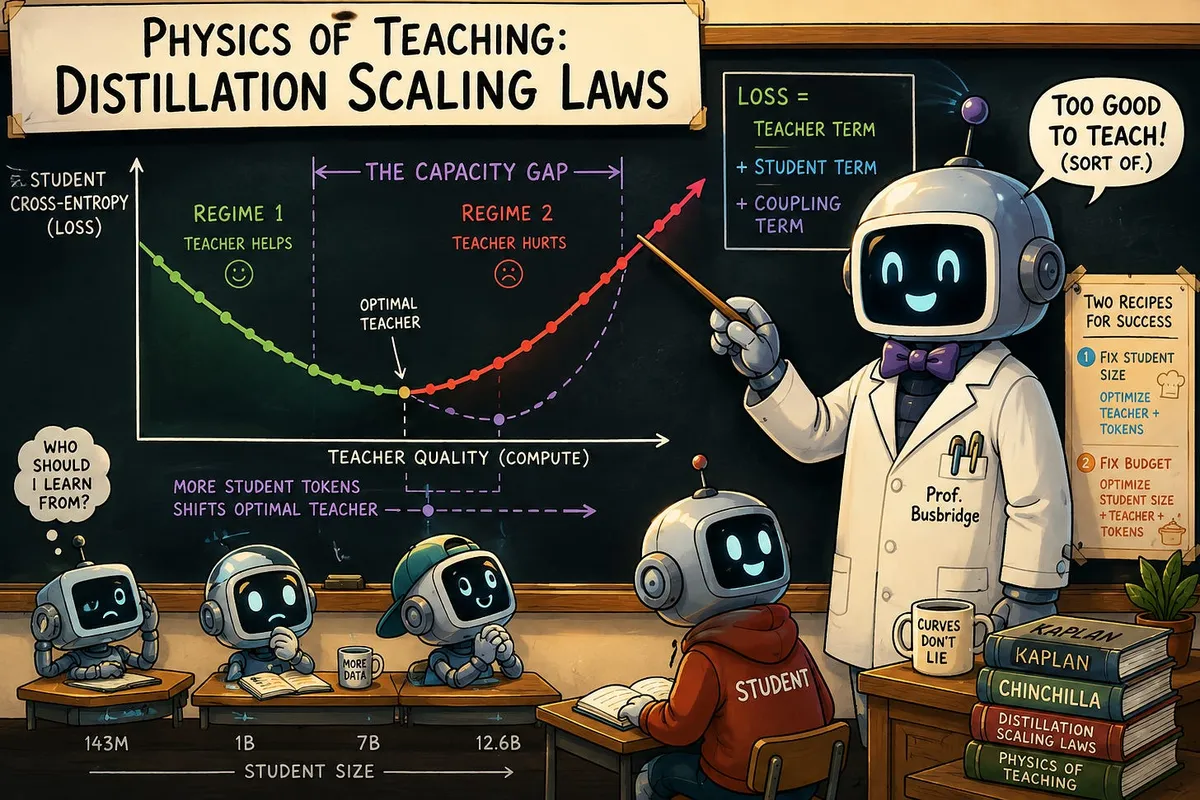
همانطور که در تحلیلهای پیشین ما درباره بهینهسازی مدلهای لبه اشاره کردیم، این دادهها به حوزه هوش مصنوعی اجازه میدهد تا تحولی مشابه قوانین کاپلان و چینچیلا در پیشآموزش را تجربه کند. اکنون توسعهدهندگان بهجای حدس زدن حجم داده یا اندازه مدل معلم، میتوانند «تابع زیان» دانشآموز را به عنوان تابعی پیشبینیپذیر از اندازه مدل، حجم داده و کیفیت معلم در نظر بگیرند.
برای متخصصان فنی، این یافته بنچمارک بنیادین تقطیر را از «حس کلی» به یک مسئله بهینهسازی بودجه تغییر میدهد. این پژوهش با ارائه یک منحنی برازششده که دقیقاً پیشبینی میکند چه زمانی یک معلم قویتر دیگر سود marginally (حاشیهای) ایجاد نمیکند، به بحثهای قدیمی درباره قدرت معلم پایان میدهد. در این راستا، بررسی تفاوتهای میان فشردهسازی مسیر و تقلید پاسخ میتواند دیدگاه عمیقتری درباره نحوه انتقال دانش از معلم به دانشآموز ارائه دهد.
مهندسان اکنون باید این قوانین مقیاسپذیری را در بودجههای محاسباتی خود ادغام کنند تا از اشتباهات ۱۰ میلیون دلاری ناشی از تخصیص بیش از حد منابع به مدلهای معلم جلوگیری کنند. پرسش حیاتی بعدی این است که آیا این قوانین در معماریهای مختلف مدلها نیز صادق است یا تنها محدود به گونههای ترنسفورمر (Transformer) آزمایششده باقی میماند.
گام بعدی شما
- بازنگری در بودجههای GPU برای پروژههای تقطیر مدل با استفاده از توابع پیشبینیکننده اپل.
- تحلیل نسبت اندازه معلم به دانشآموز بر اساس منحنیهای سود حاشیهای برای جلوگیری از Over-provisioning.
- بررسی سازگاری این قوانین با مدلهای غیرترنسفورمر در صورت استفاده از معماریهای جایگزین.
اما تأثیر این قوانین بر کاهش هزینههای استنتاج در دستگاههای موبایل حتی حیاتیتر است — به تحلیل ما درباره بهینهسازی مدلهای On-device مراجعه کنید. این رویکرد با مفاهیم فشردهسازی استدلال در وزنهای مدل همسو است تا بتوان توانمندیهای پیچیده محاسباتی را در سختافزارهای محدود پیادهسازی کرد.



گفتگو