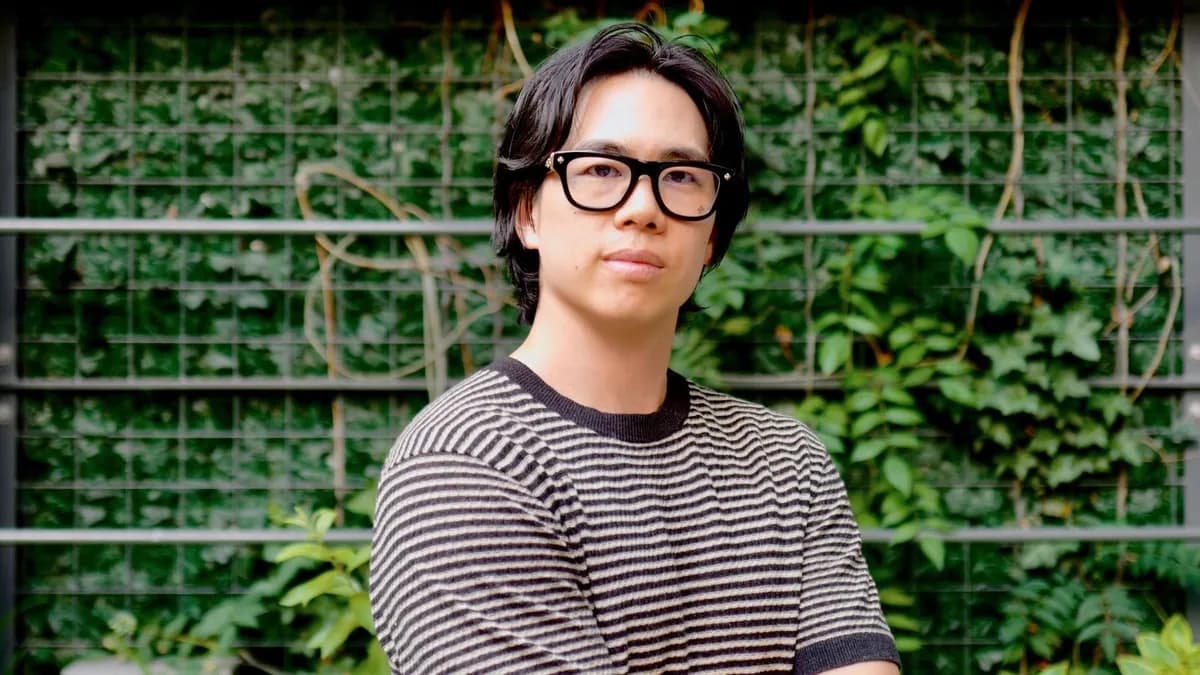
اگر یک استودیو یا هنرمند هستید، احتمالاً میترسید که مدلهای هوش مصنوعی بدون اجازه، آثار شما را بلعیده و بازتولید کنند. نلسون چو، مؤسس و مدیرعامل ARCOS Labs، معتقد است تنها راه نجات آثار خلاقانه، ایجاد یک لایه تأیید فنی است که بتواند اثرات مدلهای مولد را ردیابی کند. به گفته چو، در حالی که قوانین کپیرایت هنوز مبهم هستند و نشانگذاریها (Watermarking) — شبیه به مهر کوچکی روی کاغذ که به راحتی با پاککن پاک میشود — به سادگی حذف میشوند، ما به یک زیرساخت فارنزیک (Forensic) نیاز داریم تا حقوق مالکیت را در مقیاس وسیع مدیریت کنیم.
این تحول در زمانی رخ میدهد که مدلهای هوش مصنوعی زاینده (Generative AI) — مثل نقاشیهایی که با یادگیری از میلیونها اثر قبلی، تصاویر جدید میسازند — بهطور فزایندهای با شخصیتهای دارای کپیرایت و چهرههای انسانی درگیر میشوند. برای استودیوها و سازندگان، محیط فعلی کاملاً تاریک و کدر است؛ آنها اغلب نمیتوانند تأیید کنند که آیا یک مدل روی آثار آنها آموزش دیده است یا خیر، و یا اینکه هر چند وقت یکبار مالکیت معنوی (IP) آنها را بازتولید میکند. این وضعیت تضادی شدید و با ریسک بالا میان اهداف رشد سریع آزمایشگاههای AI و بقای دارندگان حقوق ایجاد کرده است.
پیشینه مؤسس: از بازارهای مالی تا مالکیت معنوی
نلسون چو یک کارآفرین سریالی و مدیر اجرایی فناوری است که سابقه حرفهای او حوزههای پلتفرمهای دیجیتال، سرمایهگذاری و زیرساختهای مالی را در بر میگیرد. او پیش از تأسیس ARCOS Labs، هشت سال را به عنوان مؤسس و مدیرعامل Percent گذراند؛ پلتفرمی تکنولوژیک که برای مدرنسازی بازارهای پراکنده اعتبار خصوصی (Private Credit) ساخته شده بود. او در حال حاضر به عنوان رئیس هیئت مدیره در شرکت Percent فعالیت میکند.
سایر فعالیتهای کارآفرینانه چو شامل MySupport بود؛ یک پلتفرم آنلاین که افراد دارای معلولیت و سالمندان را به کارکنان حمایتی متصل میکرد (که بعدها توسط RISE Services خریداری شد). او همچنین شرکت Lumenary را تأسیس کرد که یک شرکت مشاوره استراتژیک است.
بنیان حرفهای او در خدمات مالی و با تصدی پستهایی در شرکتهای بزرگی چون BlackRock، Bank of America و Merrill Lynch شکل گرفت. علاوه بر این، او به عنوان سرمایهگذار و مشاور در شرکتهایی مانند Recharge Capital و BlockFi ایفای نقش کرده است.
همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، نبود استانداردهای نظارتی همواره منجر به هرجومرج در توزیع منابع میشود. چو دقیقاً همین الگو را در مالکیت معنوی AI میبیند.
درسهایی از زیرساختهای مالی
چو شباهت مستقیمی میان وضعیت فعلی IP در هوش مصنوعی و بازارهای پراکنده اعتبار خصوصی که در Percent با آنها سر و کار داشت، میبیند. او سه درس کلیدی از زیرساختهای مالی استخراج کرده است که مستقیماً در مدیریت IP کاربرد دارند:
- استانداردسازی پیش از بازار: در Percent، چو دریافت که اعتبار خصوصی به دلیل اینکه هر معامله به شکل متفاوتی توصیف میشد، مبهم است و مقایسه یا قیمتگذاری آنها با اطمینان غیرممکن بود. او سالها روی «لولهکشیهای خستهکننده» کار کرد تا اطمینان حاصل کند معاملات هر بار به روشی یکسان تأیید میشوند. او استدلال میکند که IP هم همین مشکل را دارد؛ در حال حاضر هیچ رکورد استانداردی از اینکه یک دارایی چیست یا چه کسی مالک آن است وجود ندارد. بدون این استاندارد، لایسنسینگ و اجرای قوانین بهصورت موردی و بدون نظم باقی میماند.
- تأیید به جای اعتماد: در اعتبار خصوصی، سرمایهگذاران به حرف صادرکننده درباره عملکرد اعتماد نمیکردند، بلکه دادههایی میخواستند که خودشان بتوانند بررسی کنند. به همین ترتیب، دارندگان حقوق نمیتوانند به تضمینهای شرکتهای AI درباره «حفاظها» (Guardrails) تکیه کنند؛ چو اشاره میکند که این وعدهها وزن بسیار کمی دارند. تنها شواهدی که بهطور مستقل قابل بازتولید باشند، میتوانند مسیر گفتگو را تغییر دهند.
- همسویی انگیزهها: بازارهای پراکنده تنها زمانی کار میکنند که هر دو طرف سود ببرند. در حال حاضر، انگیزهها همسو نیستند: شرکتهای مدلساز ممکن است از محتوای نقضشده به عنوان یک تاکتیک بازاریابی استفاده کنند (مانند نمونههای اخیر در Sora و ByteDance)، در حالی که تولیدکنندگان محتوا در حالی که تولید محتوا بهشدت آسانتر شده، برای حفظ جایگاه خود میجنگند. زیرساخت برنده باید یک طرف بیطرف باشد که خودش در تراکنشها شرکت نمیکند.
چو معتقد است IP در ابتدای گذاری مشابه اعتبار خصوصی است؛ بازاری که تنها زمانی به یک کلاس دارایی جریان اصلی تبدیل شد که زیرساختی برای اندازهگیری آن ایجاد شد.
مکانیسمهای هوش فارنزیک IP
شرکت ARCOS Labs (مخفف Applied Research in Creative Output Synthesis) در اوت ۲۰۲۶ از حالت مخفیانه خارج شد. تمرکز این شرکت بر هوش فارنزیک IP و مدیریت حقوق است تا زیرساخت اعتمادی لازم برای همزیستی سازندگان و سیستمهای AI در مقیاس وسیع ایجاد کند.
پلتفرم اصلی این شرکت، VN، طراحی شده است تا به استودیوها، آژانسهای استعداد و دارندگان حقوق، دیدی شفاف نسبت به خروجیهای AI بدهد. در کنار VN، شرکت ARCOS پشت ابتکاری به نام Lightbar است؛ یک پروژه جمعسپاری که به بررسی مدلهای آموزشی AI اختصاص یافته است.
برخلاف فیلترهای ساده پرامپت، VN به عنوان یک موتور دقت (Fidelity Engine) عمل میکند. این سیستم تعیین میکند که یک خروجی تولید شده توسط AI از نظر آماری چقدر به یک شخصیت یا چهره محافظتشده شبیه است. این سیستم تمام ژستها و احتمالات را ثبت میکند تا تشخیص جامع تضمین شود.
چو اشاره میکند که تصمیم درباره اینکه آیا یک شباهت «بیش از حد» است یا خیر، بر عهده کاربر است. شرکتهای بزرگ معمولاً آستانههای سختگیرانهای تعیین میکنند زیرا تمام محتوای تولیدی آنها باید متعلق به خودشان باشد. اما کاربران نیمهحرفهای (Prosumer) که اغلب برای سرگرمی تجربه میکنند، ممکن است آستانههای تغییرات بالاتری را بپذیرند.
تحلیل مواجهه و تست مدلها
در هنگام انجام تستهای فارنزیک برای مشتریان، ARCOS Labs تحلیلهای دقیقی از مواجهه (Exposure Analysis) ارائه میدهد. این تحلیل به سه پرسش حیاتی پاسخ میدهد:
۱. کدام مدلهای خاص، محتوای محافظتشده را با دقت بیشتری تولید میکنند؟
۲. کدام مدلها اصلاً قادر به تولید این محتوا هستند؟
۳. کدام مدلها میتوانند IP را در موقعیتهای مشکلساز یا نقضکننده قرار دهند؟
بر اساس بررسیهای چو روی مدل Seedance 2.5، تفاوت شدیدی در حفاظها دیده شد. در حالی که شخصیتهای مشهور و سطح بالا محافظتهای شدیدی داشتند، IPهای «دمدراز» (Long-tail) یا کمتر شناختهشده همچنان آسیبپذیر بودند.
چو مشاهده میکند که در حالی که برخی مدلها — چه از روی انتخاب و چه از روی غفلت — نسبت به IP بیتفاوت به نظر میرسند، اما احترام به مالکیت معنوی هرگز یک اشتباه تلقی نخواهد شد. او اشاره میکند که وقتی Seedance 2.0 در اوایل سال جاری منتشر شد، ByteDance پس از واکنشهای شدید و انتقادات گسترده، بهسرعت حفاظهای خود را بهبود بخشید.
چرا محافظت از IPهای کمتر شناختهشده دشوار است؟
این شکاف به این دلیل وجود دارد که شرکتهای AI بر دو مکانیسم معیوب تکیه میکنند:
- بررسیهای سطح پرامپت: اینها ورودی کاربر را برای محتوای نقضکننده چک میکنند. اما اینها بهراحتی از طریق غلطهای املایی، توصیف شخصیت بدون نام بردن از آن، یا تغییر جزئی در عبارتبندی درخواستها دور زده میشوند. علاوه بر این، مدلها ممکن است دچار توهم (Hallucination) شوند و خروجیهایی تولید کنند که با پرامپت کاربر متفاوت است اما شامل یک شخصیت دارای کپیرایت باشد.
- بررسیهای تحلیل خروجی: اینها خروجیها را با پایگاهداده شخصیتهای شناختهشده مقایسه میکنند. IPهای دمدراز — مانند شخصیتی از یک فیلمی که مستقیماً روی DVD منتشر شده و هرگز در سینما نبود — اغلب نادیده گرفته میشوند چون در پایگاهداده وجود ندارند.
سرعت نیز یک عامل کلیدی است. در حالی که بررسی یک تصویر سریع است، تولید ویدیو نیازمند اسکن فریمهای بسیار زیادی است که میتواند سرعت خروجی را بهشدت کاهش داده و بر تجربه کاربر تأثیر منفی بگذارد. این موضوع باعث میشود پلیسینگ جامع بهطور اجتنابناپذیری چالشبرانگیز باشد.
شکست حفاظهای فعلی
چو استدلال میکند که نرخ رد کردن پرامپتها، معیاری گمراهکننده برای ایمنی AI است. اگر مدلی درخواست مستقیم برای یک شخصیت را رد کند اما با دریافت یک توصیف دقیق، همان شخصیت را بازتولید کند، این نشان میدهد که آن شخصیت عمیقاً در دادههای آموزشی مدل جای گرفته است.
این موضوع پرسشهای بزرگی درباره نحوه جمعآوری دادهها ایجاد میکند که اکنون در دادگاهها در جریان است. چو به ابهام قوانین کپیرایت در پروندههای مربوط به Anthropic، Cox و GEMA در آلمان اشاره میکند. چون مفهوم «استفاده منصفانه» (Fair Use) هنوز یک پرسش باز است و دادگاهها زمان زیادی برای صدور حکم نیاز دارند، راهکارهای فنی ضروری هستند تا به جای آنها به احکام کندِ قانونی تکیه نشود.
نظارت بر محتوا (Content Moderation) نیز ناکافی است چون بر این فرض استوار است که مدلها خودشان را نظارت کنند، چیزی که چو آن را تقریباً غیرممکن میداند. مدلهای انتشار (Diffusion Models) تصاویر را از طریق نویز میسازند و میتوانند بهطور تصادفی داراییهای دارای کپیرایت را در پیشزمینه یا پسزمینه، اغلب بدون درخواست کاربر، بازتولید کنند. تنها راه قابل اعتماد، تست خروجیهای واقعی است.
حل مشکل مثبتهای کاذب
تشخیص شباهت، بهویژه در مورد «سبک» یا ساختههای مصنوعی، پیچیده است. چو مثال سوپرمن را میزند: اگر مدلی نسخهای از سوپرمن را با چشمهای کریستوفر ریو، چانه هنری کاویل و استخوانهای گونه بازیگر دیگری بسازد، نتیجه یک موجود ترکیبی (Hybrid) است که مهندسی معکوس آن و ردیابی آن به منابع خاص بسیار سخت است.
برای جلوگیری از مثبتهای کاذب، ARCOS Labs از تکیه بر یک عدد تک برای شباهت بهصورت مجزا اجتناب میکند. در عوض، نتایج را با معیارهای مرجع (Benchmark) میسنجد تا شباهتهای کلی را از بازتولید واقعی تفکیک کند. هر تست بهگونهای طراحی شده که بازتولیدپذیر باشد؛ یعنی ورودیهای یکسان در شرایط یکسان، همیشه اعداد یکسانی بدهند.
این تحلیلها با دو استاندارد حقوقی خاص مطابقت دارند:
- شباهت اساسی (Substantial Similarity): که برای شخصیتها و آثار خلاقانه استفاده میشود.
- احتمال سردرگمی (Likelihood of Confusion): که برای برندها و چهرهها به کار میرود تا تعیین شود آیا یک بیننده عادی فریب میخورد و فکر میکند خروجی، اثر واقعی است یا خیر.
اینکه آیا یک نتیجه به سطح یک تحقیقات رسمی برسد یا خیر، همیشه تصمیم دارندگان حقوق است.
مقیاسپذیری نظارت و لایسنسینگ
نظارت دستی بر صدها مدل و هزاران دارایی برای دارندگان حقوق تقریباً غیرممکن است و آنها را ناتوان از همگام شدن با جدیدترین مدلهای ایالات متحده و آسیا میکند. ARCOS Labs این مشکل را از طریق ثبت دقیق سوابق حل میکند.
هر نتیجه به یک نقطه زمانی خاص گره میخورد و نسخه مدل، تاریخ و دارایی محافظتشده را ثبت میکند. وقتی یک مدل بهروزرسانی میشود، دارندگان حقوق میتوانند دوباره تست کنند و نتایج را با سوابق قبلی مقایسه کنند، به جای اینکه از صفر شروع کنند. این کار یک «مشکل همیشگی و غیرممکن» را به یک مسئله قابل مدیریت تبدیل میکند.
چو تصور میکند این زیرساخت در نهایت امکان ایجاد یک بازار قانونی برای لایسنسینگ را فراهم کند. اگر سیستمی بتواند یک IP را در خروجی شناسایی کند، میتواند بهطور برنامهریزیشده مالک را شناسایی کرده، مجوزها را بررسی کند و پرداختها را تسهیل نماید.
از نظر فنی، این به دارندگان حقوق اجازه میدهد تا در مدلهای خاص مشارکت کنند و از هر بار تولید محتوا بر اساس شرایط پیشفرض درآمد کسب کنند، به جای اینکه مجبور به پذیرش حفاظهای محدودکننده باشند. برای اینکه این سیستم کار کند، چو تأکید میکند که لایه زیرساختی باید بیطرف بماند. این لایه نباید خودش محتوا تولید کند یا در معاملات طرف باشد. این بیطرفی تنها راهی است که دارندگان حقوق به سیستم برای مدیریت کاتالوگهای خود اعتماد کنند.
آینده هالیوود و هوش مصنوعی
با رسیدن ویدیوهای تولید شده توسط AI به کیفیت حرفهای، رابطه آزمایشگاههای AI و هالیوود احتمالاً به یک سیستم دو لایه تبدیل میشود. بررسیهای اجرایی برای سرعت و بهرهوری هزینه، در نهایت به درون خود مدلها منتقل خواهند شد.
با این حال، لایه مرجع — یعنی رکورد مالکیت و شرایط استفاده — باید مستقل بماند. چو این را به بازارهای مالی تشبیه میکند که در آن شرکتها بازرسیهای داخلی (Compliance) دارند اما همچنان به حسابرسهای خارجی پاسخ میدهند. یک شرکت مدلساز نمیتواند کسی باشد که خروجیهای خودش را نمره میدهد، و دارندگان حقوق هرگز کاتالوگهای خود را به شرکتی نمیسپارند که کسبوکارش تولید مشتقاتی از آثار آنهاست.
در نهایت، هدف یک همزیستی است که در آن AI به عنوان ابزاری قدرتمند برای داستانسرایان عمل کند و در عین حال تضمین شود که سازندگان دستمزد خود را میگیرند. مدیریت حقوق زمانی اتفاق میافتد که هالیوود و شرکتهای AI تصمیم بگیرند چگونه برای خلق محتوایی که مردم دوست دارند، با هم همزیستی کنند.
گام بعدی شما
- اگر مالک IP هستید، ابزارهای تحلیل آماری خروجی را جایگزین اعتماد به وعدههای شرکتهای AI کنید.
- روی استانداردهای «شباهت اساسی» در قراردادهای جدید تولید محتوا تمرکز کنید.
- رصد کنید که آیا لایه تأیید مستقل (Independent Verification) به یک استاندارد صنعتی تبدیل میشود یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو