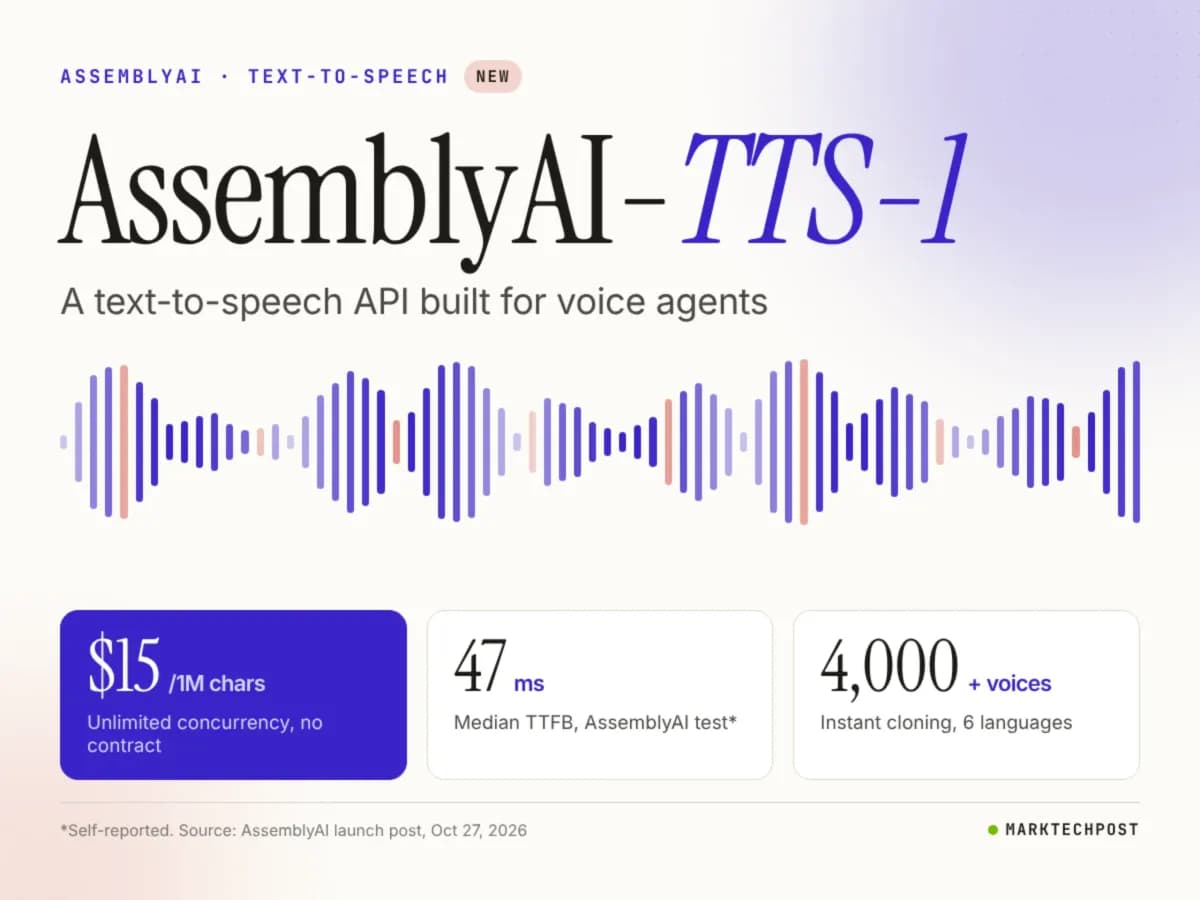
شرکت AssemblyAI با مدل AssemblyAI-TTS-1 وارد بازار تبدیل متن به گفتار شد. این رابط برنامهنویسی پخش جریانی ۱۵ دلار برای هر میلیون کاراکتر قیمت دارد، سقف همزمانی ندارد و برای عاملهای صوتی در تماسهای تلفنی زنده طراحی شده است.
در این تماسها تأخیر و درستی تلفظ تعیین میکند که تماسگیرنده پشت خط بماند یا نه. AssemblyAI پیشتر در تبدیل گفتار به متن (Speech-to-Text) فعال بود و حالا میخواهد کل چرخهٔ صوتی را از یک فروشنده ارائه کند.
چرا عاملهای صوتی به این مدل نیاز دارند
عاملهای صوتی امروز یکی از رابطهای اصلی خدمات مشتری، فروش تلفنی و نوبتدهی هستند. تا امروز توسعهدهندگان یک انتخاب دشوار داشتند: یا برای تأخیر کم و صحت بالا به شرکتهایی مثل ElevenLabs و Cartesia پول زیادی بپردازند، یا کیفیت پایینتر گزینههای ارزان را بپذیرند. این عرضه در زمانی انجام شد که سازمانها عاملهای تلفنی هوش مصنوعی را از مرحلهٔ آزمایشی به استفادهٔ واقعی میبرند. توسعهدهندگان تا امروز بین تأخیر کم و صحت بالا در سرویسهایی مثل ElevenLabs و Cartesia یا کیفیت پایینتر گزینههای ارزان انتخاب میکردند؛ تفاوت قیمت و کیفیت در این دو سرویس قبلاً بررسی شده است.
مدل AssemblyAI-TTS-1 چه ویژگیهایی دارد
بیشتر مدلهای تبدیل متن به گفتار صدا را به شکل توکنهای گسسته نمایش میدهند. به گفتهٔ AssemblyAI، مدل TTS-1 بهجای آن از نمایش پیوستهٔ صوت (Continuous Audio Representations) استفاده میکند. شرکت میگوید این روش صدا را طبیعیتر میکند و زمان رسیدن به نخستین صدا را کوتاهتر میکند.
این مدل روی میلیونها ساعت صوت، از جمله دادههای مکالمهٔ واقعی، آموزش دیده است. همراه آن کتابخانهای با بیش از ۴۰۰۰ صدا عرضه شده است. شبیهسازی صدا هم بهصورت فوری و با یک ضبط کوتاه و تأیید اجازهٔ گوینده انجام میشود. نمونهٔ شبیهسازیشده در اطلاعیهٔ عرضه با ۲۴ ثانیه صوت ساخته شده بود.
مدل در زمان عرضه از شش زبان پشتیبانی میکند:
- انگلیسی
- اسپانیایی
- فرانسوی
- آلمانی
- ایتالیایی
- پرتغالی
روشهای اتصال برای توسعهدهندگان
توسعهدهندگان از سه مسیر میتوانند به مدل وصل شوند:
- API مبتنی بر HTTP برای درخواست و پاسخ ساده
- API مبتنی بر WebSocket با پیام لغو برای مدیریت قطع صحبت عامل توسط کاربر (Barge-in)
- مسیر سازگار با اوپنایآی برای جایگزینی مستقیم سرویس فعلی (Drop-in Replacement) توسعهدهندگان سه مسیر برای اتصال به مدل دارند، از جمله مسیر سازگار با اوپنایآی برای جایگزینی مستقیم سرویس فعلی؛ معیارهای انتخاب بین APIهای رایگان و پولی TTS قبلاً مورد بررسی قرار گرفته است.
نشست WebSocket برای هر مکالمه یک اتصال باز نگه میدارد و پیام لغو را برای Barge-in میپذیرد. خروجی بهصورت PCM تککاناله، mu-law یا A-law و در بازهٔ ۸ تا ۴۸ کیلوهرتز ارائه میشود. قالب اصلی مدل PCM با ۲۴ کیلوهرتز است و سامانههای تلفنی میتوانند مستقیماً mu-law با ۸ کیلوهرتز بگیرند.
برچسب زمانی کلمهها هم در خروجی هست. AssemblyAI عاملهای مرجع LiveKit و Pipecat را نیز منتشر کرده است.
عملکرد مدل در آزمونهای خود AssemblyAI
AssemblyAI مدل TTS-1 را با ۵ مدل دیگر، روی ۴ مجموعهٔ انگلیسی و با ۵۰ صدای شبیهسازیشدهٔ همسان مقایسه کرد. همهٔ ارقام زیر را خود شرکت گزارش کرده و تاریخ ارزیابی ۲۸ اکتبر ۲۰۲۶ است:
- صحت موجودیتها: ۹۳٫۷ درصد روی ۵۸۰ نمونهٔ دشوار مثل شماره تلفن و کد؛ در برابر ۹۳٫۶ درصد ElevenLabs v4، ۸۲٫۵ درصد Cartesia Sonic 3.6 و ۶۸٫۰ درصد ElevenLabs Flash v2.5
- صحت کلمه: ۹۹٫۰ درصد روی جملههای Seed-TTS و LibriSpeech
- امتیاز MOS پیشبینیشده: ۳٫۸۵؛ پس از Inworld TTS-2 Flash با ۳٫۸۸ و پیش از Sonic 3.6 با ۳٫۸۲
- میانهٔ زمان تا نخستین بایت: ۴۷ میلیثانیه؛ در برابر ۱۱۹ میلیثانیهٔ Flash v2.5، ۱۴۳ میلیثانیهٔ Sonic 3.6 و ۲۴۴ میلیثانیهٔ Inworld TTS-2 Flash
- امتیاز آهنگ گفتار در TTSDS: ۸۵٫۵
- شباهت گوینده در صدای شبیهسازیشده: ۰٫۶۴
نتیجهٔ محک مستقل Cekura
محک مستقل Cekura که ۲۷ مدل را سنجیده، تصویر متفاوتی نشان میدهد:
- صحت خوانش: ۸۱٫۵ درصد
- طبیعی بودن صدا در معیار UTMOS: ۴٫۵۰
- میانهٔ تأخیر پخش جریانی: ۱۵۹ میلیثانیه، از لحظهٔ ارسال آخرین کلمه؛ رتبهٔ هشتم از ۱۹ مدل زمانسنجیشده
- مدل Inworld TTS-2 Flash با همان قیمت ۱۵ دلار، صحت ۹۳٫۲ درصد و تأخیر ۴۵ میلیثانیه ثبت کرد
AssemblyAI همچنین به نرخ خطای کلمهٔ ۱٫۷ درصد در جدول ردهبندی Coval اشاره میکند. به گفتهٔ شرکت، مدل در اولین حضور خود در میدان صداهای کنترلشدهٔ Artificial Analysis به جمع ده مدل برتر رسید.
قیمت و همزمانی نامحدود
مهمترین بخش این عرضه مدل قیمتگذاری آن است. AssemblyAI با ۱۵ دلار برای هر میلیون کاراکتر و بدون سقف همزمانی، از ElevenLabs با ۴۰ دلار و Cartesia با ۳۷ تا ۵۰ دلار ارزانتر است و با نرخ درخواستی Inworld برابری میکند. در Cartesia این بازه از تقسیم قیمت هر طرح بر اعتبارهای آن به دست میآید و هر کاراکتر یک اعتبار حساب میشود.
هزینه بر اساس کاراکترهای ورودی، همراه با فاصله و علائم نگارشی، محاسبه میشود. همهٔ صداها، شبیهسازی صدا، برچسب زمانی کلمهها و پردازش در اتحادیهٔ اروپا با همین نرخ ارائه میشوند. هزینهٔ جداگانه برای هر صدا، هزینهٔ همزمانی یا حداقل مصرف وجود ندارد. AssemblyAI این مدل را ارزانترین مدل پیشرفتهٔ تبدیل متن به گفتار برای عاملهای صوتی میداند.
با این حال، Inworld TTS-2 Flash هم در حالت درخواستی ۱۵ دلار برای هر میلیون کاراکتر میگیرد و این رقم در طرحهای پولی به ۷ دلار میرسد. تفاوت اصلی در همزمانی است: سطح درخواستی Inworld فقط ۵ درخواست همزمان را میپذیرد. برای عاملهایی که هزاران تماس همزمان را مدیریت میکنند، همزمانی نامحدود یکی از هزینههای بزرگ افزایش مقیاس را حذف میکند.
ویژگیهایی که هنوز نیامدهاند
مدل در زمان عرضه از SSML، کنترل سرعت، فرهنگ تلفظ و برچسبهای احساس پشتیبانی نمیکند. بدون SSML، کنترل سرعت و فرهنگ تلفظ، توسعهدهندگان نمیتوانند آهنگ گفتار را برای صدای برند تنظیم کنند یا اصطلاحات تخصصی را با اطمینان تلفظ کنند.
برچسبهای احساس هم در عاملهای مکالمهای بهتدریج به استاندارد تبدیل شدهاند. AssemblyAI برای حفظ توسعهدهندگانی که نمونهٔ اولیه را با TTS-1 میسازند، باید این قابلیتها را سریع اضافه کند.
معماری و جایگاه در برابر رقبا
بیشتر رقبا از روشهای مبتنی بر توکن گسسته یا مدل فضای حالت (State Space Model یا SSM) استفاده میکنند. برای نمونه، Cartesia Sonic 3.6 بر پایهٔ SSM ساخته شده است. اگر نمایش پیوستهٔ صوت بهطور پایدار هم تأخیر کمتر و هم صحت بالاتر بدهد، ممکن است به معماری پیشفرض این حوزه تبدیل شود. اگر نمایش پیوستهٔ صوت بهطور پایدار هم تأخیر کمتر و صحت بالاتر بدهد، ممکن است به معماری پیشفرض این حوزه تبدیل شود؛ رقابتی دیگر برای تسریع تعاملات صوتی قبلاً گزارش شده است.
زمان ۴۷ میلیثانیهای که خود شرکت گزارش کرده چشمگیر است. اما تأخیر ۱۵۹ میلیثانیه در محک مستقل نشان میدهد شرایط واقعی سربار قابلتوجهی اضافه میکند.
ادعای فروشندگان دربارهٔ تأخیر
- AssemblyAI: حدود ۹۰ میلیثانیه تا نخستین صدا
- Inworld: کمتر از ۲۵ میلیثانیه زمان تا نخستین بایت سمت سرور در صدک ۹۹
- ElevenLabs: حدود ۷۵ میلیثانیه
- Cartesia: کمتر از ۹۰ میلیثانیه
تعداد زبانهای پشتیبانیشده
مدل AssemblyAI-TTS-1 از ۶ زبان پشتیبانی میکند. این رقم برای Inworld بیش از ۲۰۰، برای ElevenLabs ۳۲ و برای Cartesia ۴۴ زبان است.
استقرار و دسترسی
مدل فقط روی ابر AssemblyAI و در منطقهٔ آمریکا (us-east-1) یا اتحادیهٔ اروپا (eu-north-1) اجرا میشود. نسخهٔ وزنهای باز یا امکان نصب روی سرورهای سازمان وجود ندارد. هر کلاینتی که HTTP یا WebSocket داشته باشد میتواند از آن استفاده کند.
ElevenLabs و Inworld هم فقط API میزبانیشده ارائه میدهند. Cartesia علاوه بر API میزبانیشده، در طرحهای سازمانی گزینهٔ نصب داخلی و VPC را هم دارد.
توسعهدهندگان از امروز میتوانند API را از طریق مستندات AssemblyAI و عاملهای مرجع LiveKit یا Pipecat آزمایش کنند. نخستین آزمونهای مستقل تأخیر زیر بار و برنامهٔ شرکت برای SSML و کنترل تلفظ نشان میدهد TTS-1 ابزار اصلی محیطهای واقعی میشود یا در حد ابزار نمونهسازی میماند.
گام بعدی شما
- اگر عامل صوتی در مقیاس بزرگ میسازید، TTS-1 را در محیط آزمایشی با بار همزمان واقعی بسنجید تا ببینید تأخیر ۱۵۹ میلیثانیهای محک مستقل در کار شما هم تکرار میشود یا نه.
- اگر SSML یا کنترل تلفظ برای کارتان ضروری است، تا اضافه شدن این قابلیتها صبر کنید یا فعلاً گزینههای دیگر را بررسی کنید.
- هزینهٔ همزمانی نامحدود را با طرحهای اعتباری رقبا برای حجم تماس پیشبینیشدهٔ خود مقایسه کنید؛ تفاوت در مقیاس هزاران تماس همزمان آشکار میشود.
گفتگو