تصور کنید با بودجهای که برای خرید یک لپتاپ ردهبالا هزینه میکنید، بتوانید سختترین قلعهی ذهنی یکی از باهوشترین انسانهای زمین را تسخیر کنید. این دقیقاً همان اتفاقی است که در دنیای بازیهای استراتژیک رخ داده است.
یک سامانه هوش مصنوعی به نام Ataraxos توانست برتری دیرینه انسان در بازی Stratego را از بین ببرد و موفق شود پرافتخارترین بازیکن تاریخ این بازی را شکست دهد. این پیروزی، سقوط یکی از آخرین بازیهای تختهای رقابتی است که در آن انسانها همچنان بر ماشینها برتری داشتند.
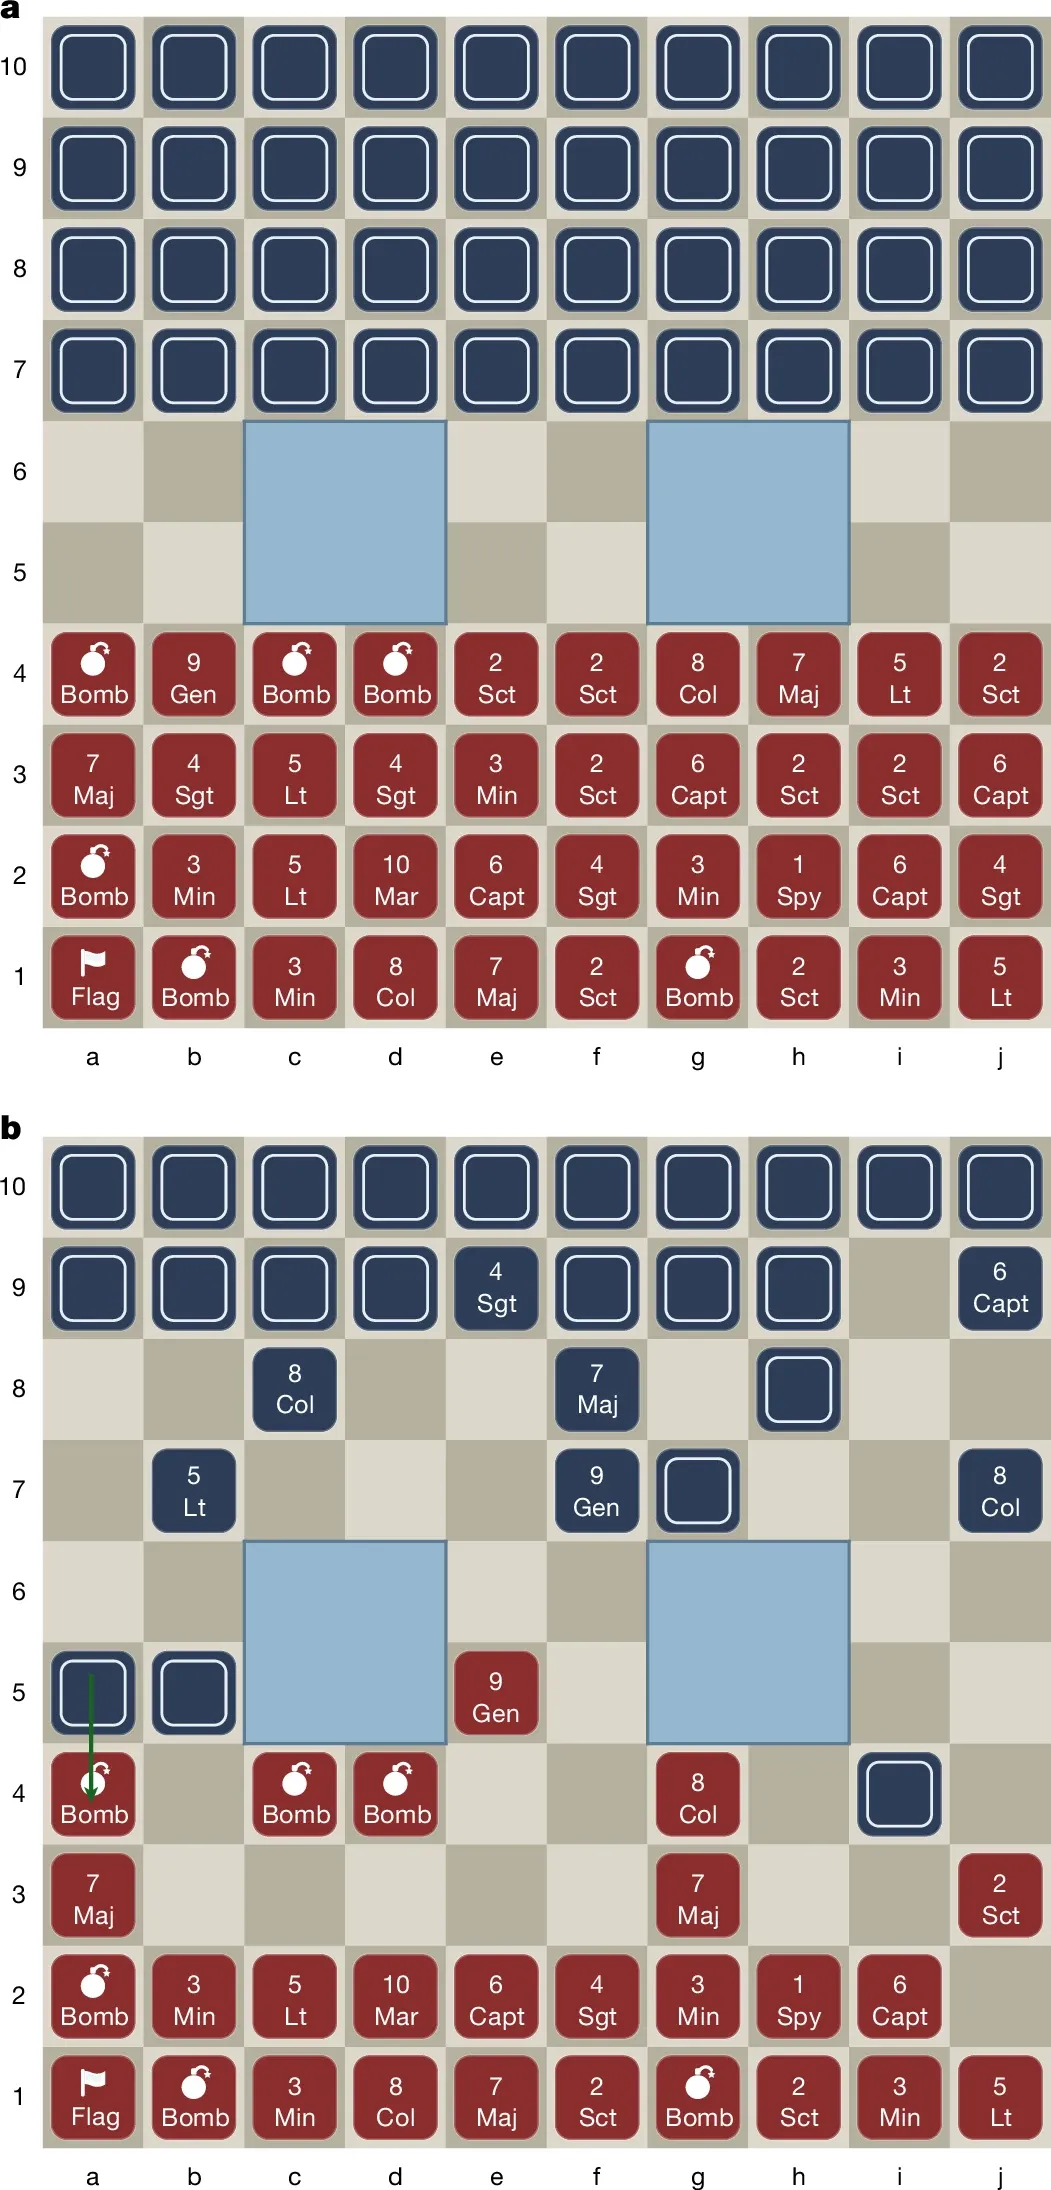
بازی Stratego برای هوش مصنوعی یک آزمون دشوار است چون بر پایه «اطلاعات ناقص» بنا شده است. در این بازی، هر دو بازیکن ۴۰ مهره را بهصورت رو به پایین و مخفی میچینند که بیش از ۱۰ به توان ۳۳ حالت شروع مختلف ایجاد میکند. رتبه هر مهره تنها هنگام برخورد با مهره حریف فاش میشود و هدف نهایی، تصرف پرچم دشمن است. به همین دلیل، هوش مصنوعی باید بهجای تکیه بر وضعیت مشهود صفحه، بر اساس حدسها و الگوها تصمیم بگیرد.
پیچیدگی اطلاعات پنهان
ساموئل سوکوتا (Samuel Sokota)، نویسنده اول این پژوهش، در شبکه اجتماعی X توضیح داد که در بازیهای با اطلاعات ناقص، ارزش یک حرکت نه تنها به نحوه ادامه بازی، بلکه به اتفاقاتی که قبل و حین تصمیمگیری رخ داده، بستگی دارد. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن و چالشهای استدلال دیدیم، مدیریت عدم قطعیت سختترین بخش یادگیری ماشین است. این چالشها در مدلهای پیشرفتهتر نیز دیده میشود؛ برای مثال، برخی مدلهای داخلی OpenAI در حل مسائل پیچیده ریاضی با همین دشواریهای استدلالی روبهرو بودهاند.
روشهای پیشین که از هوش مصنوعی پوکر گرفته شده بودند، تنها زمانی کار میکردند که اطلاعات پنهان کم باشد. برای مثال، در پوکر تگزاس هولدم تنها ۱,۳۲۶ دست شروع ممکن است. اما در Stratego، تلاش محاسباتی مورد نیاز برای این روشها با افزایش حجم اطلاعات پنهان، بهصورت نمایی رشد میکند و سیستمها را به بنبست میکشاند.
سالها بود که این پیچیدگی حتی غولهای این حوزه را متوقف کرده بود. طبق مستندات پژوهشی، شرکت DeepMind پیشتر با سامانه DeepNash تلاش کرد این بازی را فتح کند. این سامانه روی ۱۰۲۴ گره TPU (واحد پردازش تنسور) — شبیه به هزاران پردازنده قدرتمند که در یک اتاق بزرگ برای پردازش دادههای عظیم کنار هم قرار گرفتهاند — به مدت سه ماه آموزش دید. تخمین زده میشود هزینه این فرآیند با قیمتهای سال ۲۰۲۵، بین ۳ تا ۴.۵ میلیون دلار باشد. با این حال، DeepNash در برابر بازیکنان تراز اول، از جمله اسطوره این بازی، «نیمایر» (Niemeijer)، شکست خورد. در مسابقات جهانی ۲۰۲۳، DeepNash توانست ۱۹ بازی از ۲۸ مورد را ببرد، اما در نهایت نتوانست اکثر رقبای سطح اول را شکست دهد.
جهش در بهرهوری
در مقابل، Ataraxos پیروزی خود را نه با بودجه شرکتی، بلکه با بودجه دانشگاهی به دست آورد. پژوهشگران از ۱۶ واحد پردازش گرافیکی GPU (واحد پردازش گرافیکی) — مثل موتورهای شتابدهندهای که هر لحظه هزاران محاسبه کوچک را برای رندر کردن تصاویر یا اجرای مدلها انجام میدهند — به مدت یک هفته استفاده کردند. علاوه بر این، چهار روز دیگر را روی چهار GPU برای یک شبکه باور تخصصی صرف کردند. هزینه کل این محاسبات با قیمتهای سال ۲۰۲۵، کمتر از ۸,۰۰۰ دلار بود.
این جهش در بهرهوری در مقایسه با DeepNash تکاندهنده است:
- هزینه محاسبات: ۱/۵۰۰ هزینه تلاش قبلی
- تعداد بازیهای خود-بازی (Self-play): ۱/۳۰ حجم قبلی
- نمونههای آموزشی: ۱/۱۰۰ دادههای قبلی
تیم سازنده این موفقیت را مدیون یک شبیهساز اختصاصی GPU و بهرهوری بسیار بالاتر در نمونهبرداری میداند. سوکوتا اشاره کرد که تیم آنها به دلیل محدودیت در منابع محاسباتی دانشگاهی، به ترفندهایی متکی بود که طی سالها یاد گرفته بودند. به گزارش منابع، وقتی پژوهشگران پیشنهاد رویارویی مستقیم Ataraxos و DeepNash را دادند، گوگل این درخواست را رد کرد چون کد DeepNash دیگر قابل اجرا نیست.
مکانیسم پیروزی
Ataraxos صرفاً از طریق «خود-بازی» (Self-play) و بدون هیچ دادهای از بازیهای انسانی یاد میگیرد. راز موفقیت آن در تکنیکی به نام منظمسازی (Regularization) — شبیه به یک مربی که بازیکن را مجبور میکند هر بار استراتژی متفاوتی را امتحان کند تا قابل پیشبینی نباشد — نهفته است. در Stratego، بازیکنان پیشبینیپذیر بهراحتی توسط حریف مورد بهرهبرداری قرار میگیرند؛ Ataraxos با پخش کردن چیدمانها و حرکات خود در مراحل اولیه آموزش، از این تله میگریزد.
با پیشرفت آموزش، سامانه گامهای یادگیری خود را تغییر میدهد. ابتدا با تغییرات شدید و جهشهای بزرگ شروع میکند و سپس به اصلاحات کوچک و دقیق میرسد. این کار مانع از آن میشود که فرآیند یادگیری دچار هرجومرج یا حلقههای تکراری شود، که یک شکست رایج در بازیهای با اطلاعات پنهان است. پژوهشگران منظمسازی را به یک «ذخیره انرژی» تشبیه میکنند؛ اگر AI این انرژی را خیلی سریع مصرف کند، در ابتدا پیشرفت سریعی دارد اما سپس بهراحتی قابل پیشبینی و شکست میخورد.
برای مدیریت «مه جنگ» یا همان اطلاعات پنهان، این هوش مصنوعی از یک شبکه باور (Belief Network) استفاده میکند. این شبکه هویت مهرههای پنهان حریف را پیشبینی میکند. قبل از هر حرکت، AI حالتهای احتمالی بازی را تولید کرده و یک گام یادگیری اضافی را صرفاً برای همان تصمیم اجرا میکند. نویسندگان مقاله اشاره میکنند که کارهای قبلی از این نوع جستوجو صرفنظر میکردند چون با توجه به حجم اطلاعات پنهان، بسیار دشوار تلقی میشد.
رویارویی با انسان
در مجموعهای از مسابقات که طی سه هفته در سال ۲۰۲۵ برگزار شد، Ataraxos با «نیمایر» روبهرو شد؛ مردی که چهار بار قهرمان جهان شده، ۱۵ عنوان قهرمانی ملی هلند و دو قهرمانی جهانی آنلاین را در کارنامه دارد. نیمایر بیش از ۶۰۰ هفته در صدر رتبهبندی جهانی بود و جورج فرانکا — تنها بازیکنی که در تمام مسابقات جهانی از سال ۱۹۹۷ شرکت کرده — او را «بهترین بازیکن تاریخ Stratego» مینامد.
برای اطمینان از اعتبار نتایج، پژوهشگران به نیمایر زمان کافی برای آمادهسازی دادند و برای مشارکت او ۱,۰۰۰ دلار پرداخت کردند، به علاوه ۱۰۰ دلار برای هر برد و ۵۰ دلار برای هر تساوی. نیمایر میدانست که Ataraxos نمیتواند استراتژی خود را با سبک او تطبیق دهد، اما همچنان با یک نقص ساختاری روبهرو بود. وینسنت دی بور، قهرمان سه دوره جهان، این موضوع را یک نقص بزرگ میداند که AI نمیتوانست خود را با انسان وفق دهد، در حالی که انسان میتوانست در طول بازیهای متعدد، خود را با AI تطبیق دهد.
با وجود این، Ataraxos نرخ برد ۸۵ درصدی (با احتساب تساویها به عنوان نیمبرد) را ثبت کرد. این حاشیه پیروزی در بالاترین سطح بازی، بیسابقه است. مکس روئلوفس، نایبقهرمان سه دوره مسابقات جهانی، اشاره کرد که حاشیه پیروزی در سطوح بالا معمولاً بسیار کم است زیرا بازی بازیکنان را مجبور به ریسک میکند.
عملکرد و سبک بازی
Ataraxos همچنین در یک نمایش در مسابقات جهانی ۲۰۲۵ Stratego درخشید و ۳۸ بازی از ۴۰ مورد را مقابل بازیکنان تورنمنت برد. حریفان انسانی سبک بازی او را «غیرقابل خواندن» توصیف کردند:
- ریسکپذیری: اجرای بلوفهایی که انسانها بیش از حد خطرناک میدانند.
- پشتکار: لجاجت در زمان عقب بودن که برخی بازیکنان آن را «بیادبانه» دانستند.
- دقت: شانس عجیبی در قرار دادن مهرهها در جای درست دارد، گویی همیشه مهرهها دقیقاً در نقطه مورد نیاز هستند.
فراتر از صفحه بازی
کاربرد این معماری فراتر از بازیهای تختهای است. پژوهشگران همین متد را روی سیستمهای پیچیده دیگر هم پیاده کردند:
- در Barrage Stratego، این AI در چهار سری ۵۰ بازی مقابل سه نفر از چهار بازیکن برتر جهان (که همگی دو بار قهرمان جهان Barrage بودند) پیروز شد.
- در بازی کارتی Hanabi، رکوردهای جدیدی در تمام نسخههای این بازی همکاری ثبت کرد و در نسخه دو نفره، دو مرتبه (۱۰۰ برابر) کمتر از پیشروان قبلی هزینه محاسباتی مصرف کرد.
- در بازی Dou dizhu نیز سیستمهای معیار قبلی مانند PerfectDou و DouZero را شکست داد.
این تیم با اثبات اینکه حجم زیاد اطلاعات پنهان دیگر مانعی برای یادگیری تقویتی (Reinforcement Learning) و جستوجو نیست، معتقد است که هوش مصنوعی کاربردی برای مسائل استراتژیک دنیای واقعی — مانند بازارهای مالی، درگیریهای نظامی و مذاکرات دیپلماتیک — در دسترس است، به شرطی که شبیهسازهای سریع و دقیق ساخته شوند. در بازارهای مالی نیز مدیریت دقیق نقاط خروج و ورود حیاتی است، مشابه آنچه در راهکارهای KestrelQuant برای حفظ سرمایه مشاهده میکنیم.
تنها محدودیت فعلی این است که متد جستوجوی فعلی، تنها یک گام یادگیری را تقلید میکند؛ یعنی نمیتوان صرفاً با دادن زمان محاسباتی بیشتر در حین بازی، عملکرد را بهبود داد. یک متد جستوجوی پیچیدهتر میتواند این سقف را بشکند. تیم سازنده کد Ataraxos را بهصورت عمومی منتشر کرده است.
گام بعدی شما
- اگر توسعهدهنده هستید، کد باز Ataraxos را بررسی کنید تا با مکانیزم Regularization در محیطهای با اطلاعات ناقص آشنا شوید.
- در مورد کاربرد Belief Networks برای پیشبینی متغیرهای پنهان در تحلیل دادههای تجاری مطالعه کنید.
- منتظر گزارشهای مربوط به استقرار این متد در شبیهسازهای نظامی و مالی باشید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و بهینهسازی استنتاج مراجعه کنید.



گفتگو