تصور کنید برای هر سؤال ساده، یک کتابدار ۱۰ جلد کتاب جلوی شما میگذارد؛ او شاید هر ۱۰ کتاب را پیدا کرده باشد، اما شما فقط به یک صفحه از یکی از آنها نیاز دارید. این دقیقاً همان بحرانی است که حافظههای هوش مصنوعی امروز با آن دستوپنجه نرم میکنند.
طبق گزارش توسعهدهندهای به نام n0mad-ai، شکاف عمیقی میان «یافتن» یک خاطره و «استفاده» از آن وجود دارد. در یک آزمون یکهفتهای که در ۱۵ سپتامبر ۲۰۲۶ به پایان رسید، سیستم ۴.۱ میلیون توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولون که مدل تکهتکه میخورد — را در پنجره زمینه (Context Window) نوشت، اما تنها بخش کوچکی از این دادهها واقعاً به کار آمدند.
بسیاری از سیستمهای حافظه بر معیار «نرخ موفقیت» یا Hit Rate تکیه میکنند؛ یعنی اینکه آیا جستوجو توانست سند مرتبط را پیدا کند یا خیر. اما این معیار نمیگوید آیا آن داده واقعاً به دستیار کمک کرد یا فقط فضای حافظه را اشغال کرد. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی استنتاج اشاره کردیم، مدیریت بهینه فضای متنی، کلید کاهش هزینهها و افزایش سرعت است. در همین راستا، پیادهسازی امتیاز اعتماد به دادهها میتواند سدی در برابر خطاهای هوش مصنوعی پیش از استنتاج باشد تا از ورود دادههای غیرضروری به مدل جلوگیری شود.
این توسعهدهنده با استفاده از ابزار متنباز Bastra-Recall، تعداد ۲۱,۵۶۹ رویداد را رصد کرد. نتایج این ممیزی، ناکارآمدی شدید در حجم دادهها را فاش میکند:
- کل توکنها: ۴,۱۳۶,۵۳۵ توکن نوشته شده در پنجره زمینه.
- نرخ نمایش: ۲,۳۲۶ خاطره بهعنوان «مطالعه ضروری» ارائه شدند.
- نرخ بارگذاری: تنها ۳۵ خاطره واقعاً بارگذاری شدند (۱.۵٪).
- کارایی بازیابی: تنها ۴.۱٪ از کل موارد یافتشده منجر به بارگذاری شد.
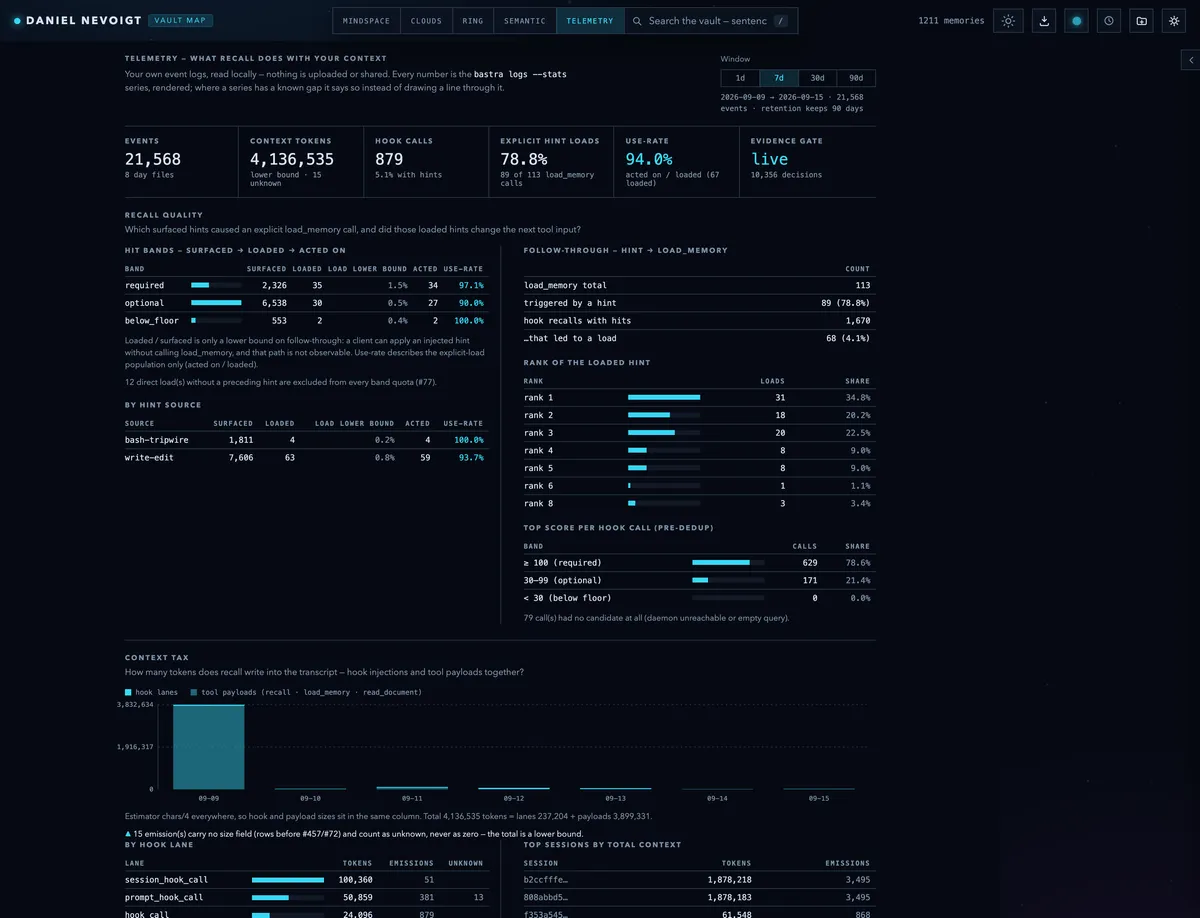
به نقل از مستندات این پروژه، نکته عجیب اینجاست که کیفیت انتخابها بالا بود. از ۳۵ خاطره بارگذاریشده، ۳۴ مورد بهطور ملموس خروجی مدل را تغییر دادند که یعنی نرخ استفاده ۹۷٪ است. این یعنی الگوریتم رتبهبندی درست کار میکرد، اما سیستم نمیتوانست در برابر دادههای بیربط «ساکت» بماند. این چالش نشان میدهد که امتیاز اعتماد به دادهها همچنان حلقهٔ گمشده در نظارت بر سیستمهای هوش مصنوعی است و بدون آن، تفکیک دادههای مفید از نویز دشوار است.
برای توسعهدهندگان، این یافته هدف بازی را تغییر میدهد. چالش اصلی در حافظه هوش مصنوعی دیگر پیدا کردن «سوزن در انبار کاه» نیست، بلکه این است که سیستم هر بار سوزن را پیدا میکند، کل انبار کاه را هم با خودش بیاورد. در واقع، استفاده از امتیاز اعتماد دادهها راهکاری برای شناسایی ریشهٔ خطاهای هوش مصنوعی در چنین سناریوهایی است.
گام بعدی شما
- اگر از سیستمهای RAG استفاده میکنید، بهجای تمرکز بر Hit Rate، نرخ بارگذاری واقعی (Load Rate) را اندازه بگیرید.
- ابزار Bastra-Recall را از گیتهاب نصب کنید تا متوجه شوید آیا مدل شما پنجره متنی را با دادههای زاید پر میکند یا خیر.
- استراتژیهای فیلترینگ سختگیرانهتر را برای کاهش نویز در ورودی مدل پیاده کنید.
اما داستان سختافزاری این تحول و فشار بر VRAM حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو