پرش به محتوای اصلی
پرش به محتوای مقاله

گزارش بایدو: کاهش ۹۴ درصدی هزینه آموزش Ernie 5.1 در مسیر رقابت با GPT-5.5

·۲۱ اردیبهشت ۱۴۰۵۴ دقیقه مطالعه۲ بازدید
گزارش بایدو: کاهش ۹۴ درصدی هزینه آموزش Ernie 5.1 در مسیر رقابت با GPT-5.5
اشتراک‌گذاری

تصور کنید بتوانید عملکرد یکی از پیشرفته‌ترین مدل‌های جهان را با تنها ۶ درصد از هزینه‌های معمول به دست آورید. اگر فکر می‌کنید برای رسیدن به سطح GPT-5.5 حتماً به هزاران پردازنده گرافیکی و بودجه‌های نجومی نیاز است، باید نگاهی به استراتژی جدید بایدو بیندازید.

طبق اعلام بایدو (Baidu)، مدل جدید Ernie 5.1 در تاریخ ۹ مه ۲۰۲۶، با کسب ۱۲۲۳ امتیاز، رتبه چهارم جهانی را در جدول Arena Search به دست آورده است. این دستاورد در حالی رخ داده که هزینه‌های پیش‌آموزش (Pre-training) این مدل ۹۴ درصد کاهش یافته است. این خبر در زمانی منتشر می‌شود که صنعت هوش مصنوعی زاینده (Generative AI) — تشبیه روزمره: مثل کتابخانه‌داری که میلیاردها صفحه را خوانده و حالا با همان لحن کتاب‌ها جواب می‌دهد — از تمرکز بر مقیاس خام به سمت بهره‌وری پایدار حرکت می‌کند.

همان‌طور که در تحلیل‌های پیشین ما درباره‌ی قوانین مقیاس‌پذیری (Scaling Laws) اشاره کردیم، پیش از این تصور می‌شد افزایش قدرت مدل‌ها مستقیماً با افزایش اندازه و هزینه گره خورده است. اما بایدو با تکیه بر مدل ۲.۴ تریلیون پارامتری Ernie 5.0 که در ژانویه ۲۰۲۶ عرضه شد، ثابت کرد که «کم‌حجم‌تر» بودن لزوماً به معنای «ضعیف‌تر» بودن نیست.

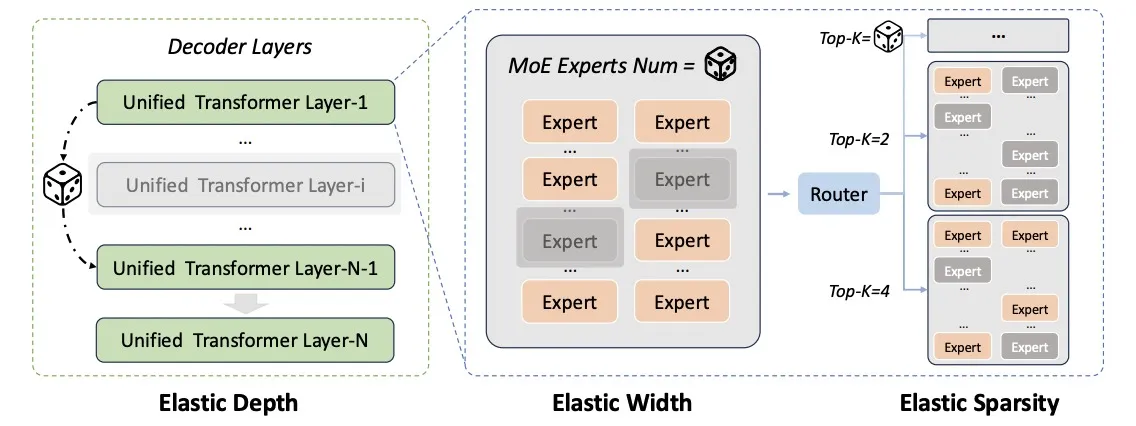
Schema des Once-For-All-Trainings in drei Abschnitten. Links ein Stapel grüner Transformer-Schichten als „Elastic Depth", in der Mitte ein Raster aus Experten-Bausteinen als „Elastic Width", rechts drei Routing-Konfigurationen mit Top-K = 1, 2 und 4 als „Elastic Sparsity".

بر اساس مستندات فنی، این کاهش هزینه مدیون چارچوب آموزشی الاستیک «Once-For-All» است که اجازه می‌دهد خانواده‌ای از مدل‌ها با عمق و تعداد متخصصان مختلف، تنها در یک دوره‌ی آموزش بهینه شوند. همچنین بایدو سیستم یادگیری تقویت‌شده (RL) خود را بازنگری کرده و برای جلوگیری از «اثر الاکلنگی» (که در آن بهبود یک مهارت باعث افت مهارت دیگر می‌شود)، یک خط لوله چهار مرحله‌ای را پیاده کرده است:

  • تنظیم دقیق (Fine-tuning) — تشبیه روزمره: مثل وقتی به یک پزشک عمومی، تخصص پوست می‌دهیم تا روی یک حوزه دقیق شود — نظارتی مشترک روی مجموعه‌داده‌های گسترده.
  • آموزش موازی متخصصان برای کدهای برنامه‌نویسی، استدلال و وظایف عامل‌محور (Agentic).
  • تقطیر (Distillation) — تشبیه روزمره: مثل خلاصه‌سازی یک کتاب قطور در یک برگه تقلب برای انتقال دانش به مدل کوچک‌تر — مدل دانش‌آموز برای تثبیت اطلاعات.
  • یادگیری تقویت‌شده عمومی برای گفتگوهای آزاد و کارهای خلاقانه.
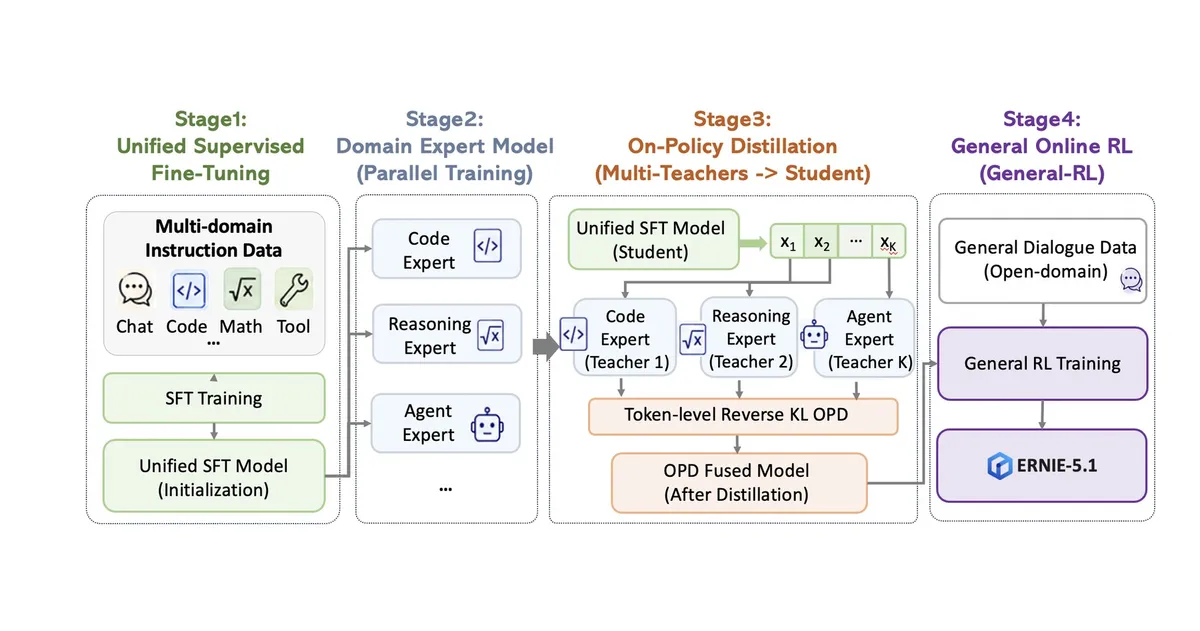
Flussdiagramm der vierstufigen Post-Training-Pipeline. Stage 1: Unified Supervised Fine-Tuning auf Instruktionsdaten aus Chat, Code, Mathe und Tool-Nutzung. Stage 2: parallele Spezialisierung in Code-, Reasoning- und Agent-Experten. Stage 3: On-Policy Distillation, in der ein Schüler-Modell per Token-Level Reverse KL von mehreren Lehrer-Modellen lernt. Stage 4: General Online RL auf offenen Dialogdaten, am Ende steht Ernie 5.1.

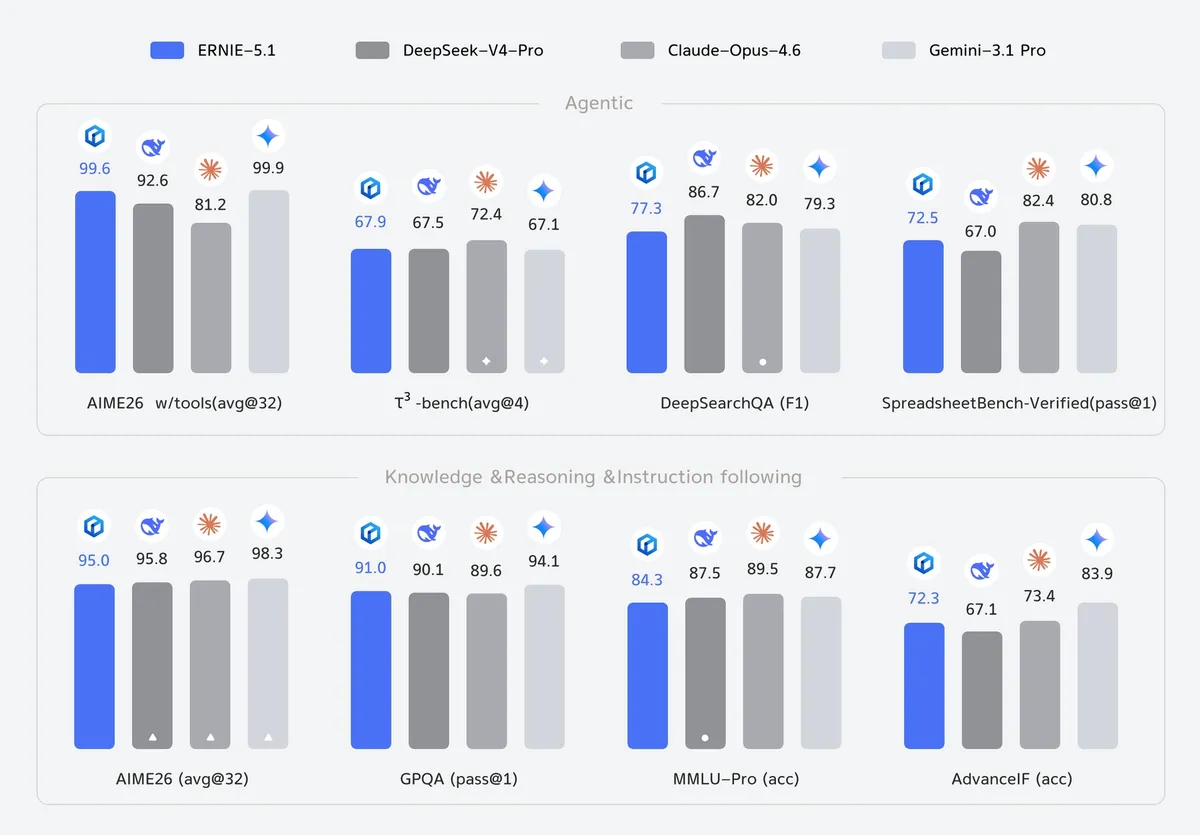
به نقل از گزارش the-decoder.com، در آزمون‌های رودررو، Ernie 5.1 در وظایف مربوط به عامل (Agent) های خودمختار، مدل DeepSeek-V4-Pro را شکست داد و در بنچمارک‌های GPQA و MMLU-Pro تقریباً با Gemini 3.1 Pro گوگل برابر شد.
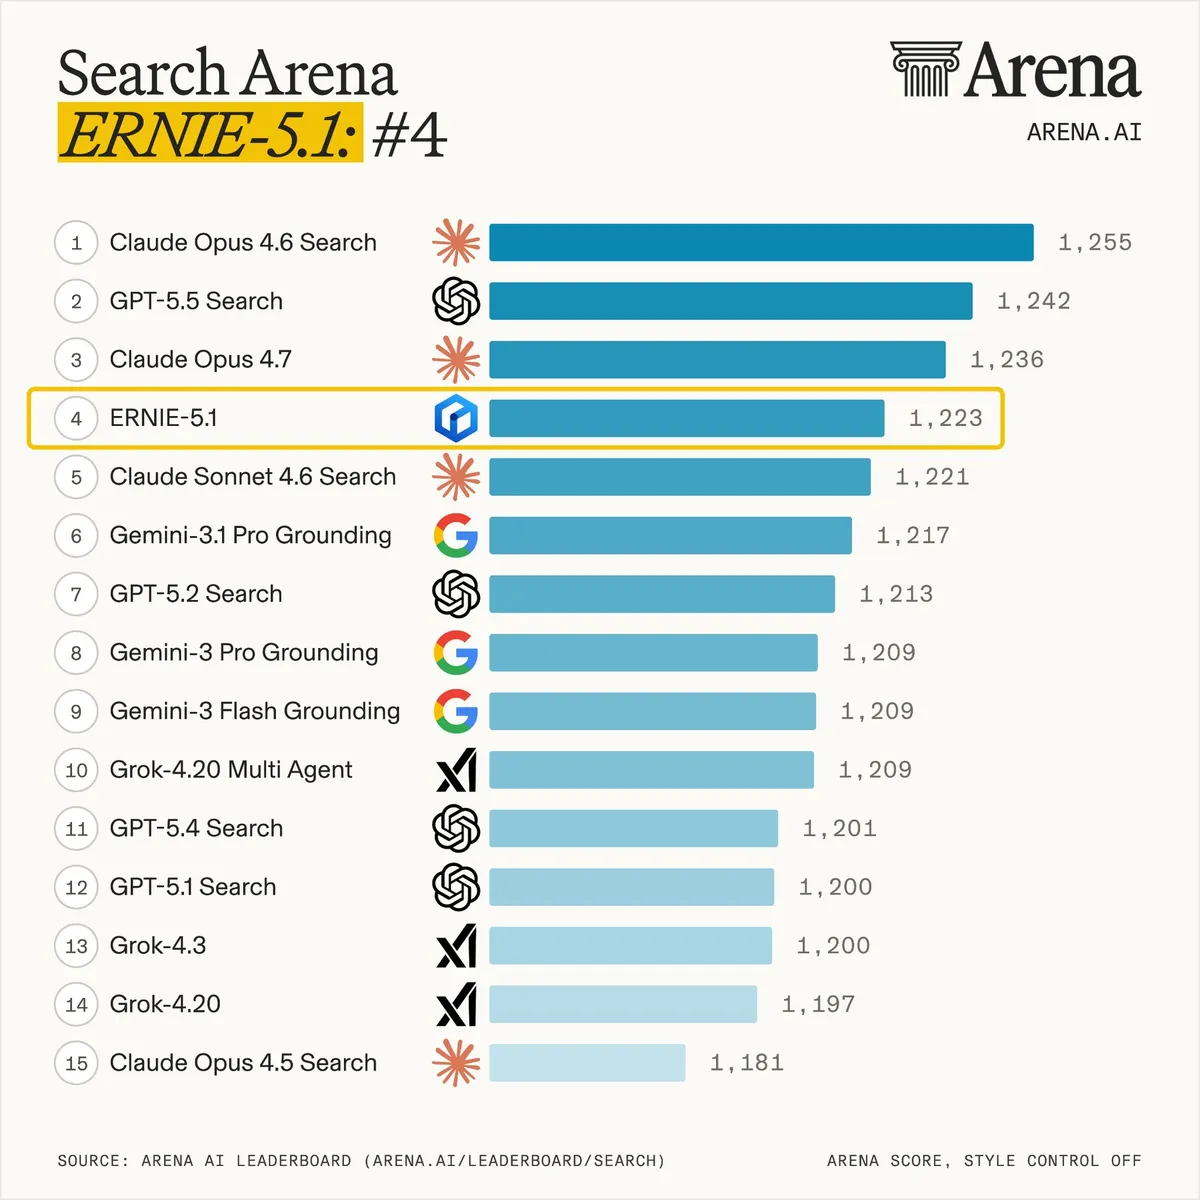
Balkendiagramm des Search-Arena-Leaderboards mit 15 Modellen. Ernie 5.1 belegt mit 1.223 Punkten Platz 4, hinter Claude Opus 4.6 Search (1.255), GPT-5.5 Search (1.242) und Claude Opus 4.7 (1.236).

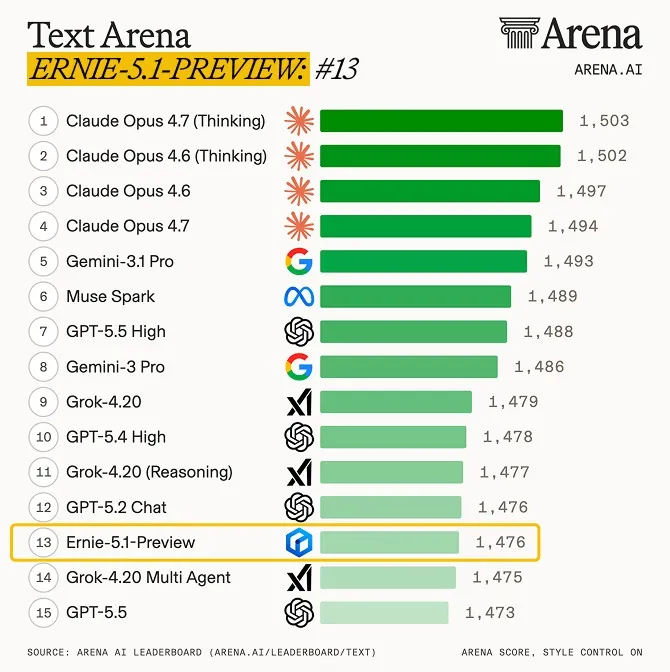
Balkendiagramm des Text-Arena-Leaderboards mit 15 Modellen. Ernie-5.1-Preview belegt mit 1.476 Punkten Platz 13. Die Liste wird angeführt von Claude Opus 4.7 (Thinking) mit 1.503 Punkten, gefolgt von Claude Opus 4.6 (Thinking), Claude Opus 4.6 und Claude Opus 4.7.

Balkendiagramme vergleichen Ernie 5.1, DeepSeek V4 Pro, Claude Opus 4.6 und Gemini 3.1 Pro in acht Benchmarks. Im oberen Block (Agentic) liegt Ernie 5.1 bei AIME26 mit Werkzeugen bei 99,6 Punkten, knapp hinter Gemini 3.1 Pro mit 99,9; in SpreadsheetBench-Verified erreicht das Modell 72,5 Punkte und liegt damit vor DeepSeek V4 Pro, aber hinter den beiden Konkurrenten. Im unteren Block (Knowledge, Reasoning, Instruction Following) liegen die Werte näher beieinander, Ernie 5.1 schneidet hier meist als zweit- oder drittstärkstes Modell ab.

این تحول برای رهبران کسب‌وکار یک پیام روشن دارد: برنده میدان نبرد هوش مصنوعی دیگر کسی نیست که GPU بیشتری دارد، بلکه کسی است که معماری آموزشی بهینه‌تری طراحی می‌کند. بایدو با جدا کردن «قابلیت‌های پیشرو» از «هزینه‌های محاسباتی سرسام‌آور»، بازی را تغییر داده است.

گام بعدی شما

  • اگر توسعه‌دهنده هستید، بررسی کنید که آیا مدل‌های کوچک‌تر با تقطیر دانش می‌توانند جایگزین مدل‌های گران‌قیمت شما شوند یا خیر.
  • استقرار این مدل در پلتفرم‌های خلاقانه مانند Isekai Zero را دنبال کنید تا میزان واقع‌گرایی ادعاهای بایدو در دنیای واقعی مشخص شود.
  • تحلیل‌های مربوط به بهینه‌سازی حافظه در مدل‌های زبانی را مطالعه کنید.

اما داستان سخت‌افزاری این تحول حتی شگفت‌انگیزتر است — به تحلیل ما درباره‌ی تراشه‌های Blackwell و اثر آن‌ها بر هزینه استنتاج (Inference) مراجعه کنید.

چرا این موضوع مهم است؟

این دستاورد با تکیه بر اعتبار مهندسی بایدو، سد ورود به دنیای مدل‌های پیشرو را می‌شکند. کاهش هزینه‌ها به این معناست که شرکت‌های کوچک‌تر نیز می‌توانند مدل‌هایی با سطح استدلالی بالا را بدون نیاز به بودجه‌های میلیارد دلاری توسعه دهند.

این گزارش با خط‌لولهٔ خودکار دات‌هوش از منابع معتبر جهانی تدوین و زیر نظر تحریریه منتشر شده است. روش کار ما

گفتگو

پنج‌شنبه‌های هوش‌محور

بسته‌ی هفتگی دات‌هوش

۵ خبر، ۲ ابزار، ۱ پرامپت در هر شماره. به‌زودی راه‌اندازی می‌شود — هر پنج‌شنبه صبح.

خبر کلیدی
ابزار کاربردی
پرامپت حرفه‌ای
تحلیل پژوهش
به‌زودی
زاویه‌ی ایرانی
به‌زودی
تمرین این هفته
به‌زودی

راهنماهای دات‌هوش

راهنماهای کاربردیِ دات‌هوش برای کار با هوش مصنوعی — از همین‌جا شروع کنید:

دات‌هوش

راهنمای فارسی هوش مصنوعی — با نگاه به ایران

اخبار روزانه، معرفی ابزارها و مدل‌ها، و آموزشِ کار با هوش مصنوعی؛ همیشه با این پرسش که از ایران چه چیزی کار می‌کند و چه چیزی نه.