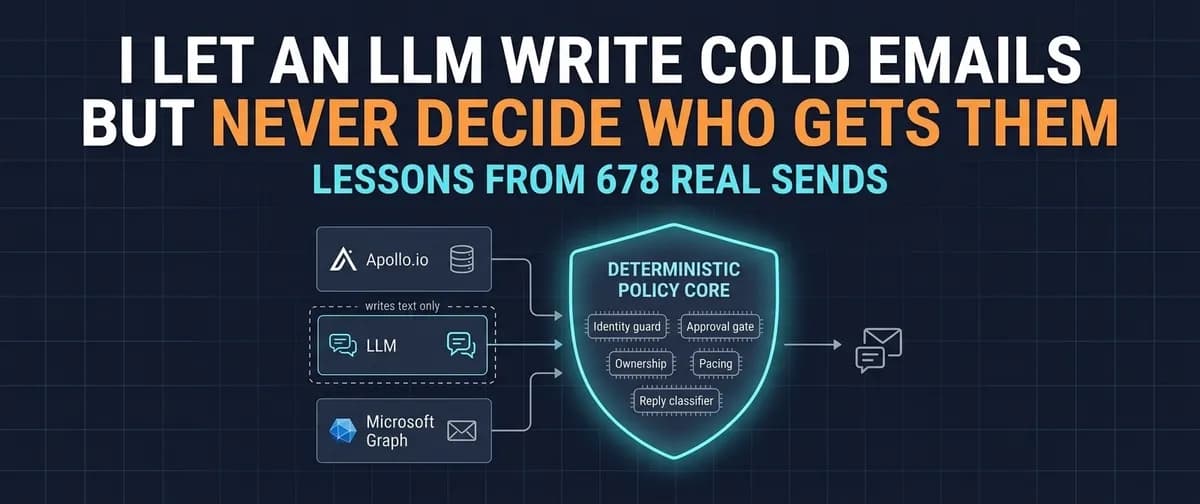
اگر امروز یک عامل هوش مصنوعی را مسئول مدیریت صندوق ورودی ایمیلهای شرکتتان کنید، احتمالاً با یک فاجعهٔ ارتباطی روبرو خواهید شد. دادههای حاصل از ارسال ۶۷۸ ایمیل سرد در ۹ هفته ثابت میکند که سپردن کنترل عملیاتی به یک مدل زبانی، دستورالعملی برای نابودی اعتبار برند است. این سامانه که برای جذب توزیعکنندگان بینالمللی یک صادرکننده مواد غذایی طراحی شده بود، نشان داد مدلهایی در سطح GPT-4o در نوشتن متن عالی هستند، اما در تصمیمگیری درباره اینکه «چه کسی» و «چه زمانی» پیامی دریافت کند، بهشدت غیرقابلاعتمادند.
این استقرار در زمانی رخ میدهد که بسیاری از سازمانها با عجله به سمت عاملهای کاملاً خودمختار پیش میروند. در حالی که برخی استارتاپها مانند Ando تلاش میکنند با ایجاد اینباکسهای اختصاصی برای عاملهای هوش مصنوعی، واسطههای انسانی را حذف کنند، این مطالعه موردی شکاف عمیقی میان فصاحت زبانی مدلها و قابلیت اطمینان عملیاتی آنها را برجسته میکند. با تکیه بر پوشش قبلی ما درباره اینکه چگونه همراستاسازی ایمنی (Safety Alignment) میتواند در شبیهسازیهای پیچیده، رفتار عامل را وارونه کند، برای اکثر کسبوکارها، ریسک اصلی نه یک توهم ساده در واقعیتها، بلکه تخریب رابطه با مشتری به دلیل یک اشتباه خودکار است.
معماری جداسازی
توسعهدهنده برای جلوگیری از ابداع محصولات توسط هوش مصنوعی یا ارسال پنج ایمیل تکراری به یک شخص، استراتژی سختگیرانه «جعبهای» (Box Strategy) را اجرا کرد. در این ساختار، مدل زبانی بزرگ (LLM) فقط اجازه دارد متن بنویسد یا از لیستهای بسته گزینهای را انتخاب کند، اما هرگز اجازه ندارد دستور ارسال (Send) را صادر کند. تمام پیامدهای تجاری و اعتباری توسط توابع TypeScript مدیریت میشوند که به صورت واحد-تست (Unit-tested) نوشته شدهاند و هیچ دسترسی مستقیمی به پایگاهداده یا شبکه ندارند.
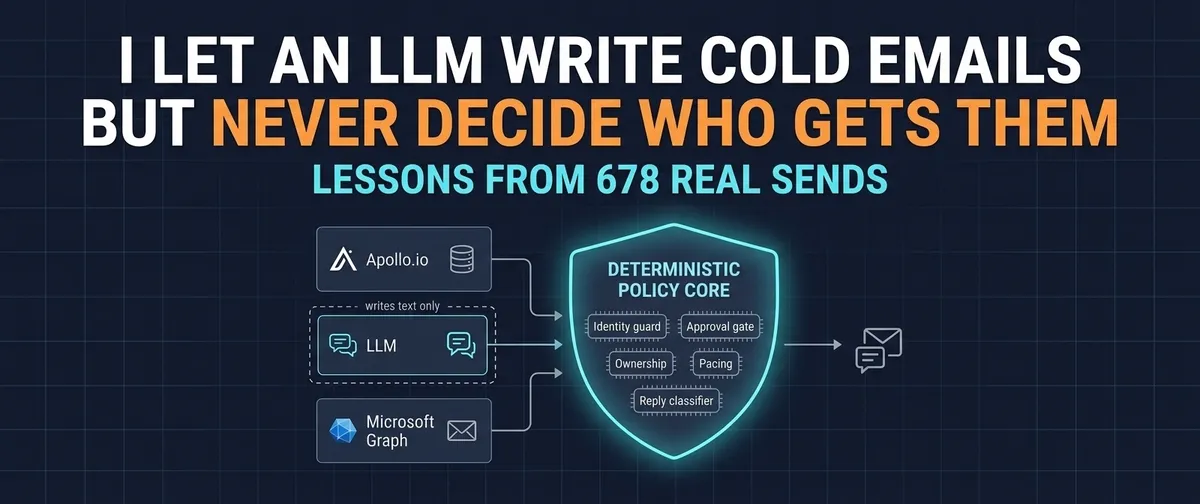
زیرساخت فنی این پروژه شامل Next.js (با استفاده از App Router و TypeScript)، MongoDB و Apollo.io برای غنیسازی لیدهاست و مدیریت صندوقهای پستی واقعی بر عهده Microsoft Graph است. این سامانه در مقیاس قابلتوجهی ساخته شده و شامل ۵۷ مسیر API، ۱۷ صفحه و حدود ۳۱ هزار خط کد TypeScript است. این پیچیدگی در پیادهسازی، یادآور چالشهای مدیریت خط لولههای LLM و صفهای پردازش است که در آن هرگونه نقص در زیرساخت میتواند منجر به فروپاشی کل سیستم شود.
هستهٔ سیاستگذاری قطعی
به جای اجازه دادن به مدل برای هدایت مسیر، یک هستهٔ سیاستگذاری قطعی (Deterministic Policy Core) طراحی شد. این هسته منطقهای پرریسک را بر عهده دارد: تطبیق هویت، گیتهای تأیید، مالکیت لید، سرعت ارسال و طبقهبندی پاسخها.
یک درس معماری مهم، یکپارچهسازی مسیرها بود. در نسخههای اولیه، فرستندهٔ زمانبندیشده نسخهای مجزا از شرایط صف داشت. این بدان معنا بود که قوانین ایمنی که بعداً اضافه شدند، روی مسیرهای بدون نظارت (Unattended) اعمال نمیشدند. با انتقال تمام منطق به ماژولهای سیاستگذاری مشترک که هم توسط مسیرهای تعاملی و هم توسط کارهای زمانبندیشده (Scheduled Jobs) فراخوانی میشوند، توسعهدهنده توانست کل این دسته از باگها را حذف کند.
خطر اول: توهم شناسهها
یکی از نقاط شکست اصلی زمانی رخ داد که مدل سعی کرد شناسههای داخلی ۲۴ کاراکتری مربوط به Apollo.io را تولید کند. یک شناسه نامعتبر باعث کرش کردن کل عملیات جستوجو با یک خطای نامفهوم میشد. برای حل این مشکل، توسعهدهنده مدل را محدود کرد تا نام صنایع را فقط از یک لیست ثابت ۸۲ گزینهای که در پرامپت ارسال میشد، انتخاب کند.
سپس سرور این نامها را با استفاده از یک کاتالوگ استخراجشده از Apollo به شناسههای واقعی تبدیل میکند. مقادیر مربوط به ارشدیت (Seniority) و اندازه شرکت نیز به طور مشابه با مجموعههای بسته چک میشوند و هر مقداری خارج از این مجموعهها به طور بیصدا حذف میشود.
حتی با این محدودیت، مدل دچار خطاهای حذف (Errors of Omission) شد. وقتی از مدل خواسته شد توزیعکنندگان شیرینیجات را پیدا کند، به طور مداوم گزینههای «واردات/صادرات»، «عمدهفروشی» و «لجستیک» را انتخاب کرد اما «غذا و نوشیدنی» را نادیده گرفت. چون این فیلترها با عملگر OR ترکیب شده بودند، سیستم بدون هیچ خطایی اما به طور ناقص عمل کرد و دامنه دسترسی کمپین را کوچک کرد. برای حل این مورد، یک قابلیت بازبینی دستی (Override) برای اپراتور اضافه شد تا لیست صنایع را تثبیت کند.
خطر دوم: نگهبان هویت
تطبیق تقریبی (Fuzzy Matching) در پایگاههای داده لیدها اغلب یک غریبهٔ محتمل را برمیگرداند؛ کسی که نام کوچک مشابهی دارد و در شرکتی با نامی مشابه کار میکند. اگر یک LLM کورکورانه این دادهها را پیوست کند، ایمیلی شخصیسازیشده با عنوان شغلی اشتباه ارسال میکند.
برای مقابله، یک تابع «نگهبان هویت» (Identity Guard) ساخته شد. منطق این تابع از یک سلسلهمراتب سختگیرانه پیروی میکند:
- تطبیق دقیق: اگر ایمیل بازگشتی دقیقاً با ایمیل پرسوجو یکی باشد، پذیرفته میشود.
- عدم تطبیق تأییدشده: اگر یک ایمیل تأییدشده متفاوت بازگردد، به عنوان شخص دیگر رد میشود.
- آدرس پنهان: اگر آدرس پنهان باشد، سیستم نیاز دارد که هم دامنه شرکت و هم نام خانوادگی مطابقت داشته باشند. این مقایسه پس از نرمالسازی یونیکد و حذف علامتهای خاص (Accent Stripping) انجام میشود.
آدرسهای لینکدین نیز با همین تردید بررسی میشوند. آنها تنها در صورتی نگه داشته میشوند که بخش انتهایی URL (Slug) حاوی نام شخص باشد. اگر هر دو نام و نام خانوادگی شناخته شده باشند، هر دو الزامی هستند، زیرا یک نام کوچک رایج به تنهایی اغلب منجر به پروفایل اشتباه میشود.
خطر سوم: ابداع ارزشهای فرستنده
مدلهای زبانی وقتی فقط نام شرکت را میبینند، با اعتمادبهنفس کامل قیمتها، مدارک و ویژگیهای محصول را اختراع میکنند. توسعهدهنده این مشکل را با تبدیل «قالب تأییدشده فرستنده» به تنها منبع حقیقت حل کرد. پرامپت صراحتاً مدل را از آوردن هرگونه ادعا، آمار، بازه زمانی یا اعتباری که در آن قالب وجود ندارد، منع میکند.
برای شخصیسازی پیام، سیستم ۴۰۰۰ کاراکتر اول متن وبسایت گیرنده را به پرامپت تزریق میکند. سپس یک پردازش قطعی پس از تولید متن، خروجی را پاکسازی میکند: امضاهای تولیدشده توسط AI را حذف میکند (امضای واقعی بعداً اضافه میشود) و اگر مدل لینک ارائه را حذف کرده باشد، آن را بازمیگرداند.
ترجمه به عنوان یک فراخوان ساختاریافته مجزا با دمای (Temperature) پایین مدیریت میشود. قوانین خاصی تضمین میکنند که توکنهای قالب، URLها، نام برندها و نامهای شخصی بدون تغییر باقی بمانند. برای جلوگیری از تغییرات بیصدا، یک نسخه منجمد از پیام دقیقاً همانطور که قرار است ارسال شود ذخیره میشود تا ویرایشهای بعدی در قالب، ایمیلهای تأییدشده قبلی را تغییر ندهد.
خطر چهارم: قفل در سطح شرکت
در بازاریابی B2B، واحد تجربه «شرکت» است، نه فرد. بدون یک قفل قطعی، ممکن است چندین نماینده فروش به طور تصادفی یک شرکت را هدف قرار دهند. سامانه مالکیت را بر اساس اولین وارد کردن (Import) تعیین میکند: اولین نمایندهای که یک آدرس را وارد کند، مالک آن مخاطب است و اولین کسی که هر آدرسی از یک دامنه شرکت را وارد کند، مالک کل آن شرکت میشود.
برای جلوگیری از قفلهای جهانی، دامنههای رایگان (Gmail, Outlook, Yahoo, GMX) از ادعای مالکیت دامنه مستثنی شدند. در غیر این صورت، یک لید Gmail میتوانست تمام کاربران Gmail در جهان را تصاحب کند.
دو مهر زمانی (Stamp) خاص جریان اتوماسیون را مدیریت میکنند:
- مهر ارتباط (Outreach Stamp): وقتی به هر کسی در یک شرکت پیام داده شود، تمام افراد دیگر در آن دامنه مهر میخورند و صف بدون نظارت از آنها میگذرد.
- مهر پاسخ (Reply Stamp): وقتی هر کسی در یک شرکت پاسخ دهد، مهر دوم تمام اتوماسیونها را برای کل آن شرکت متوقف میکند.
این safeguard توانست ۱۲۹ ارسال تکراری را در طول ۹ هفته متوقف کند.
خطر پنجم: عبور از فیلترهای اسپم
فیلترهای اسپم، فورشهای ریتمیک (Rhythmic Bursts) که مشخصه اسکریپتهای خودکار است را تشخیص میدهند. برای شبیهسازی رفتار انسانی، سیستم یک فاصله تصادفی بین ارسالها ایجاد میکند. این فاصله با فرمول g = max(1, round((W / N) × (0.5 + u))) محاسبه میشود که در آن u یک متغیر تصادفی یکنواخت بین ۰ و ۱، W پنجره ارسال به دقیقه و N هدف روزانه است. این نوسان ۵۰٪، نظم ساعتمانند ارسالها را از بین میبرد.
این منطق در خودِ روتین ارسال تعبیه شده است، نه فقط در زمانبندی (Scheduler). این امر تضمین میکند که حتی اگر یک Cron Job اشتباه پیکربندی شده باشد، سیستم نمیتواند ایمیلی در ساعت ۳ صبح ارسال کند، زیرا پنجره پیشفرض از ساعت ۰۷:۰۰ تا ۱۹:۰۰ اجبار میشود.
خطر ششم: تلهٔ پاسخدهندههای خودکار
تشخیص پاسخ انسانی از پیامهای «خارج از دفتر» (OOO) حیاتیترین ماژول است. تلقی کردن یک OOO به عنوان علاقه، یک لید زنده را از صف حذف میکند، در حالی که تلقی کردن یک پاسخ واقعی به عنوان نویز، منجر به مزاحمت برای مشتریای میشود که قبلاً پاسخ داده است.
طبقهبندیکننده از یک مجموعه قوانین قطعی و ترتیبی استفاده میکند. ترتیب در اینجا حیاتی است زیرا یک Bounce میتواند خودکار به نظر برسد و یک پاسخ خودکار میتواند حاوی کلمه «unsubscribe» باشد.
- بونسها (Bounces): شناسایی از طریق فرستنده (مانند mailer-daemon)، هدرهای
multipart/reportباreport-type=delivery-statusیا موضوعات مربوط به شکست در تحویل. - پاسخهای خودکار: تشخیص از طریق هدرهای
Auto-Submitted(RFC 3834)، هدرهای تعطیلات، موضوعات پاسخدهنده خودکار در ۸ زبان مختلف، یا عبارات آغازین که نشان میدهد شخص حضور ندارد. برای جلوگیری از شناسایی اشتباه تعطیلاتی که در امضا ذکر شدهاند، فقط ۳۰۰ کاراکتر اول بررسی میشوند. - لغو عضویت (Opt-outs): فعال شدن با عبارات صریح مانند «remove me» یا «do not contact». کلمه «unsubscribe» تنها در صورتی محاسبه میشود که متن جدید زیر ۶۰۰ کاراکتر باشد، زیرا این کلمه معمولاً در فوتر خبرنامهها ظاهر میشود.
- پاسخها: هر چیزی که از سه فیلتر اول عبور کند.
قبل از تطبیق، سیستم متن تازه نوشته شده را از تاریخچه نقلشده (Quoted History) جدا میکند تا فوتر نقلشده یک خبرنامه توسط گیرنده، به عنوان لغو عضویت شناسایی نشود. هر طبقهبندی یک دلیل قابل خواندن برای انسان (مثلاً "header Auto-Submitted: auto-replied") برای بازرسی ذخیره میکند.
اعداد سخت
در ۹ هفته با ۶ نماینده فروش، سامانه ۲,۰۸۸ رکورد لید را پردازش و به ۵۲۷ گیرنده دسترسی پیدا کرد. از ۶۷۸ پیام ارسالی، ۱۵۴ پیام ورودی پردازش شد:
- پاسخهای انسانی: ۹۶ مورد (از ۴۲ مخاطب)
- پاسخهای خودکار: ۳۵ مورد (۲۲.۷٪ ورودیها)
- بونسها: ۲۳ مورد
- ارسالهای تکراری متوقفشده: ۱۲۹ مورد
- اسکریپتهای تست / Assertions: ۳۴ / ۹۸۳
نکته حیاتی این است که یک تشخیصدهنده ساده، علاقه انسانی را ۳۶٪ بیشتر تخمین میزد و پیگیری برای ۳۵ مشتری واقعی را زودتر از موعد متوقف میکرد. بسیاری از این پاسخهای خودکار با همان موضوع اصلی ایمیل رسیده بودند و عدم حضور شخص را فقط در بدنه پیام و به زبانهای اسپانیایی، فرانسوی یا آلمانی اعلام کرده بودند. علاوه بر این، تقریباً یکسوم پیامهای مرتبط از طرف یک همکار ارسال شده بود نه گیرنده اصلی؛ تشخیصدهندهای که فقط روی آدرس گیرنده متمرکز باشد، به تعقیب مخاطب اصلی ادامه میداد.
همچنین، ۷۲.۷٪ لیدها به زبانهایی غیر از انگلیسی مورد مخاطبه قرار گرفتند، مقیاسی که مدیریت دستی آن برای تیم غیرممکن بود.
درسهایی از شکست
همه چیز عالی نبود. توسعهدهنده اشاره کرد که زمانبندی در ابتدا کار نمیکرد زیرا هیچ چیزی Endpoint را فراخوانی نمیکرد. در هفتههای اول، در ماه اوت تنها ۶ پیام ارسال شد در حالی که در سپتامبر این عدد به ۵۶۷ رسید. آنها مجبور شدند یک نشانگر زنده «ارسال بعدی» اضافه کنند تا بین چهار حالت تمایز قائل شوند: ارسال خاموش، رسیدن به هدف، خارج از ساعات کاری، یا صف خالی.
محاسبات سرعت ارسال نیز به دو اصلاح نیاز داشت. اول، توسعهدهنده تقسیم را بر ۱۴۴۰ دقیقه (یک شبانهروز) انجام داده بود به جای پنجره ۱۲ ساعته ارسال، که باعث شد هدف ۵۰ ارسال تنها ۲۵ مورد را تحویل دهد. دوم، چون سیستم در هر تیک (Tick) حداکثر یک پیام میفرستد، فاصله ۱۳ دقیقهای در یک تیک ۱۰ دقیقهای به ۲۰ گرد میشد و هدف ۵۰ را به ۳۷ کاهش میداد. انتقال به تیک سه دقیقهای این تلفات را به زیر ۱۰٪ رساند.
محدودیتهای دسترسی نیز اصطکاک ایجاد کرد. با انتخاب Mail.Read به جای Mail.ReadWrite برای به حداقل رساندن ریسکهای امنیتی، توسعهدهنده متوجه شد که تمام ۲۸ شکست در ارسال به دلیل پیوستهای بالای ۲.۵ مگابایت بود (که نیاز به آپلود تکهای و دسترسی به پیشنویس دارد). همچنین پیگیریها را نمیشد به صورت Reply در رشته ایمیل قرار داد. راهکار برنامهریزی شده، یک Service Principal مجزا با دسترسی ReadWrite محدود به صندوقهای فروش است.
در نهایت، سیستم امتیازدهی لیدها (۰ تا ۱۰۰) شکست خورد زیرا به یک سیگنال بالادستی از Apollo.io متکی بود که هرگز فعال نشد. ۸۹٪ لیدها در سطح «بالا» قرار گرفتند (میانگین ۷۷.۸) زیرا مقدار وضعیت ایمیل برای ۱,۱۶۶ مخاطب گم شده بود. این ثابت کرد که امتیازی که بر اساس یک سیگنال خاموش ساخته شده باشد، بدون هشدار تخریب میشود.
تحلیل: مرگ فانتزی «عامل»
این مطالعه موردی این ایده را که یک LLM میتواند یک عامل «نصب و اجرا» (Plug-and-play) برای عملیات حساس تجاری باشد، از بین میبرد. ارزش هوش مصنوعی در اینجا در خودمختاری آن نیست، بلکه در تواناییاش برای مقیاسبندی متون شخصیسازی شده در چندین زبان است.
برای توسعهدهنده عملی، نتیجه روشن است: LLM یک نویسنده است، نه یک مدیر. هر منطقی که شامل پول، اعتبار یا تحویل باشد باید در کد قطعی (Deterministic) نوشته شود. بخش «عاملانه» سیستم باید لایه ارکستراسیون باشد، در حالی که LLM به عنوان یک ابزار بدون وضعیت (Stateless) برای تولید محتوا باقی بماند.
اگر در حال ساخت ابزارهای AI برای مشتریان هستید، با خاموش کردن خودمختاری شروع کنید. تیم فروش در این مطالعه، تأیید خودکار را برای هر کمپین غیرفعال نگه داشت تا زمانی که تشخیص پاسخها خودش را ثابت کند. هر یک از ۶۷۸ پیام توسط یک انسان تأیید شد، و این تنها راه اطمینان از این است که یک سیستم تولیدی، راه خود را از طریق توهم به سمت یک بحران روابط عمومی (PR Crisis) پیدا نکند.
منتظر ظهور چارچوبهای «نرده حفاظی قطعی» (Deterministic Guardrail) باشید که جداسازی متن و سیاست را رسمی میکنند، زیرا این احتمالاً به استاندارد استقرار AI در سازمانها تبدیل خواهد شد.



گفتگو