تصور کنید یک عامل هوش مصنوعی پیش از آنکه شما متوجه هشدار امنیتی شوید، کل پایگاهداده تولیدی شرکت را پاک کند. برای جلوگیری از این کابوس، Conduct AI در ۲۸ اوت ۲۰۲۶ چارچوبی را منتشر کرد که اجازه نمیدهد هیچ دستوری بدون تأیید پیشین اجرا شود. هدف این سیستم تغییر تمرکز از «مشاهده آنچه عامل انجام داده است» به «کنترل آنچه عامل اجازه انجامش را دارد» است. این چارچوب حاکمیتی تضمین میکند که یک سیاست امضا شده واحد بتواند هر اقدامی را پیش از رسیدن به سرور، مسدود، هشدار یا ممیزی کند.
بسیاری از تیمهای فنی اکنون به فایروالهای زمان اجرا (Runtime Firewalls) تکیه میکنند که صرفاً نقش ضبطکننده دارند و پس از وقوع رخنه امنیتی، کاربر را باخبر میکنند. این رویکرد یک شکاف خطرناک ایجاد میکند؛ چرا که یک عامل خودمختار میتواند پیش از آنکه انسانی هشدار را ببیند، تغییرات جبرانناپذیری ایجاد کند. این چالشها دقیقاً همان دلیلی است که باعث شده شکاف میان تست و تضمین به یکی از موانع اصلی مقیاسپذیری عاملها در سازمانها تبدیل شود. همانطور که در تحلیل قبلی ما دربارهی نحوه بهینهسازی هزینههای مدلهای زبانی توسط گرههای مه (Fog Nodes) اشاره کردیم، صنعت اکنون از مرحلهی «بهرهوری» به مرحلهی «لایه کنترل» (Control Plane) وارد شده است؛ جایی که کارایی باید با مرزهای سختگیرانه ایمنی متوازن شود.
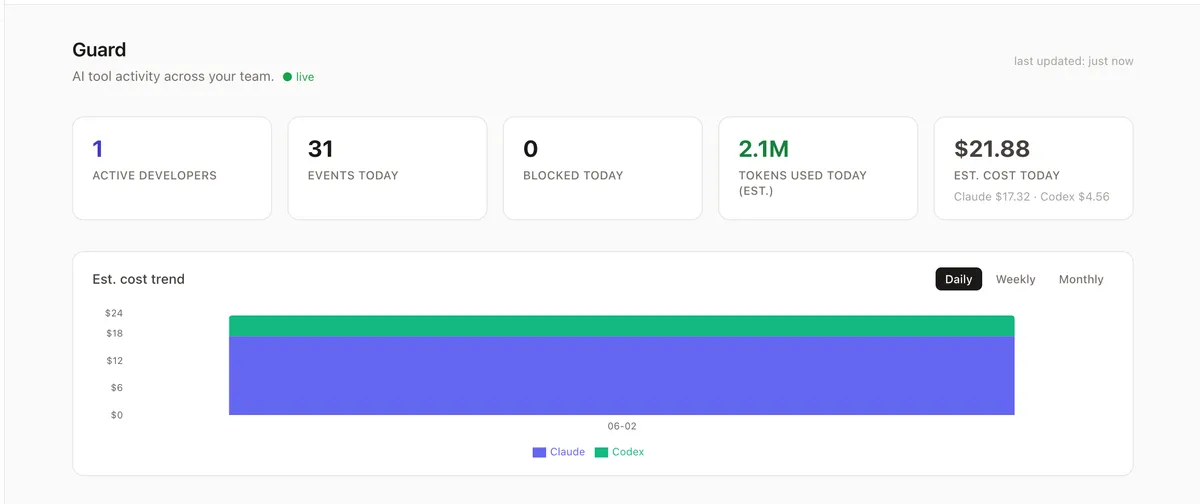
این سامانه از دو بخش اصلی تشکیل شده است: Conduct Guard که موتور سیاستگذاری و تصمیمگیرنده است و Conduct Router که به عنوان یک پروکسی برای مدل زبانی بزرگ (LLM) عمل میکند. طبق اعلام این شرکت، با متصل کردن SDKهای هر ارائهدهندهای — از جمله Anthropic، OpenAI یا Perplexity — به این روتر، تمام درخواستها پیش از پردازش توسط موتور Guard فیلتر میشوند.
معماری حاکمیتی
بر اساس مستندات منتشر شده، تفاوت اصلی Conduct AI با ابزارهای سنتی مانند Straiker و Lakera در نوع نگاه آنهاست. در حالی که ابزارهای مذکور بر «مشاهدهپذیری» (Observability) تمرکز دارند تا به شما بگویند چه اتفاقی افتاده است، Guard بر «حاکمیت» (Governance) متمرکز است تا تعیین کند چه اتفاقی «میتواند» بیفتد.
این هدف از طریق یک مخزن واحد و مجموعهای از سیاستها محقق میشود که قوانین را برای هر فراخوانی مدل، هر ابزار خط فرمان (Shell) و هر نشست کاربری تیمی اعمال میکند. سیستم پیش از اجرای هر اکشن، تصمیم میگیرد که آن را مسدود کند، هشدار دهد، ثبت نماید یا محتوای آن را تزریق (Inject) و تغییر دهد.
ستونهای اجرایی فنی
برای تضمین امنیت و جلوگیری از دور زدن قوانین، این سیستم بر سه مکانیزم فنی متکی است:
- پیکربندی امضا شده (Signed Configuration): هر فضای کاری، مجموعهی سیاستهای فعال خود را امضا میکند. هر بررسی در Guard پیش از اجرا، ابتدا امضا را تأیید میکند. اگر یک بسته پیکربندی در هر لایهای دستکاری شود، سیستم فوراً آن را رد میکند.
- لاگهای بازرسی زنجیرهای (Hash-Chained Audit Logs): هر تصمیم اتخاذ شده به یک زنجیره SHA-256 متصل میشود که ریشه آن در نقطه آغازین (Genesis) فضای کاری است. هرگونه حذف یا تغییر در ورودیها، زنجیره را میشکند و از طریق یک کلیک شناسایی میشود تا شواهد لازم برای ممیزان فراهم گردد.
- پیشفرضِ بستهشدن (Fail-Closed Default): برخلاف فایروالهای «نرم» که در صورت بروز خطا در سیستم بررسی، اجازه عبور میدهند (Fail-Open)، Conduct AI در صورت شکست در بررسیهای حاکمیتی، تمام اقدامات را بهصورت پیشفرض مسدود میکند.
انطباق و یکپارچهسازی
به گزارش Conduct AI، این چارچوب با بیش از ۲۰ بسته انطباق عرضه شده است که استانداردهای سختگیرانهای نظیر SOC 2 CC7.3، HIPAA §164.312، PCI DSS 4.0، مواد ۱۵ و ۱۶ قانون هوش مصنوعی اتحادیه اروپا (EU AI Act)، NIST AI RMF و ISO 42001 را پوشش میدهد. همچنین بستههای اختصاصی برای محیطهای توسعه پایتون، نود (Node) و Terraform در دسترس است.
علاوه بر این، ۲۲ دستورالعمل (Playbook) پیشساخته برای گردشکارهای رایج ارائه شده است که هر کدام یک فایل YAML ساده هستند و میتوانند فوراً ویرایش و اجرا شوند؛ از جمله:
- تبدیل Issue به PR و بررسی کد (Code Review)
- پاسخ به حوادث و گیتهای استقرار در محیط تولید (Prod Deploy Gates)
- تریاژ اسکنرهای امنیتی در CI/CD
- خلاصهسازی پیامهای Slack
نقاط استقرار و کنترل
توسعهدهندگان میتوانند این پشته را با Docker Compose مستقر کنند که شامل یک بکاند FastAPI، پایگاهداده Postgres برای مدیریت وضعیت و ممیزی، و Redis برای مدیریت ورکرها و صفها است. سیستم در سه نقطه استراتژیک (Chokepoints) درخواستها را رهگیری میکند:
۱. قلاب CLI: کنترل تمام فراخوانیهای ابزار از سوی Claude Code، Cursor، Copilot یا Codex. در این راستا، ابزارهایی مانند اسکنر Ship Safe برای شناسایی حفرههای امنیتی در سطح CLI و پروتکل MCP مکمل این لایهی کنترلی هستند.
۲. لایه MCP: مدیریت تمام فراخوانیهای ابزار در پروتکل زمینه مدل (Model Context Protocol).
۳. روتر: کنترل تمام فراخوانیهای SDK از طریق نقطه انتهایی /proxy/*.
این ساختار باعث میشود یک سیاست واحد در سه سطح مختلف اجرا شود. برای کسانی که راهکارهای ابری را ترجیح میدهند، لایه کنترل در conductai.ai رابط کاربری Canvas (ساخته شده با Next.js)، مدیریت دسترسیهای تیمی (RBAC) و یک مارکتپلیس مدیریتشده را فراهم کرده است.
این چرخش به سمت حاکمیت «سیاست-محور»، فرض بنیادی استقرار عاملها را تغییر میدهد. سازمانها دیگر امیدوار نیستند که یک عامل صرفاً از پرامپت سیستمی پیروی کند، بلکه محدودیتهای سخت و رمزنگاریشدهای را اعمال میکنند که عامل قادر به دور زدن آنها نیست، فارغ از اینکه توانایی استدلال مدل چقدر بالا باشد.
برای کاربر نهایی، این یعنی «جعبه سیاه» هوش مصنوعی عاملمحور به یک فرآیند شفاف و تحت نظارت تبدیل میشود. ریسک از ماهیت پیشبینیناپذیر مدل به یک دفترچه قوانین تعریفشده توسط انسان و تأییدشده به صورت رمزنگاری منتقل میشود.
تیمها میتوانند برای شروع از «حالت اکتشاف» (Discovery mode) به مدت ۱۴ روز استفاده کنند تا ابتدا دیدی خواندنی (Read-only) از اقدامات هوش مصنوعی داشته باشند و سپس این مشاهدات را به قوانین اجرایی تبدیل کنند. کل این مخزن تحت مجوز Apache 2.0 منتشر شده و برای مصارف تجاری و غیرتجاری رایگان است.
گام بعدی شما
- اگر از ابزارهای کدنویسی مثل Cursor یا Copilot در محیطهای حساس استفاده میکنید، لایه MCP این چارچوب را برای محدود کردن دسترسیهای فایل تست کنید.
- سیاستهای امنیتی خود را با بستههای انطباق SOC 2 یا HIPAA تطبیق دهید تا ریسکهای قانونی استقرار عاملها را کاهش دهید.
- از حالت Discovery برای شناسایی رفتارهای غیرمنتظره مدلهای خود پیش از اعمال محدودیتهای سخت استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو