
اگر تصور میکنید عاملهای هوش مصنوعی در یک اتاق مجازی با هم مشورت میکنند تا خطاهایشان را بگیرند، باید در این باور تجدیدنظر کنید. یک تست عملی در ۱۵ سپتامبر ۲۰۲۶ فاش کرد که آنچه در CrewAI شبیه به یک بحث تیمی است، در واقع تنها چسباندن خروجی یک مدل به پرامپت مدل دیگر است. در این سیستم، مدلها هرگز واقعاً با هم «صحبت» نمیکنند.
بسیاری از توسعهدهندگان با عامل (Agent) — شبیه به کارمندی که وظیفهٔ خاصی دارد و میتواند ابزارهای مختلف را به کار بگیرد — به عنوان موجوداتی خودمختار برخورد میکنند که در یک فضای مشترک همکاری میکنند. این رویکرد اغلب با دستهبندیهای مختلف عاملها و موازنه میان سطح خودمختاری و ریسکهای عملیاتی در تضاد است. اما در واقعیت، این سامانهها طبق یک سلسلهمراتب سختگیرانه عمل میکنند. در این ساختار، «همکاری» تنها یک ابزار است؛ یعنی تابعی به نام ask_question_to_coworker. این بدان معناست که کیفیت خروجی یک عامل، کاملاً به آرگومانهای ارسالی به این تابع بستگی دارد، نه به درکی مشترک از پروژه یا اهداف کلی آن.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر توهمات مدل بدون لایهی اعتبارسنجی خارجی خطرناک است. در این تست، برای بررسی مکانیزم CrewAI، یک تیم روی سرور شخصی با سختافزار ThinkCentre مستقر شد. این تیم از سه نقش مجزا تشکیل شده بود:
- تحلیلگر پژوهشی: جمعآوری حقایق و شناسایی ابهامات (با مدل Qwen 3 235B از طریق OpenRouter).
- نویسنده محتوا: تدوین پیشنویس ۳۰۰ کلمهای (با مدل Qwen 3 235B).
- ویراستار: تایید ادعاها و مدیریت بازبینیها (با مدل Claude Opus 4.8 از شرکت Anthropic).
این استراتژی بر پایهٔ «مدل ارزان برای حجم زیاد و مدل گران برای قضاوت» بنا شده بود. نصب این سیستم تنها با چهار دستور از ابزار uv و استفاده از فلگ مخفی CREWAI_DMN=true برای غیرفعال کردن پرامپتهای تعاملی در اجراهای اسکریپتی انجام شد.
در یک اجرای ۱۱۸ ثانیهای که ۱۸,۵۳۷ توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک که مدل تکهتکه میخورد — مصرف کرد، ویراستار متوجه خطایی در قیمت سرورهای AI شد. پیشنویس ادعا کرده بود که یک سرور ۱,۶۰۰ دلار هزینه دارد، اما ویراستار از ابزار ask_question_to_coworker برای تایید این عدد از تحلیلگر استفاده کرد.
تحلیلگر عدد را اصلاح کرد و توضیح داد که ۱,۶۰۰ دلار فقط هزینه GPU است و کل سیستم بین ۲,۵۰۰ تا ۳,۵۰۰ دلار هزینه دارد. سپس ویراستار دستور اصلاح را به نویسنده داد. اگرچه گزارش نهایی شبیه به یک دیالوگ تیمی بود، اما لاگ فعالیتها نشان داد که تنها سه فراخوانی ابزار رخ داده است: دو پرسش و یک تفویض اختیار.
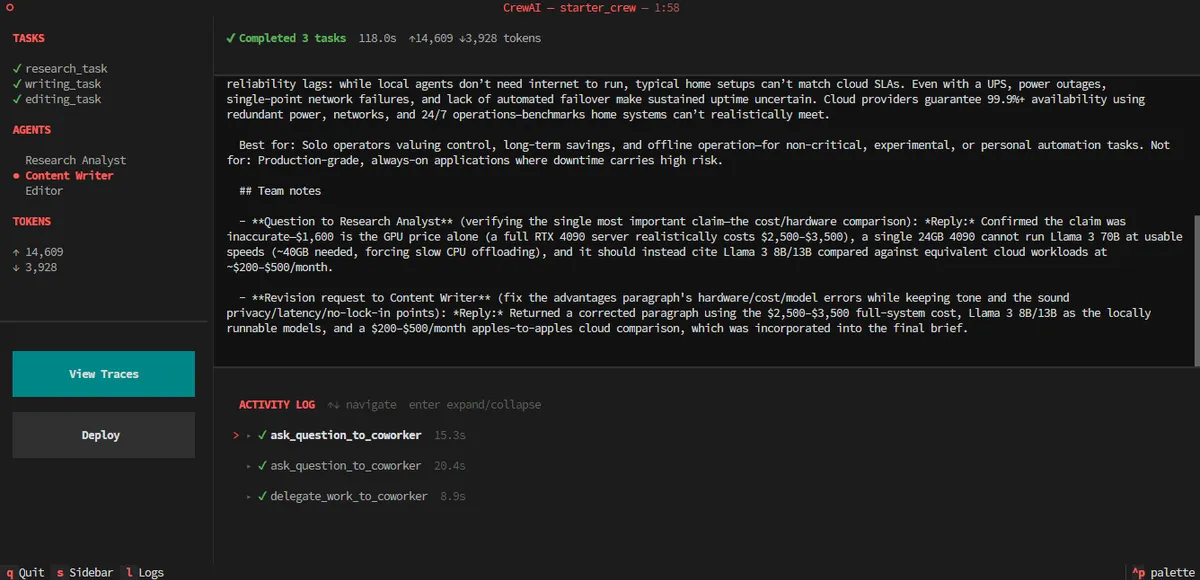
به نقل از مستندات فنی این تست، این مکانیزم یک نقطه کور خطرناک را آشکار میکند: موافقت مدل دوم با مدل اول، تنها یک «نظر دوم» است، نه یک «منبع دوم». در این آزمایش، عاملها به وب دسترسی نداشتند. تحلیلگر اصلاحیه را با استفاده از همان دادههای آموزشی تایید کرد که باعث ایجاد خطای اولیه شده بود.
از آنجا که عاملها راهی برای گفتن «نمیدانم» نداشتند، اعدادی باورپذیر اما تاییدنشده ارائه دادند. به گزارش تحلیلگران، اضافه کردن همکار برای عاملها مشکل توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — را حل نمیکند. تنها ابزارهای خارجی مثل جستوجوی وب میتوانند اعتبارسنجی واقعی ایجاد کنند. این موضوع تأیید میکند که طراحی سیستمی دقیق به جای تکیه صرف بر تعویض مدل، کلید موفقیت در مقیاس عملیاتی است.
راهاندازی این تیم پنج چالش فنی جدی را برملا کرد. اول اینکه ساختار به crewai[tools] وابسته است اما پشتیبانی از Anthropic نیاز به دستور اضافی uv add "crewai[anthropic]" دارد. دوم اینکه سیستم حافظه پیشفرض برای بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که همسایگی آن با کلمات دیگر را میگوید — به کلید OpenAI نیاز دارد و در غیر این صورت باعث کرش سیستم میشود. این چالشها در مدیریت وضعیت و حافظه، یادآور معماریهای لایهای برای کنترل دقیق حافظه در سیستمهای عاملمحور است.
سوم اینکه مدلهای جدید Claude (مثل Opus 5) هنوز با بلوکهای تفکر CrewAI سازگار نیستند، زیرا فریمورک این بلوکها را هنگام بازسازی فراخوانی ابزار حذف میکند. چهارم اینکه خطاهای API Key اغلب به دلیل وجود متنهای الگو در فایل .env به جای کلیدهای واقعی، به صورت خطای ۴۰۱ ظاهر میشوند.
بزرگترین شکست زمانی رخ داد که نویسنده در ۱۰ تلاش متوالی به دلیل خطای طول متن شکست خورد. میزبان مدل گزارشی از درخواست ۱۳۲,۰۸۶ توکن داد که از حد مجاز ۱۳۱,۰۷۲ توکن بیشتر بود. این اتفاق به این دلیل افتاد که CrewAI به طور پیشفرض حد max_tokens را ارسال نمیکند و برخی میزبانها تلاش میکنند کل پنجرهٔ زمینه (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جای چند ورق دارد — را پر کنند. افزودن مقدار مشخص (۴,۰۹۶ برای Qwen و ۱۶,۰۰۰ برای Claude) به پیکربندی مدل هر عامل، این مشکل را حل کرد.
از نظر هزینه، اجرای این تیم بسیار ارزان است. یک اجرای کامل با مدلهای Qwen کمتر از نیم سنت هزینه دارد. حتی با حضور Claude Opus 4.8 به عنوان ویراستار، هزینه کل برای ۱۸,۵۳۷ توکن بر اساس قیمتهای لیست (۵ دلار برای هر میلیون توکن ورودی و ۲۵ دلار برای هر میلیون توکن خروجی)، حدود ۱۷ سنت است.
این نسبت هزینه به ارزش، اعتبارسنجی چندعاملی را برای محتوای حجیم توجیه میکند، به شرطی که توسعهدهنده محدودیت توکنها و منابع اعتبارسنجی را دستی مدیریت کند.
برای کسانی که با CrewAI میسازند، درس اصلی این است: خواندن گزارش نهایی را متوقف کنید و لاگ فعالیتها را بخوانید. لاگ تنها جایی است که واقعیت مکانیکی سیستم و فراخوانیهای تابع در آن قابل مشاهده است.
گام بعدی شما
- برای جلوگیری از کرش در محیط عملیاتی، بلافاصله برای هر عامل مقدار
max_tokensصریح تعریف کنید. - تا زمانی که یک Embedder غیر از OpenAI پیکربندی نکردهاید، سیستم حافظه را غیرفعال کنید.
- برای اعتبارسنجی واقعی، به جای تکیه بر عاملهای دیگر، ابزارهای جستوجوی وب (Web Search) را به عامل تحلیلگر اضافه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو