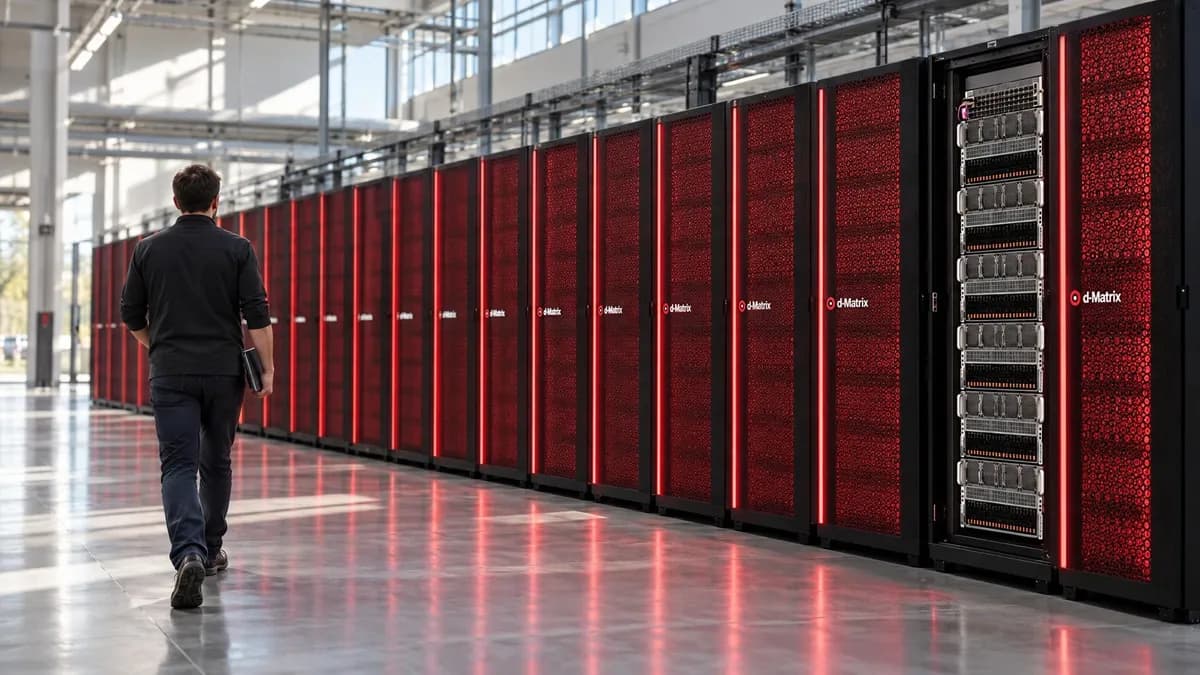
۱.۲۸ میلیثانیه؛ این است سرعت جدید یک گام استنتاج برای مدلی با ۲۰ میلیارد پارامتر که پیشتر ۲.۵۹ میلیثانیه بود. طبق گزارش فنی منتشرشده در ۱۲ اکتبر ۲۰۲۶، شرکت d-Matrix توانست با انتقال سنگینترین بخشهای محاسباتی مدل به خوشههای استنتاج Squadron، تأخیر (Latency) را ۵۰٪ کاهش دهد.
بسیاری از سازمانها در حال حاضر به خوشههای عظیم GPU (واحد پردازش گرافیکی) متکی هستند که با گلوگاه حافظه در مدلهای زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — دستوپنجه نرم میکنند. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی سختافزارهای هوش مصنوعی اشاره کردیم، صنعت اکنون از خرید تکتک تراشهها به سمت استقرار کل زیرساختهای محاسباتی مراکز داده حرکت میکند. این رویکرد با تلاشهای اخیر برای کاهش زمان استقرار مراکز داده AI از طریق ماژولهای پیشساخته همسو است تا سرعت عملیاتی سازمانها افزایش یابد. این دقیقاً همان شکافی است که d-Matrix با تبدیل شدن از یک طراح تراشه به ارائهدهنده زیرساخت کامل (Full-stack)، هدف قرار داده است.
زمینه و تکامل
سید شث، بنیانگذار و مدیرعامل این شرکت، در جریان سخنرانی افتتاحیه اجلاس OCP Global Summit در سن خوزه، این خوشهها را معرفی کرد. او این اقدام را یک تکامل راهبردی برای شرکت دانست. شث تصریح کرد که مشتریان اکنون به کارآمدترین زیرساخت استنتاج در مقیاس مرکز داده در جهان دسترسی دارند تا بتوانند برنامههای هوش مصنوعی با تأخیر بسیار پایین را ساخته و به سرعت گسترش دهند.
این محصول در واقع توسعهای از خط تولید SquadRack است که نخستین بار در ۱۴ اکتبر ۲۰۲۵ معرفی شد. در آن زمان، d-Matrix ادعا کرده بود که این راهکار تا سه برابر هزینه-عملکرد بهتر و سه برابر بهرهوری انرژی بیشتری نسبت به شتابدهندههای سنتی دارد و توکنها را تا ۱۰ برابر سریعتر تولید میکند.
چارلز لیانگ، رئیس و مدیرعامل Supermicro، خاطرنشان کرد که این همکاری از برنامه «راهکارهای بلوکی مرکز داده» (Data Center Building Block Solutions) شرکت Supermicro بهره میبرد. هدف از این رویکرد، تسریع «زمان آنلاین شدن» (Time-to-online) برای بارهای کاری پیشرفته هوش مصنوعی و محیطهای محاسباتی ناهمگن است. این استراتژی مشابه مدلهای ماژولار Corenix است که با هدف تسریع ظرفیتهای محاسباتی در مراکز دادههای مدرن طراحی شدهاند.
معماری Squadron
سامانه Squadron که در جریان اجلاس OCP Global Summit در سن خوزه رونمایی شد، مجموعهای از سیستمهای چند-رکی (Multi-rack) است که با همکاری شرکتهای Arista، Broadcom و Supermicro توسعه یافته است. این سیستم برای مقیاسهای عظیم طراحی شده و به سازمانها اجازه میدهد تا ۱۶ واحد SquadRack را در قالب یک خوشه یکپارچه ترکیب کنند.
این پیکربندی میتواند تا ۱۰۲۴ عدد Corsair XPU را در خود جای دهد. برخلاف بسیاری از سیستمهای سطح بالای هوش مصنوعی که به زیرساختهای پیچیده نیاز دارند، Squadron با هوا خنک میشود و بر اساس استانداردهای صنعتی ساخته شده است؛ به این معنا که مشتریان میتوانند سختافزار را بدون سرمایهگذاری در سیستمهای گرانقیمت خنککننده مایع، در مراکز داده فعلی خود نصب کنند.
جزئیات سختافزاری
شرکت d-Matrix چهار پیکربندی مرجع اصلی را برای تطبیق با نیازهای مختلف سازمانی ارائه میدهد:
- رک استارتر تک-سرور (Single-Server Starter Rack): شامل ۸ کارت، ۱۶ گیگابایت حافظه عملکرد با سرعت ۱۲۰۰ ترابایت بر ثانیه، تا ۲ ترابایت حافظه ظرفیتی و مصرف برق زیر ۱۰ کیلووات.
- رک استارتر دو-سرور (Dual-Server Starter Rack): شامل ۱۶ کارت، ۳۲ گیگابایت حافظه عملکرد، با توان مصرفی ۱۰ تا ۳۰ کیلووات که از مقیاسپذیری مبتنی بر اترنت از طریق JetStream استفاده میکند.
- نیم-رک چند-سرور (Multi-Server Half-Rack): شامل ۳۲ کارت، ۶۴ گیگابایت حافظه عملکرد، با توان مصرفی ۳۰ تا ۱۰۰ کیلووات.
- رک کامل سازمانی (Enterprise-Ready Full Rack): شامل ۶۴ کارت، ۱۲۸ گیگابایت حافظه عملکرد، با قابلیت اجرای مدلهایی تا ۱۰۰ میلیارد پارامتر در حالت عملکردی (Performance Mode).
پلتفرم Corsair
قلب این سیستم پلتفرم Corsair است که از طراحی مبتنی بر چیپلت (Chiplet) برای گسترش SRAM فراتر از محدودیتهای سنتی استفاده میکند. یک نوآوری کلیدی در اینجا طراحی 3DIMC است که DRAM را مستقیماً روی لایه منطقی (Logic Die) قرار میدهد. این ساختار اجازه میدهد پلتفرم از مدلهایی تا ۱۰۰ میلیارد پارامتر پشتیبانی کند و در عین حال بهطور کامل با زیرساختهای موجود مبتنی بر PCIe سازگار باشد.
مکانیسم: جداسازی توجه-FFN (AFD)
بزرگترین پیشرفت فنی در این سامانه، پیادهسازی «جداسازی توجه-FFN» (Attention-FFN Disaggregation یا AFD) است. در این ساختار، یک GPU Nvidia H100 وظیفه مدیریت توجه (Attention) — شبیه به تمرکز انسان روی کلمات کلیدی یک جمله برای فهم معنا — و همچنین بردارهای معنایی (Embeddings)، حافظه KV Cache و مسیریابی خبرهها (Expert Routing) را بر عهده دارد. در مقابل، رکهای Corsair محاسبات مربوط به «خبرهها» و شبکه پیشخور (FFN) را انجام میدهند.
این رویکرد ناهمگن، مشکل بحرانی پهنای باند را حل میکند. حافظه SRAM در Corsair پهنای باند ۱۵۰ ترابایت بر ثانیه را فراهم میکند که طبق اعلام d-Matrix، ۴۵ برابر بیشتر از پهنای باند HBM3 در H100 و ۹ برابر بیشتر از ۱۸ ترابایت بر ثانیه در HBM4 است. برای بهینهسازی این حجم از تبادل داده، استفاده از سختافزارهای شبکه بهینه ضروری است؛ برای مثال، سوییچهای جدید سلستیکا توانستهاند مصرف برق اتصالات AI را تا ۷۰٪ کاهش دهند تا بهرهوری کلی سیستم افزایش یابد.
با استفاده از کارتهای شبکه JetStream، سیستم به GPU اجازه میدهد بدون درگیر کردن CPU میزبان، مستقیماً در حافظه Corsair بنویسد. در آزمونی با مدل GPT-OSS-20B — یک مدل ترکیب خبرهها (Mixture of Experts) که در آن خبرهها ۱۹.۱۲ میلیارد از مجموع ۲۰.۹ میلیارد پارامتر را تشکیل میدهند — این ساختار به توان عملیاتی (Throughput) ۲۰,۴۱۵ توکن در ثانیه برای ۶۴ کاربر همزمان رسید که به معنای ۸۴۵ توکن در ثانیه برای هر کاربر است.
پیادهسازی فنی
در جزئیات فنی این تست، دو GPU H100 از هشت شتابدهنده Corsair با اندازه دسته (Batch size) ۶۴ استفاده کردند. این فرآیند شامل ۲۴ رفتوبرگشت بین GPU و Corsair برای ۲۴ لایه مدل است، به علاوه یک رفتوبرگشت برای لایه LM head. در این مسیر، GPU یک بردار حالت پنهان (Hidden-state vector) با ابعاد ۲۸۸۰ و تخصیص خبرههای هدف را از طریق لینکهای JetStream با پهنای باند ۴۰۰ گیگابیت بر ثانیه ارسال میکند.
شرکت d-Matrix با توزیع (Sharding) لایه LM head روی هر کارت Corsair، زمان پردازش این لایه را ۱۰ برابر کاهش داد. در اندازه دسته ۶۴ و طول زمینه (Context length) ۱۲۹، سیستم یک گام رمزگشایی (Decoding) کامل برای ۶۴ کاربر را در ۲.۴۶ میلیثانیه به پایان میرساند.
نرمافزار و اتصالات
مدیریت سختافزاری بر عهده پشته نرمافزاری Aviator است که از سطح کامپایلر تا زمان اجرا (Runtime) با سختافزار همطراحی شده است. برای اتصال، سیستم از PCIe برای مقیاسپذیری درون گره (Node) و اترنت استاندارد برای مقیاسپذیری بین رکها استفاده میکند.
همچنین عضویت d-Matrix در کنسرسیومهای UALink و UEC تضمین میکند که زیرساخت آنها با استانداردهای نسل بعدی مقیاسپذیری (Scale-up و Scale-out) سازگار بماند.
تحلیل راهبردی
برای یک مدیر کسبوکار، این اتفاق به معنای تغییر در نحوه خرید توان محاسباتی هوش مصنوعی است. با جداسازی مدل، شرکتها دیگر مجبور نیستند برای هر بخش از فرآیند استنتاج، گرانترین GPUها را بخرند. آنها میتوانند از GPUها برای آنچه در آن بهترین هستند (توجه) و از شتابدهندههای تخصصی و بهینهتر برای حجم اصلی محاسبات ریاضی استفاده کنند.
این رویکرد بهطور مؤثری «هزینه هر توکن» را برای حوزههایی مثل معاملات فرکانس بالا (HFT)، امنیت سایبری و عاملهای شخصی کاهش میدهد. اگر d-Matrix بتواند این مقیاس را به مدلهایی با صدها میلیارد پارامتر — مانند GLM 5.x و Kimi K3 — گسترش دهد، میتواند انحصار فعلی GPUها در استنتاجهای سطح بالا را بشکند.
برای مشاهده عملکرد واقعی این سختافزار، دموهای زنده AFD در غرفه C82 اجلاس OCP در تاریخ ۱۴ اکتبر (ساعت ۱۱ صبح و ۲ بعدازظهر به وقت PT) و ۱۵ اکتبر (ساعت ۱۱ صبح به وقت PT) برگزار میشود که در آن شرکت، این سرعتها را روی سیلیکون واقعی به نمایش میگذارد.
گام بعدی شما
- اگر در حال طراحی زیرساخت استنتاج برای مدلهای MoE هستید، معماری AFD را برای کاهش وابستگی به HBM بررسی کنید.
- برای مشاهده عملکرد واقعی این سختافزار، دموهای زنده AFD در غرفه C82 اجلاس OCP را دنبال کنید.
- هزینههای عملیاتی مرکز داده خود را با جایگزینی بخشی از GPUها با شتابدهندههای خنکشونده با هوا مقایسه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و رقابت با معماریهای ناهمگن مراجعه کنید.



گفتگو