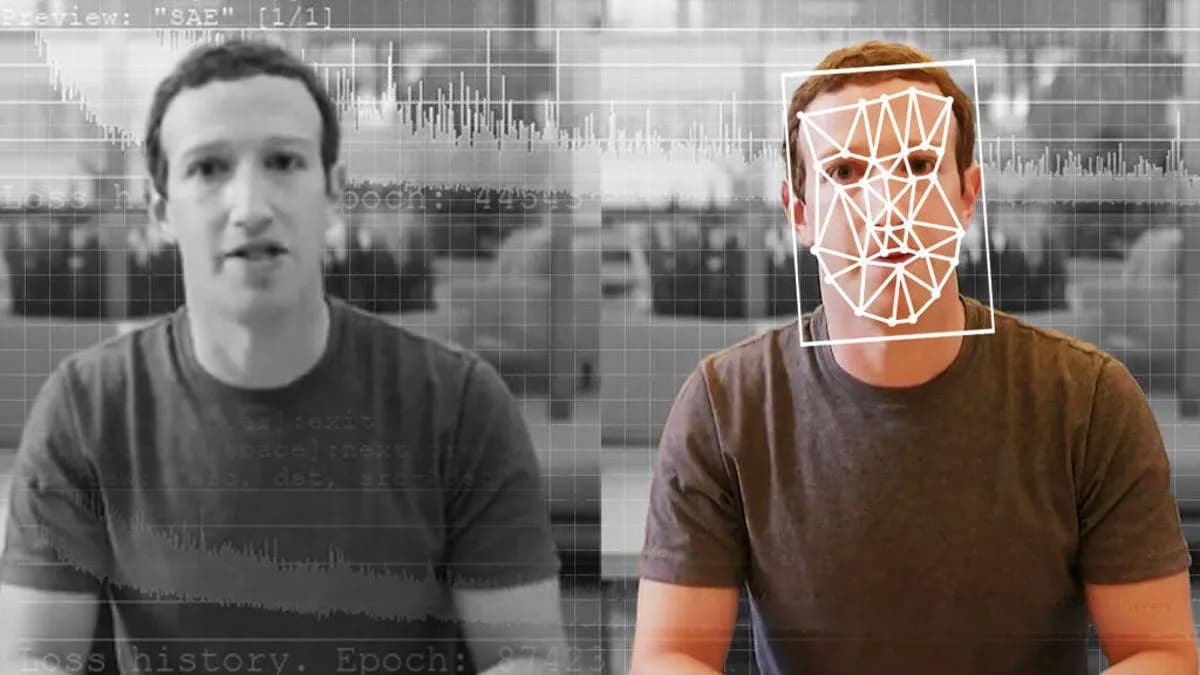
تصور کنید عکسی که به عنوان مدرک جنایی یا خبر فوری میبینید، تنها یک تخیل دیجیتال باشد که با دقت ریاضی ساخته شده است. اگر امروز به محتوای بصری اعتماد میکنید، باید بدانید که ابزارهای جعل چنان پیشرفت کردهاند که مرز میان واقعیت و ساختگی برای چشم انسان بهکل از بین رفته است.
طبق گزارش مرکز خدمات مالی دلویت (Deloitte)، پیشبینی میشود خسارات ناشی از کلاهبرداریهای مبتنی بر هوش مصنوعی زاینده (Generative AI) — که مثل جادوگری است که میتواند هر تصویر خیالی را به واقعیت تبدیل کند — تا سال ۲۰۲۷ در ایالات متحده به ۴۰ میلیارد دلار برسد. این رقم در مقایسه با ۱۲.۳ میلیارد دلار خسارت در سال ۲۰۲۳، جهشی سیستمیک را نشان میدهد؛ وضعیتی که در آن کاربران دیگر قادر نیستند عکسهای واقعی را از «آشغالهای دیجیتال» (Slop) تفکیک کنند. این روندی است که در آن اتوماسیون پیشرفته در مدیریت تقلبات میتواند هزینههای بررسی این حجم از خسارات را کاهش دهد.
این بحران تنها به کلاهبرداریهای ساده محدود نمیشود، بلکه اعتبار گزارشهای خبری، پستهای شبکههای اجتماعی و حتی شواهد عکاسی در صحنه جرم را هدف قرار داده است. برای مقابله با این وضعیت، نهادهای بینالمللی در کنفرانس «هوش مصنوعی برای خیر» (AI for Good) در ژنو و تحت نظارت سازمان ملل متحد، برای هماهنگسازی تلاشهای احراز هویت گرد هم آمدند.

زمینه بحران اعتبار
با سیل تصاویری که هر لحظه روی گوشیها و کامپیوترها سرازیر میشود، تشخیص اصالت محتوا تقریباً غیرممکن شده است. تورج ابراهیمی (Touradj Ebrahimi)، استاد مؤسسه فناوری فدرال سوئیس، تأکید میکند که اکنون هیچکس نمیداند چه چیزی واقعاً جعلی است یا خیر. او معتقد است که در این فضای جدید، کاربر دیگر نمیتواند تشخیص دهد که آیا چیزی واقعاً ساختگی است یا خیر.
تا به امروز، مبارزه با جعل عمیق (Deepfake) — که شبیه ساخت یک ماسک دیجیتالی بسیار دقیق برای تقلید از چهره دیگران است — پراکنده بوده است. شرکتها ابزارهای اختصاصی خود را در اکوسیستمهای بسته عرضه کردند و برخی دیگر سعی کردند استانداردهای غیررسمی ایجاد کنند. ابراهیمی اشاره میکند که یک پرسش اساسی همچنان باقی است: در نهایت کدام استاندارد به استاندارد غالب تبدیل خواهد شد؟ همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، نبود یک زبان مشترک باعث میشود این ابزارها در مقیاس واقعی شکست بخورند. در همین راستا، پژوهشگرانی مانند تیم MIT بر روی روشهای شناسایی مدلهای هوش مصنوعی خطرناک متمرکز شدهاند تا حتی بدون تولید تصویر، ماهیت مخرب مدلها را شناس کنند.
تلاشها برای مقابله با کلاهبرداریهای چندرسانهای در واقع از سال ۲۰۱۸ آغاز شد. در آن زمان، کمیته JPEG در سازمانهای IEC و ISO متوجه شکافی حیاتی شدند: فایلهای JPEG بهشدت برای انتشار تصاویر جعلی استفاده میشدند. اکنون با گسترش محتوای ساختهشده توسط مدلهای هوشمند، هدف این است که استانداردها به گونهای توسعه یابند که کاربران و شرکتها بتوانند اصالت تصاویر دریافتی را تأیید کنند.
استانداردسازی collaborative
تورج ابراهیمی اکنون رهبری تلاشی را بر عهده دارد تا استانداردهای مشترکی برای تفکیک محتواهای غلطِ تولیدشده توسط هوش مصنوعی از محتوای واقعی ایجاد کند. این ائتلاف شامل سه نهاد پیشرو است:
- کمیسیون بینالمللی الکتروتکنیک (IEC)
- سازمان بینالمللی استانداردسازی (ISO)
- اتحادیه بینالمللی ارتباطات (ITU)
ابراهیمی معتقد است کاربران باید به دادههای متادیتا (Metadata) — که شبیه شناسنامه یا برچسب پشت عکس است و جزئیات فنی را میگوید — دسترسی داشته باشند تا تصویر را در بستر درست تحلیل کنند. او تأکید میکند که این موضوع حیاتی است زیرا اعتماد بهشدت به بستر وابسته است؛ ممکن است یک کاربر بر اساس پروفایل یا محیط خاص خود به قطعهای از محتوا اعتماد کند، اما همان اعتماد زمانی که همان محتوا در محیطی دیگر ظاهر شود، تغییر کند.
چارچوب JPEG Trust
هسته اصلی این طرح، استاندارد JPEG Trust است. این استاندارد که سال گذشته به عنوان چارچوبی برای جاسازی نشانگرهای اعتماد مستقیماً در فایلهای JPEG از طریق متادیتای آنها معرفی شد، اکنون با دو افزودنی حیاتی در حال گسترش است:
- بخش دوم JPEG Trust: معرفی فهرستی از پروفایلهای اعتماد و قالبهای گزارشدهی. اینها میتوانند بهصورت آماده یا به عنوان نقاط شروع برای ایجاد پروفایلهای مربوط به گردشکارهای خاص و کاربردهای ویژه، مانند دوربینهای دیجیتال، پخش تلویزیونی و سرویسهای تولید محتوا با هوش مصنوعی استفاده شوند.
- بخش سوم JPEG Trust: تمرکز بر معرفی نشانگذاری (Watermarking) برای داراییهای رسانهای — که مثل مهر نامرئی روی کاغذ است تا اصالت اثر ثابت شود.
نکته کلیدی این است که JPEG Trust یک «فیلتر حقیقت» نیست تا در لحظه تولید، هر عکسی را برچسب بزند یا اعتبار آن را تأیید کند. ابراهیمی به صراحت میگوید: «کلاهبرداران هرگز محتوای خود را به عنوان محصول هوش مصنوعی برچسب نمیزنند». کسانی که حاضرند قانون را بشکنند، دستورالعملهای مربوط به برچسبگذاری را هم نادیده میگیرند.
بنابراین، او توضیح داد که JPEG Trust «استانداردی نیست که به شما بگوید به یک ویدئو یا تصویر اعتماد کنید یا نکنید»، بلکه ابزاری را فراهم میکند تا کاربران خودشان بر اساس محتوا و پروفایل شخصیشان تصمیم بگیرند.
ابتکارات گستردهتر احراز هویت
فراتر از فایلهای JPEG، سازمانهای IEC و ISO در حال توسعه ابزارهای سطح بالای دیگری در قالب ابتکار «اصالت و استانداردهای چندرسانهای» هستند:
- پروفایل منشأ (Originator Profile): چارچوبی برای مستندسازی منشأ محتوای دیجیتال. این شامل دستورالعملهایی برای حفظ پروفایلهایی است که اطلاعات دقیق درباره سازنده و فرآیند خلق اثر را ثبت میکنند تا یک سابقه قابل تأیید از منشأ اثر ایجاد شود.
- واژگان ترجیحات محتوایی برای هوش مصنوعی: یک زبان استاندارد و ماشینخوان برای اعلام «عدم پذیرش» (Opt-out) در مورد آموزش مدلهای هوش مصنوعی و استخراج متن یا داده. این مدل نسبت به مکانیسمهای خاص Opt-out بیتفاوت است و به طرفین اجازه میدهد مجوزهای داراییهای دیجیتال خود را به صورت تعاملی منتقل کنند.
- H.MMAUTH: راهکار فنی برای تأیید یکپارچگی محتوا از طریق امضای دیجیتال جریانهای داده. سازنده (رمزگذار) از یک کلید خصوصی برای امضای محتوا استفاده میکند. گیرنده (رمزگشا) از یک کلید عمومی متناظر برای تأیید اصالت استفاده میکند. این کلید عمومی از طریق یک روش مستقل و قابل اعتماد، مانند یک مرکز اعتماد شخص ثالث، به دست میآید و نه از خود جریان دادهها.
برای یک صاحب کسبوکار یا مصرفکننده عادی، این یعنی بار تأیید محتوا تغییر میکند. احتمالاً به زودی «نشانهای تأیید» یا بازرسان متادیتایی را در مرورگر یا نمایشگر عکس خود میبینید؛ دقیقاً شبیه به گواهینامههای SSL که به شما میگویند یک وبسایت امن است یا خیر.
این تغییر، پذیرش یک حقیقت تلخ است: جنگ علیه کلاهبرداریهای هوش مصنوعی را نمیتوان با مسدود کردن ابزارها برد، بلکه باید زنجیره تأمین و منشأ خروجیها را ایمن کرد. موفقیت این استانداردها کاملاً به این بستگی دارد که صنعت فناوری آنها را بهطور جهانی بپذیرد یا همچنان به دنبال راهکارهای تکهتکه و اختصاصی باشد.
همزمان با انتقال این پروتکلها از مرحله پیشنهاد به اجرا، مانع حیاتی بعدی، نرخ پذیرش آنها در میان سازندگان دوربین و پلتفرمهای رسانههای اجتماعی است. ادغام H.MMAUTH در ابزارهای حرفهای جمعآوری خبر، اولین نشانه از یک دفاع مقیاسپذیر خواهد بود.
گام بعدی شما
- هنگام بررسی عکسهای حساس در خبرها، از ابزارهای نمایش متادیتای آنلاین برای یافتن نشانههای JPEG Trust استفاده کنید.
- اگر تولیدکننده محتوا هستید، پروتکلهای اعلام عدم پذیرش (Opt-out) را در وبسایت خود برای مدلهای هوش مصنوعی فعال کنید.
- منتظر ادغام استاندارد H.MMAUTH در ابزارهای خبری حرفهای باشید تا اولین نشانه از دفاع مقیاسپذیر را شناسایی کنید.
اما نبرد سختافزاری برای شناسایی این جعلها حتی پیچیدهتر است — به تحلیل ما درباره تراشههای تشخیص الگو در لبه مراجعه کنید.



گفتگو