اگر امروز برای هر درخواست به APIهای ابری هزینه میپردازید، تصور کنید تمام این پردازشها بدون یک ریال هزینه و با سرعت لحظهای در جیب کاربرتان رخ دهد. این وعدهٔ مدلهای جدید Desert Ant Labs است که استنتاج را از مراکز داده به لبهٔ شبکه منتقل میکند. در حالی که فراخوانیهای API ابری مدتهاست که استاندارد پردازشهای سطح بالا بودهاند، Desert Ant Labs اکنون آنها را با مجموعهای از ۱۸ مدل تخصصی روی دستگاه (On-device) جایگزین میکند. یکی از این مدلها، یک مدل صوتی ۹ مگابایتی است که قادر است یک ضبط صوتی پنج دقیقهای را تنها در یک ثانیه به کیفیت استودیویی تبدیل کند.
بسیاری از توسعهدهندگان در حال حاضر با مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — صرفاً بهعنوان یک API برخورد میکنند. این رویکرد وابستگی شدیدی به ابر ایجاد میکند که نتیجهاش صورتحسابهای سنگین توکن و تأخیر در پاسخدهی است. این چالشها پیشتر در تحلیلهای مربوط به رایانش لبه مورد بررسی قرار گرفت که نشان داد چگونه حذف وابستگی به ابر میتواند تأخیر پردازش در موبایل را بهطور چشمگیری کاهش دهد. برای بسیاری از کارهای رایج، مثل پاکسازی یک فایل صوتی یا حذف نامها از متن، استفاده از یک «مغز» عظیم و عمومی، زیادهروی است. دنیایی را تصور کنید که در آن هزینه محاسبات پیشاپیش پرداخت شده است، زیرا این قدرت پردازشی در جیب کاربر زندگی میکند.
Desert Ant Labs برای حل این مشکل، مجموعهای از ۱۸ مدل تخصصی را معرفی کرده است که از طریق یک SDK برای زبانهای Swift، Kotlin و JavaScript قابل پیادهسازی هستند. طبق اعلام این آزمایشگاه، ۱۲ مدل این مجموعه در وضعیت پایدار و ۶ مدل در حالت بتا هستند و بهگونهای طراحی شدهاند که بر روی بهرهوری حداکثری تمرکز کنند. این مدلها آنقدر کوچک هستند که روی یک گوشی پنج سال پیش اجرا شوند و آنقدر سریعاند که بتوانند با هر فریم تصویر یا هر ضربه روی کیبورد فعال شوند.
بر اساس مستندات فنی این پروژه، برخی از برجستهترین مدلها عبارتاند از:
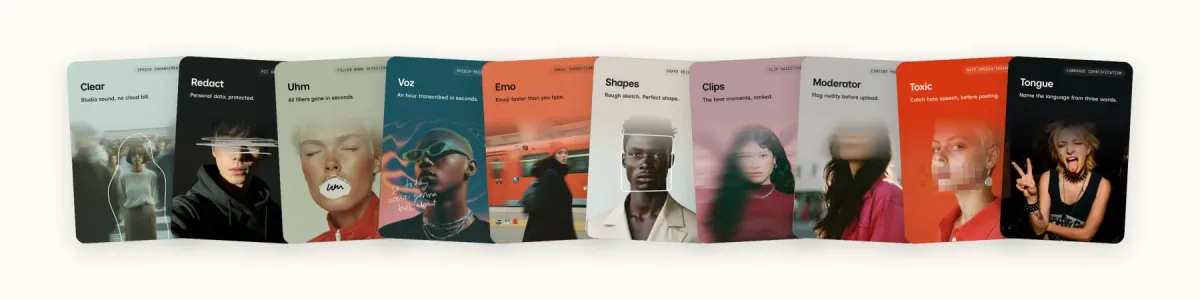
- Voz: این مدل ۱۰ دقیقه صوت را در ۲ ثانیه روی آیفون تبدیل به متن میکند. به نقل از وبسایت desertant.com، این مدل ۴.۷ برابر سریعتر از Whisper است و برای هر کلمه، زمان دقیق شروع و پایان را ثبت میکند. در مورد سختافزار، این مدل روی M3 Ultra به ضریب زمان واقعی ۳۱۹ برابر در ۳۰ دقیقه ضبط مداوم میرسد و روی آیفون ۱۷ پرو، این عدد ۲۹۸ برابر است.
- Clear: یک مدل ۹ مگابایتی برای ارتقای کیفیت صدا به سطح استودیویی است که کلیپها را روی دستگاه تقویت، مسترینگ و مجدداً کدگذاری میکند. این مدل روی آیفون ۱۶ پرو به سرعت ۳۰۲ برابر زمان واقعی (Real-time) و روی مکبوک پرو (M5) به سرعت ۳۴۵ برابر میرسد.
- Redact: مدلی ۱۲ مگابایتی که اطلاعات حساس (PII) شامل نامها، آدرسها و شماره کارتها را در ۲۷ زبان بهصورت لحظهای ماسک میکند. این مدل ۸۸.۸٪ از دادههای شخصی را شناسایی میکند که تقریباً با مدل ۲.۳ گیگابایتی GLiNER-PII (با دقت ۹۱.۱٪) برابری کرده و بهطور قابلتوجهی از فیلتر ۳ گیگابایتی OpenAI (با دقت ۶۰.۲٪) پیشی میگیرد.
- Tongue: مدلی ۲ مگابایتی که تنها با سه کلمه، ۸۴ زبان مختلف را شناسایی میکند. این مدل امتیاز دقت ۰.۹۳۳ را کسب کرده است که از یک شناسگر ۲۹۳ مگابایتی با امتیاز ۰.۸۸۷ برتر است.
این آزمایشگاه از دل توسعهی اپلیکیشن Detail شکل گرفت که یک برنامه ویرایش ویدیو است. تیم سازنده به مدت پنج سال روی رویکرد «اول دستگاه» (On-device first) کار کرد. با این حال، هنگام معرفی قابلیتهایی مانند ارتقای صدا برای پادکستها یا ویرایش خودکار (Auto Edit) برای کلیپهای کوتاه، آنها مجبور شدند به APIهای ابری بازگردند. با رشد محبوبیت Detail، صورتحسابهای زیرساختی آنها نیز بهطور متناسب افزایش یافت.
تیم سالها در Hugging Face به دنبال مدلهایی برای یافتن کلمات زائد (Filler words) یا پاکسازی ضبطها گشت، اما صنعت با سرعت کافی حرکت نمیکرد. در حالی که زیرساختها — یعنی تراشهها، Core ML و پژوهشها — وجود داشتند، اما شکاف بزرگی بین این بنیادها و پیادهسازی واقعی وجود داشت. در همین راستا، پلتفرم Pipette پیشتر با افشای شکاف عملکردی مدلهای محلی، به دشواری رسیدن به بهرهوری کامل در محیطهای On-device اشاره کرده بود. توسعهدهندگان به مدلی نیاز داشتند که بتوانند آن را دریافت کرده و تنها با چند خط کد، در محصول خود منتشر کنند.
برای پر کردن این شکاف، آنها مدلهای تخصصی ساختند که در کارهای خاص، از سرویسهای ابری سریعترند. برای مثال، آنها مدل Clear را جایگزین Dolby کردند تا ارتقای صدا سریعتر انجام شود. همچنین مدل Clips (با حجم ۲۸۴ مگابایت) را جایگزین Claude Sonnet کردند تا یک ویدیوی ۱۰ دقیقهای را در ۵ ثانیه به دهها کلیپ تبدیل کند. این فرآیند ۱۰ برابر سریعتر است و ۴۷۰ برابر انرژی کمتری نسبت به Sonnet مصرف میکند، در حالی که کیفیت یکسانی را حفظ میکند.
استراتژی Desert Ant بر پایه مفهومی به نام «مخچه» (Cerebellum) است. همانطور که مخچه در انسان کارهای همیشگی مثل تعادل و زمانبندی را بدون تفکر آگاهانه مدیریت میکند، این مدلهای کوچک وظایف تکراری و پرتکرار اپلیکیشن را بر عهده میگیرند.
معماری پیشنهادی آنها یک رویکرد لایهای به هوش مصنوعی را دنبال میکند:
۱. مخچه: یک مدل محلی کوچک که ابتدا پاسخ میدهد تا کارهای همیشگی و جاری را مدیریت کند.
۲. قشر مغز (Cortex): یک مدل محلی بزرگتر که اگر کار نیاز به عمق و تحلیل بیشتر داشت، وارد عمل میشود.
۳. ابر: تنها بهعنوان آخرین راهکار، زمانی که پردازش حتماً باید از دستگاه خارج شود، استفاده میشود.
این استراتژی توسط پژوهشهای NVIDIA پشتیبانی میشود؛ این شرکت تخمین زده است که ۴۰ تا ۷۰ درصد از فراخوانیهای سیستمهای عاملمحور (Agent systems) بزرگ را میتوان بهجای ابر، توسط مدلهای کوچک و تخصصی پاسخ داد.
این چرخش، اقتصاد توسعهی ویژگیها را تغییر میدهد. وقتی استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی و نه دورهی آموزش آشپز — رایگان باشد، توسعهدهنده میتواند قابلیت را روی هر کلید یا پیام اجرا کند، نه اینکه برای صرفهجویی در هزینه، فقط نمونههای محدودی را پردازش کند. این امر محدودیتهای مربوط به هزینه توکن و سرعت استنتاج را از بین میبرد.
از منظر حاکمیتی، این موضوع برای بازارهای اروپایی حیاتی است، جایی که «روی دستگاه» (On-device) پیشفرض حاکمیتی است. چون دادهها هرگز دست مشتری را ترک نمیکنند، ویژگیها هرگز به ابر شخص ثالث وابسته نیستند و دادههایی که هرگز آپلود نمیشوند، هرگز نمیتوانند توسط هیچ نهادی مصادره یا اجبار شوند.
این رویکرد، روند فعلی سرمایهگذاریهای ۴۵۰ میلیارد دلاری در مراکز داده را به چالش میکشد. Desert Ant استدلال میکند در حالی که میلیاردها گوشی، تبلت و لپتاپ با تراشههای توانمند عرضه میشوند، توان محاسباتی بیشتری در دست مردم است تا در تمام مراکز داده هوش مصنوعی روی زمین.
در حال حاضر، توسعهدهندگان میتوانند تا ۱۰۰ هزار دستگاه فعال ماهانه بهصورت رایگان از این مدلها استفاده کنند، بدون اینکه نیازی به ورود (Login) یا توکن باشد. SDK این پروژه در گیتهاب برای Swift، Kotlin و JavaScript در دسترس است. کاربران همچنین میتوانند مدلها را از طریق CLI در مک یا مستقیماً در مرورگر در Hugging Face تست کنند. این مدلها روی آیفون از Neural Engine و در مرورگرها، وزنهای مدل Clear از طریق WebAssembly اجرا میشوند تا بیشترین بازدهی را داشته باشند.
گام بعدی شما
- اگر توسعهدهنده موبایل هستید، SDK این پروژه را در گیتهاب بررسی کنید تا هزینههای API خود را کاهش دهید.
- مدلهای Voz و Clear را در Hugging Face تست کنید تا تفاوت سرعت استنتاج محلی را حس کنید.
- معماری سه لایه (مخچه-قشر-ابر) را در طراحی محصول خود برای کاهش تأخیر (Latency) پیاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و آینده رایانش لبه مراجعه کنید.



گفتگو