اگر امروز از عاملهای هوش مصنوعی برای تولید حجم زیادی از کد استفاده میکنید، احتمالاً با گلوگاه کندی تولید توکنها دستوپنجه نرم کردهاید. مدلهای زبانی بزرگ (LLM) استاندارد با محدودیت تولید توکنها به صورت تکبهتک (one token at a time) روبرو هستند. DFlash-2 این محدودیت سنتی را میشکند و بهجای تولید تکتک کلمات، بلوکهایی از توکنهای آینده را پیشبینی میکند.
این بهروزرسانی در حوزه رمزگشایی گمانهزنانه (Speculative Decoding) — که شبیه به نویسندهای است که ابتدا یک پیشنویس سریع میزند و سپس آن را بازبینی میکند تا سرعتش بالا برود — توسط Z-Lab معرفی شده است. این تکنیک در واقع تکامل یافتهی روشهایی است که بهینهسازی زمان پاسخدهی در حجمهای پردازشی پایین را بدون کاهش کیفیت ممکن میسازد. همانطور که در پوشش پیشین ما از نسخه اول DFlash دیدیم، مشکل اصلی مدلهای پیشنویس، تمایل توالیهای توکن پیشبینیشده به ناسازگاری داخلی بود؛ اما نسخه دوم با افزودن یک لایه بررسی سازگاری، این تئوری امیدوارکننده را به ابزاری کاربردی برای تولید انبوه توکن تبدیل کرده است.
برای درک بهتر، یک LLM سنتی را مانند نویسندهای تصور کنید که پیش از نوشتن هر کلمه، روی تکتک آنها فکر میکند. در مقابل, DFlash-2 مانند نویسندهای است که چند کلمه بعدی را در یک پیشنویس اولیه سریع ترسیم میکند و سپس بهسرعت بررسی میکند که آیا این طرح منطقی است یا خیر، و تنها پس از آن آن را روی صفحه مینویسد. این رویکرد بهویژه برای دادههای ساختاریافته مانند کد برنامهنویسی که الگوهای آن نسبت به گفتگوهای طبیعی پیشبینیپذیرتر هستند، بسیار مؤثر است.
مکانیسمهای DFlash-2
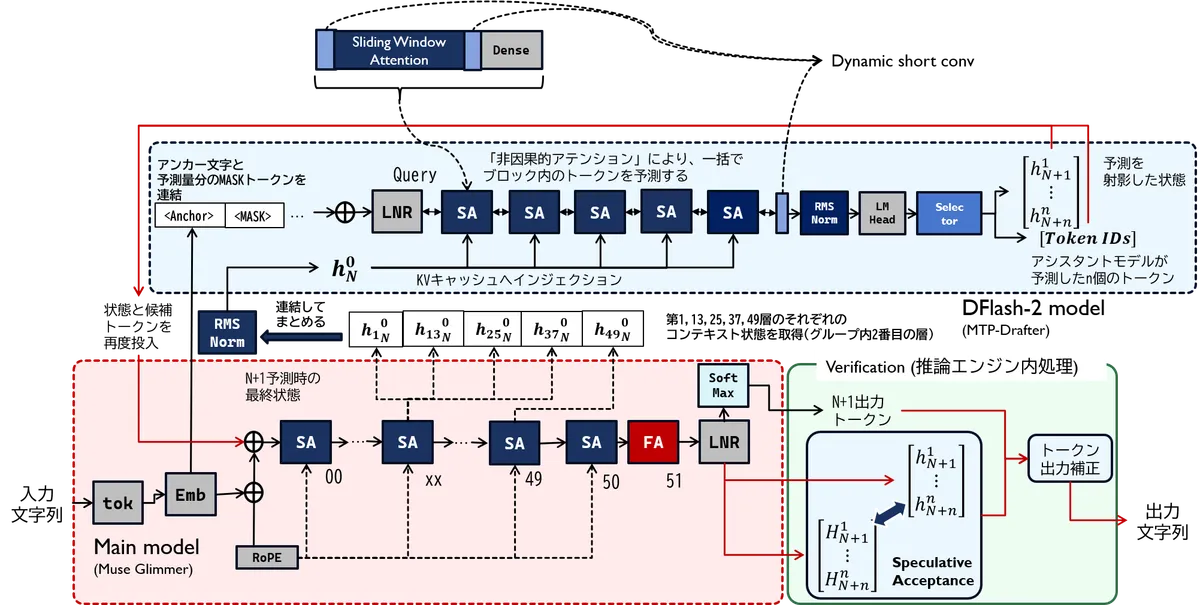
به نقل از گزارشی که در ۹ اوت ۲۰۲۶ توسط inco.ai (استارتاپی مرتبط با ژیجیان لیو، رئیس Z-Lab) منتشر شد، DFlash-2 دو ارتقای ساختاری کلیدی را نسبت به مکانیسم پیشنویس مبتنی بر انتشار (Diffusion) نسخه اول معرفی میکند. این رویکرد در واقع بر پایه مفاهیمی است که در آن مدلهای انتشار متن جایگزین پیشبینی توکنهای متوالی شدند تا تولید موازی توکنها میسر شود. DFlash سرعت تولید پیشنویس را با استفاده از یک مدل غیر-علی (non-causal) افزایش میدهد تا توان عملیاتی (throughput) بهتری نسبت به پیشنویسهای خودبازگشتی (autoregressive) متداول داشته باشد. با این حال، این امر منجر به ایجاد یک سبک-سنگین (tradeoff) در دقت میشد که inco.ai برای حل آن تلاش کرده است.
جزئیات ارتقای معماری
این بهبودهای ساختاری شامل دو بخش اصلی است:
- انتخابگر مسیر سبکوزن (Lightweight Path Selector): این مدل داخلی پس از لایه Target LM Head قرار میگیرد. وظیفه آن ارزیابی توالیهای توکن کاندید است تا اطمینان حاصل شود که آنها از طبیعیترین ترتیب پیروی میکنند. این لایه پیشبینیهای ناسازگاری را که پیشتر باعث میشد مدل اصلی کل پیشنویس را رد کند، فیلتر میکند. این راهکار مشکلی را حل میکند که در آن توکنها بهطور مستقل تولید میشدند و در نهایت دچار تناقض داخلی میشدند.
- کانولوشن محلی (Local Convolution): این لایه تبادل اطلاعات را به همسایگان نزدیک هر توکن محدود میکند. این لایه در چندین نقطه بین لایههای توجه (Attention) و MLP قرار گرفته است. هدف تخصصی این لایه مقابله با «زوال پسوند» (suffix decay) است؛ پدیدهای که در آن دقت توکنهای پیشبینیشده در انتهای هر بلوک بهشدت افت میکند.
زمینه و دسترسی به مدلها
در مجموع، DFlash-2 را میتوان بهعنوان نسخهای ارتقایافته از DFlash توصیف کرد که بهطور خاص دقت ترتیب توکنهای پیشنویس را بهبود میبخشد. تا اوت ۲۰۲۶، تنها تعداد محدودی از مدلها از این قابلیت پشتیبانی میکنند. در حال حاضر، دو مدل در دسترس هستند:
- Qwen3.8-27B-DFlash2
- Muse-Glimmer-30B-DFlash2
هر دو مدل در مخازن Z-Lab و inco.ai منتشر شدهاند و نسخههای GGUF آنها برای لاماسیپلاسپلاس (llama.cpp) موجود است. جالب است بدانید که پژوهشگران در ابتدا قصد داشتند تستها را روی مدل Gemma-4-12b-it-qat انجام دهند، اما بهدلیل ردپای استنتاج سبکتر و تبدیل شدن آن به مدل روزمره مورد علاقه خود، به Muse Glimmer 30B تغییر مسیر دادند و آن را جایگزین Gemma-4-12b-qat-Assistant کردند.
بنچمارک مدل Muse Glimmer 30B
برای سنجش این دستاوردها، تیم پژوهشی DFlash-2 را روی مدل Muse Glimmer 30B (محصول متا) آزمایش کرد.
محیط تست و سختافزار:
محیط آزمایش از یک پردازنده گرافیکی NVIDIA RTX A4000 روی سیستمعامل اوبونتو ۲۴.۰۴ استفاده میکرد. اتصال از طریق یک سرور دسترسی و تونل SSH به نمونه هدف برقرار شده بود و پورت سرویس llama.cpp بین localhost و نمونه راه دور از طریق پورت ۸۰۰۱ رله میشد. مشخصات کامل این نمونه (s16-1-a-standard-ubs24-v) عبارت بود از:
- GPU: NVIDIA RTX A4000
- حافظه GPU: ۱۶ گیگابایت GDDR6 با پهنای باند ۴۴۸.۰ گیگابایت بر ثانیه.
- قدرت پردازشی: ۱۹.۱۷ TFLOPS (FP32)، ۳۸.۳۴ TFLOPS (BF16)، ۱۵۳.۴ TOPS (INT8) و ۳۰۶.۷ TOPS (INT4).
- سیستم: ۱۱ هسته vCPU، ۵۰ گیگابایت حافظه سیستم، ۱۰۰ گیگابایت فضای ذخیرهسازی دائمی و نسخه CUDA 13.2 (درایور NVIDIA 580).
از آنجایی که وزنهای مدل حتی در حالت کوانتایز ۴-بیت نیز از ظرفیت GPU فراتر میرفت، پژوهشگران از یک بیلد کوانتایز ۲-بیت بهینه شده با Unsloth Dynamic 2.0 استفاده کردند. فایلهای مورد استفاده عبارت بودند از:
- مدل اصلی:
Muse-Glimmer-30B-UD-Q2_K_XL.gguf(۱۲.۴ گیگابایت). - پیشنویس DFlash:
dflash-kquant.gguf(۱.۶۳ گیگابایت). - پیشنویس DFlash-2:
Muse-Glimmer-30B-DFlash2-Q4_K_M.gguf(۱.۶۵ گیگابایت).
مقایسه مصرف حافظه
مصرف حافظه بین DFlash و DFlash-2 تا حد زیادی ثابت ماند. افزودن لایههای انتخابگر و کانولوشن، دادههای وزن مدل MTP را از ۱۵۴۳.۱۷ میبایت به ۱۵۵۶.۹۵ میبایت و بافر محاسباتی را از ۴۰۷.۶۲ میبایت به ۴۶۲.۶۷ میبایت افزایش داد.
تفکیک دقیق حافظه (CUDA):
- دادههای وزن (UD-Q2_K_XL): ۱۰,۸۰۳.۱۴ میبایت
- دادههای KV-cache (f16): ۱,۶۶۴.۰۰ میبایت
- KV cache پنجره لغزان: ۹۷.۵۰ میبایت
- بافر محاسباتی: ۲۷۳.۵۲ میبایت
- اندازه KV-cache مدل MTP (f16): ۵۰.۰۰ میبایت
مجموع حافظه مصرفی برای DFlash-2 برابر با ۱۴,۹۰۷.۷۸ میبایت بود، در حالی که برای DFlash اصلی ۱۴,۸۳۸.۹۵ میبایت بود. کل افزایش حافظه کمتر از ۱۰۰ میبایت بود.
نتایج عملکرد
سه پیکربندی با هم مقایسه شدند: مدل اصلی بهتنهایی، DFlash اصلی و DFlash-2. نتایج بسته به نوع حجم کاری بهشدت متفاوت بود:
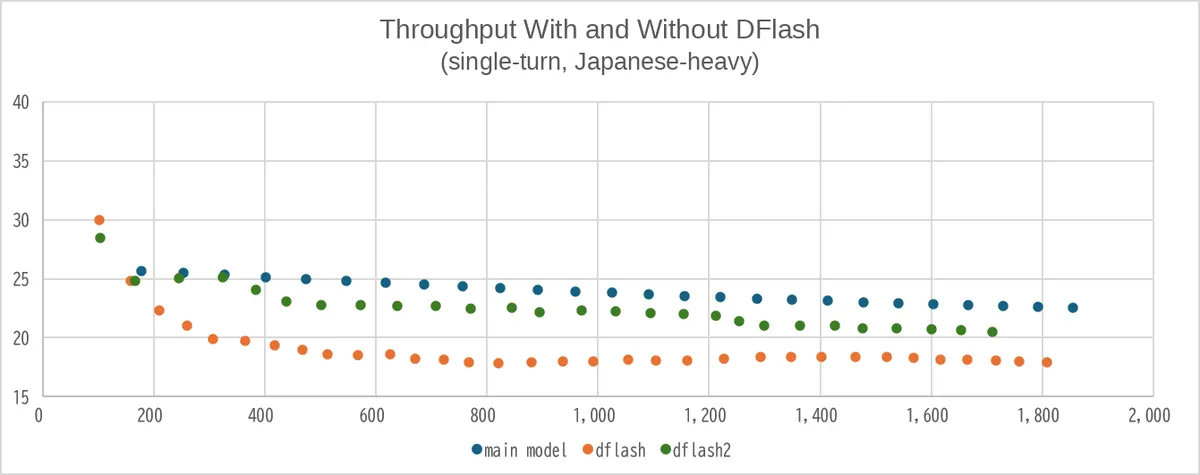
۱. کارهای تکمرحلهای و متنی (زبان ژاپنی):
در پرسوجوهای ساده درباره ویژگیهای زمینشناسی کیوشو، تأثیر DFlash-2 اندک بود. توان عملیاتی تولید برای DFlash-2 به ۲۰.۴۲ توکن در ثانیه (tps) رسید که کمی بیشتر از DFlash اصلی (۱۷.۸ tps) بود، در حالی که مدل اصلی بهتنهایی به ۲۲.۵۲ tps رسید. توان عملیاتی خواندن برای مدل اصلی ۲۵۹.۳۷ tps و برای DFlash-2 برابر با ۱۵۹.۳۳ tps بود. نرخ پذیرش پایین بود: DFlash-2 نرخ پذیرش ۳۱.۳۶٪ (میانگین طول ۲.۲۵) داشت، در حالی که DFlash به زیر ۲ افت کرد (نرخ پذیرش ۱۵.۷۳٪، میانگین طول ۱.۹۴).
۲. کارهای چندمرحلهای و کدنویسی:
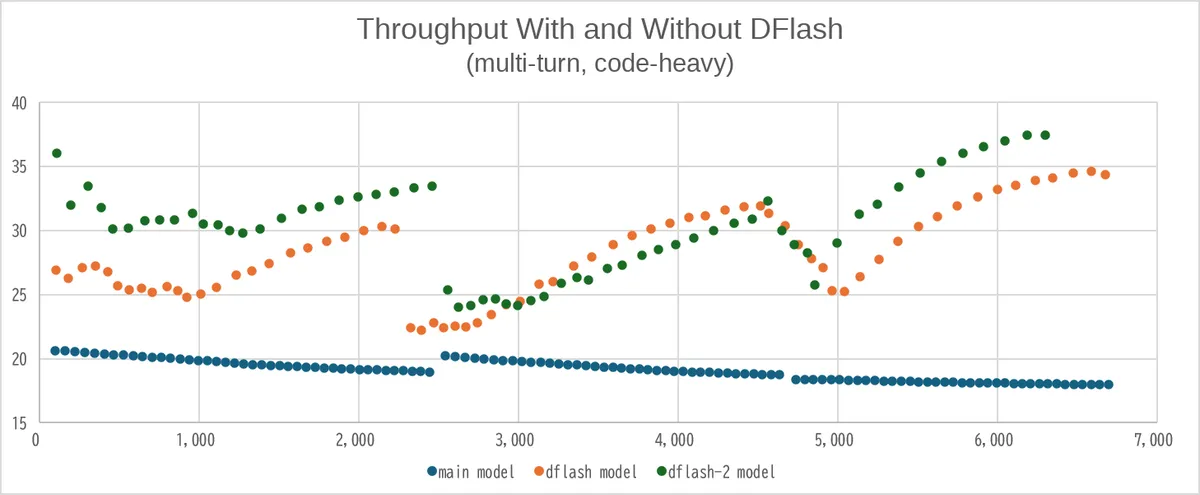
اینجا نقطه قوت DFlash-2 است. در سناریوی نوشتن و بهینهسازی کد جاوااسکریپت برای یک بازی Breakout (شامل HTML، بهبودهای بصری و بهینهسازی باگها)، افزایش توان عملیاتی قابل توجه بود.
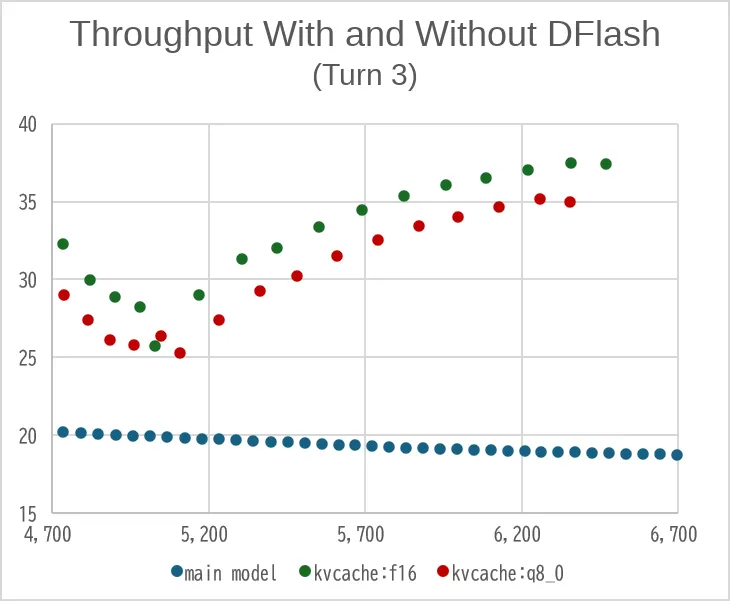
تا مرحله سوم گفتگو، DFlash-2 به میانگین طول پذیرش توکن ۴.۱۲ رسید که از حداکثر مقدار پیکربندی شده (۴) فراتر رفت. نرخ پذیرش آن تا مرحله سوم به ۷۸.۰۶٪ رسید، در حالی که برای DFlash اصلی ۶۸.۰۶٪ بود. توان عملیاتی تولید برای DFlash-2 در مرحله سوم به ۳۷.۰۷ tps رسید، در حالی که برای DFlash مقدار ۳۴.۱۱ tps و برای مدل اصلی ۱۷.۹۷ tps بود.
بهینهسازی برای حداکثر سرعت
پژوهشگران دریافتند که صرفاً افزایش طول پیشنویس همیشه منجر به عملکرد بهتر نمیشود. وقتی طول توکنهای پیشبینیشده را از ۴ به ۶ افزایش دادند، نرخ پذیرش در واقع کاهش یافت.
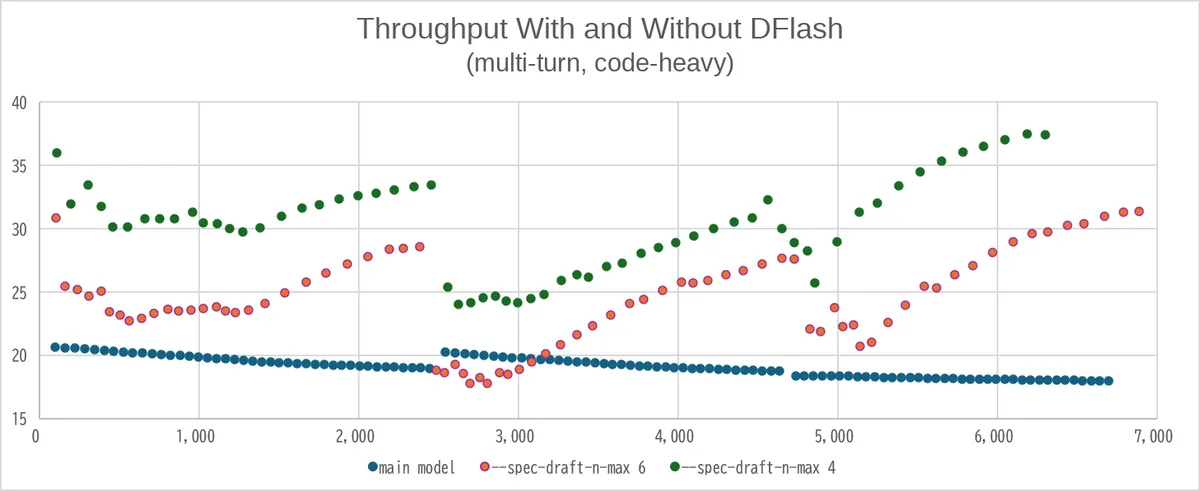
بهعنوان مثال، در مرحله سوم تست کدنویسی، نرخ پذیرش از ۷۸.۰۶٪ (در ۴ توکن) به ۵۸.۱۳٪ (در ۶ توکن) افت کرد. میانگین طول تنها اندکی افزایش یافت (از ۴.۱۲ به ۴.۴۹)، اما احتمال «نشستن» درست پیشنویس کاهش یافت. این نشان میدهد که پیشبینی فراتر از افق واقعبینانه مدل، باعث ایجاد «کار بیهوده» میشود که در نهایت کل سیستم را کند میکند.
استراتژی تنظیم (Tuning) برای DFlash
تیم پژوهشی رویکرد زیر را برای تنظیمات توصیه میکند:
۱. مدل DFlash را اعمال کرده و حجمهای کاری مختلف را با مقدار --spec-draft-n-max روی ۴ یا ۶ اجرا کنید.
۲. اگر میانگین طول (mean length) زیر ۲ بود، از DFlash برای آن مدل صرفنظر کنید.
۳. اگر میانگین طول بهطور مداوم ۱ یا بیشتر از مقدار فعلی --spec-draft-n-max بود، تنظیمات را به کوچکترین عدد صحیح بالای میانگین مشاهده شده افزایش دهید (مثلاً اگر میانگین ۷.۵ است، آن را به ۸ برسانید).
۴. در غیر این صورت، تنظیمات فعلی را حفظ کنید.
هزینه دقت (Precision)
یافته حیاتی دیگر مربوط به کوانتایز کردن KV-cache بود. در حالی که کوانتایز ۸-بیت اغلب بهعنوان یک حرکت امن برای صرفهجویی در حافظه دیده میشود، DFlash-2 هنگام کاهش دقت، افت عملکرد قابل اندازهگیری را نشان داد.
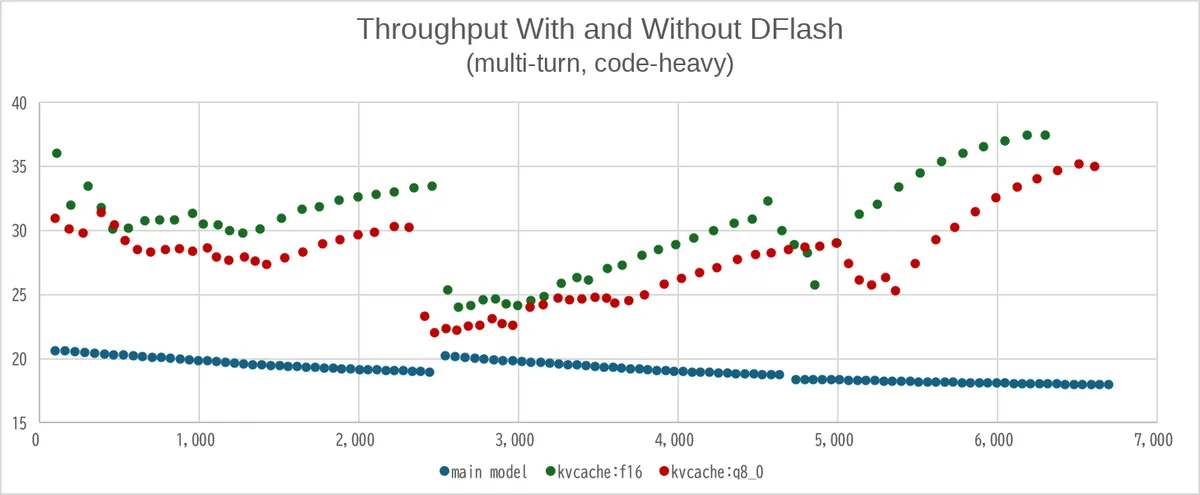
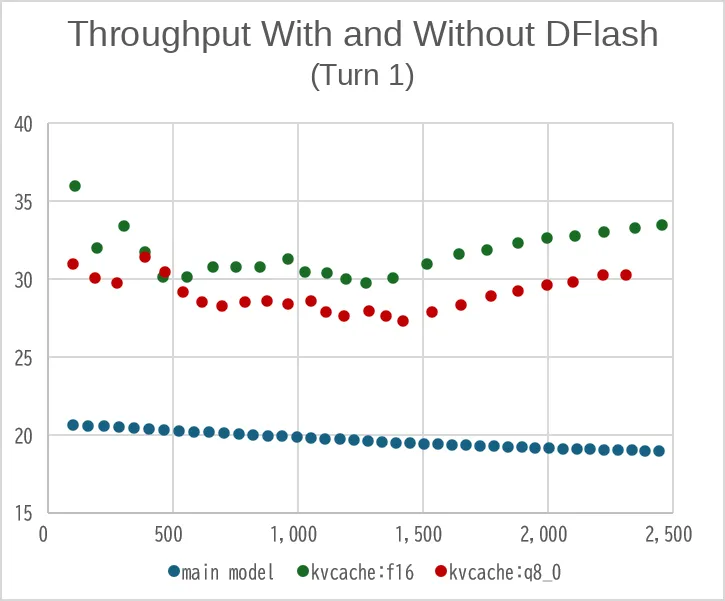
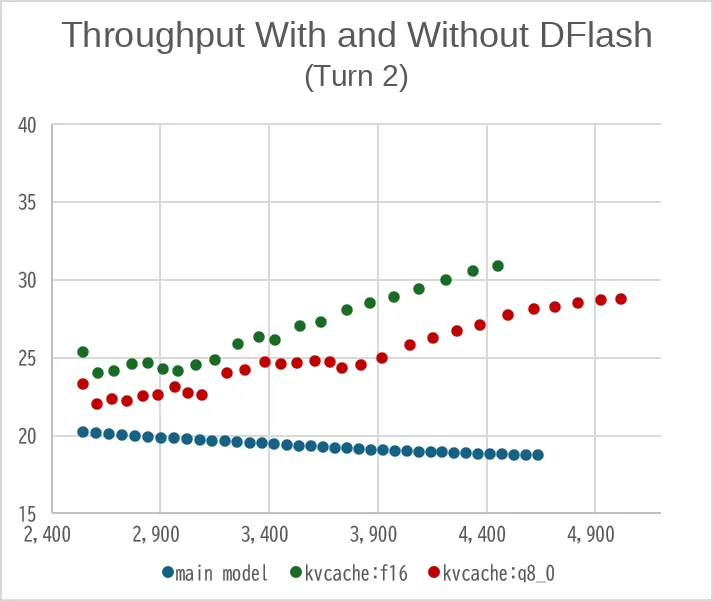
مقایسه دقت f16 (پیشفرض) با q8 (۸-بیت) در KV-cache، شکافی ۳ تا ۴ توکن در ثانیه را در تمام موارد نشان داد. در مرحله سوم، نرخ پذیرش از ۷۸.۰۶٪ (f16) به ۷۴.۸۸٪ (q8) و میانگین طول از ۴.۱۲ به ۴ افت کرد. این امر نشان میدهد که برای اثربخشی رمزگشایی گمانهزنانه، حفظ دقت بالا در حافظه کش حیاتی است.
پیامدهای عملی برای توسعهدهندگان
برای کاربر معمولی، DFlash-2 یک سود خالص و مداوم فراهم میکند. در یک روز استفاده به سبک «Deep-Research»، سرعت خروجی هرگز به زیر خط پایه ۱۲ tps مدل بدون MTP نرسید. این مورد در پرسوجوهای روزمره مختلف، از جمله تحقیق برای مقالات و سوالات عمومی زندگی تست شد. حتی با افزایش تعداد توکنها، سرعت بالاتر از خط پایه باقی ماند.
با این حال، برنده واقعی «عامل کدنویس» است. برای حجمهای کاری که مقدار عظیمی توکن تولید میکنند، DFlash-2 تجربه کاربری را از یک «چکه کند» به یک «جریان مداوم» تبدیل میکند. این تغییر نشان میدهد که ما به سمت عصر ترکیبی از استنتاج حرکت میکنیم. در حالی که مدلهای علی (causal) همچنان استاندارد طلایی برای انسجام هستند، پیشنویسهای انتشار غیر-علی مانند DFlash-2 میتوانند «کارهای سنگین» الگوهای پیشبینیپذیر را بر عهده بگیرند و مدل اصلی را به عنوان یک ویراستار سطحبالا باقی بگذارند.
اگر مدلهای محلی را از طریق llama.cpp اجرا میکنید، همین حالا به این قابلیت دسترسی دارید. اگرچه تا ۲۳ اوت ۲۰۲۶ در شاخه master نبود، اما Z-Lab یک Pull Request (شماره ۲۷۳۴۲) ارسال کرده بود که لایههای کانولوشن محلی و انتخابگر کاندید را فعال میکند. (توجه: پشتیبانی رسمی در ۲۸ اوت ۲۰۲۶ در نسخه 0.3.0-dev، بیلد ۱۰۶۵۸، کامیت b10f9ca به بعد اضافه شد).
برای پیادهسازی این مورد، از PR بیلد بگیرید و با آرگومانهای زیر اجرا کنید:
--model-draft: نام فایل GGUF مدل DFlash-2 را مشخص کنید.--spec-type draft-dflash: برای مدلهای DFlash-2 الزامی است.--spec-draft-n-max: بهعنوان نقطه شروع روی ۴ یا ۶ تنظیم کنید.
برای بهرهبرداری حداکثری، از کوانتایز کردن KV-cache خودداری کنید و مقدار --spec-draft-n-max را بر اساس میانگین طول حجم کاری خاص خود تنظیم کنید، نه اینکه صرفاً از یک عدد بالای کلی استفاده کنید.
گام بعدی شما
- اگر مدلهای محلی را اجرا میکنید، از آرگومان
--spec-type draft-dflashبرای فعالسازی این مکانیزم استفاده کنید. - مقدار
--spec-draft-n-maxرا ابتدا روی ۴ یا ۶ تنظیم کنید و بر اساس میانگین طول پذیرش توکنها در محیط خود، آن را بهینه کنید. - برای جلوگیری از افت سرعت، از کوانتیده کردن KV-cache در مدلهای DFlash-2 اجتناب کنید.
اما تأثیر این بهینهسازیها بر مصرف انرژی در مراکز داده، ابعاد دیگری دارد — به تحلیل ما درباره بهرهوری سختافزارهای استنتاج مراجعه کنید.



گفتگو