آموزش یک ترنسفورمر بدون نیاز به گذر پسرو (Backward Pass) دیگر یک محالِ تئوریک نیست. در ۵ اکتبر ۲۰۲۶، پژوهشگران qlabs.sh از Dust پردهبرداری کردند؛ نخستین روش بهینهسازی مرتبه-صفر (Zeroth-Order) که توانایی رقابت با پسانتشار در پیشآموزش (Pretraining) مدلهای زبانی را دارد.
برای چندین دهه، یادگیری عمیق با پسانتشار (Backpropagation) مترادف بود. این الگوریتم برای تخصیص اعتبار به وزنها (Weights) به قابلیت مشتقپذیری وابسته است؛ محدودیتی که تکامل معماریهای هوش مصنوعی و سختافزارها را دیکته کرده است. با این حال، «درس تلخ» تاریخ هوش مصنوعی نشان میدهد روشهای کلی که با افزایش محاسبات (Compute) مقیاسپذیر میشوند، در نهایت بر روشهایی که به سوگیریهای القایی طراحیشده توسط انسان متکی هستند، پیروز میشوند. این تلاش برای بهینهسازی مصرف منابع، یادآور دستوردههای پیشآموزش Magic است که پیشتر توانستند هزینه محاسباتی مدلهای باز را تا ۱۰ برابر کاهش دهند.
همانطور که در تحلیل قبلی ما دربارهی بهینهسازی اجرای ترنسفورمرها توسط Hugging Face اشاره کردیم، تمرکز صنعت تا کنون بر بهرهوری استنتاج بود. اما Dust این تمرکز را به فاز آموزش بازمیگرداند و یک جستوجوی نیرومند (Brute-force) روی فعالسازها پیشنهاد میدهد که نیاز به گرادیانهای تحلیلی را بهطور کامل حذف میکند.
سازوکار: جمعیتهای مجازی
استراتژیهای تکاملی (Evolution Strategies) سنتی، وزنها را تغییر میدهند که بهدلیل نیاز هر عضو جمعیت به یک گذر پیشرو (Forward Pass) مجزا، بسیار هزینهبر است. Dust این مشکل را با تغییر در فعالسازها — یعنی حالتهای پنهان — بهصورت مستقل در هر توکن (Token) حل میکند.
این رویکرد چیزی را ایجاد میکند که نویسندگان آن را «جمعیت مجازی» مینامند. از آنجا که یک توالی شامل هزاران توکن است، تنها یک گذر پیشرو میتواند هزاران عضو جمعیت را بهطور موازی ارزیابی کند. طبق مستندات qlabs.sh، این روش چندین مرتبه کارآمدتر از متدهای فضای وزن مانند EGGROLL است.
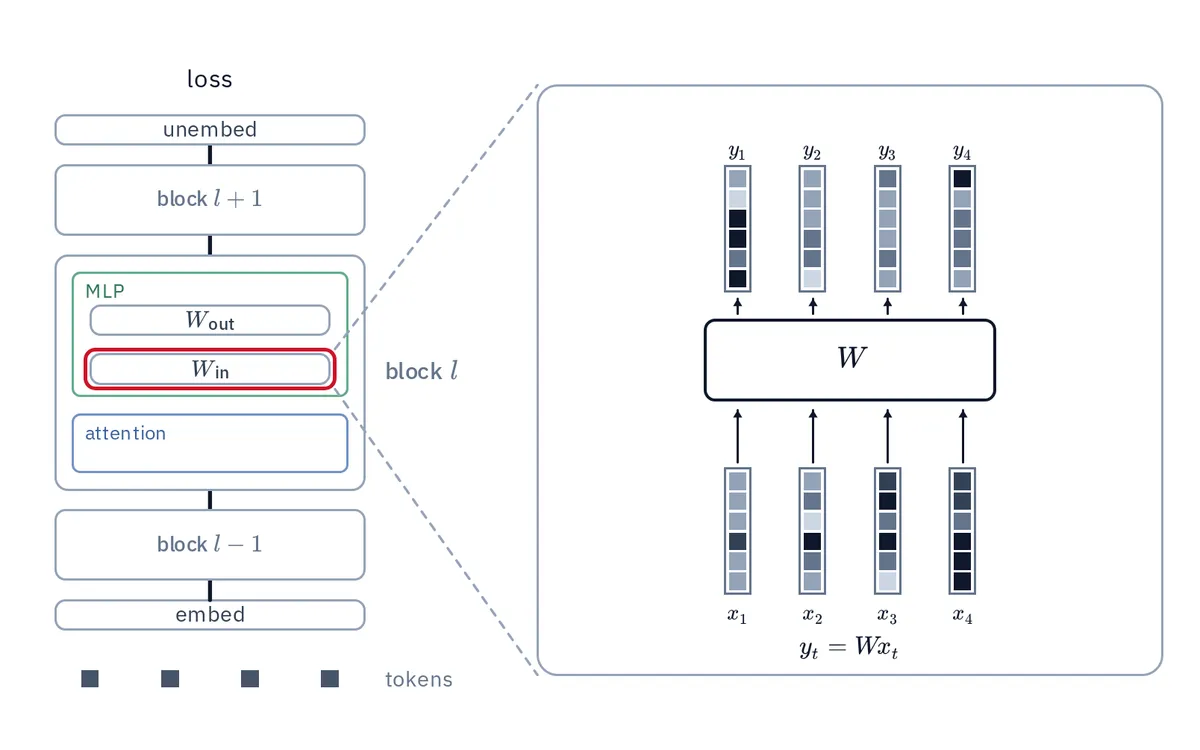
نحوه تخصیص اعتبار در Dust
الگوریتم Dust از طریق توالی مشخصی از تغییرات و پاداشها عمل میکند:
- نویز گاوسی: الگوریتم در هر توکن، نویزی را به خروجی هر لایه خطی اضافه میکند.
- کاهش زیان: میزان کاهش تابع زیان (Loss Function) در آن توکن خاص بر اثر هر تغییر اندازهگیری میشود.
- وزندهی پاداش: نویز بر اساس میزان کاهش زیان (پاداش) وزندهی شده و برای تخمین گرادیان، میانگین گرفته میشود.
- حاصلضرب خارجی: گرادیان نهایی وزنها از حاصلضرب خارجی خطای تخمینزدهشده و ورودی لایه تشکیل میشود.
برای مدیریت پیچیدگیهای ترنسفورمر، Dust از یک قانون تخصصی برای بخشهای داخلی توجه (Attention) استفاده میکند. از آنجا که زیان توکنها بلافاصله لرزشهای مکانیزم توجه را ثبت نمیکند، این موارد بر اساس تغییر در خروجی توجه در توکنهای فعلی و آتی پاداش میگیرند.
حل مسئله تداخل
یکی از موانع اصلی روشهای مرتبه-صفر، «تداخل» است؛ جایی که تغییرات متعدد در یک گذر، سیگنال پاداش را مختل میکند. Dust این مشکل را با سه استراتژی حل میکند:
۱. جداسازی لایهها: انواع مختلف لایهها در گذرهای پیشروی مجزا تغییر میکنند و برای صرفهجویی در محاسبات، از گذرهای پاکِ ذخیرهشده (Cached) استفاده میشود.
۲. ایزولاسیون توجه: بخشهای داخلی Query، Key، Value و Gate بهطور جداگانه تغییر مییابند.
۳. بهینهسازی سر (Head): لایه خروجی مدل زبانی مستقیماً روی لاجیتها (Logits) ذخیرهشده تغییر میکند که اجازه میدهد اندازه جمعیت با کمترین هزینه بهشدت افزایش یابد.
نتایج عملکرد و مقیاسپذیری
در آزمونهای رودررو روی مجموعه داده FineWeb، الگوریتم Dust تابآوری و ویژگیهای مقیاسپذیری شگفتانگیزی نشان داد. بر اساس گزارش qlabs.sh، این روش در ۱۰۰ هزار و ۱ میلیون توکن، با جمعیتهای نسبتاً کوچک، توانست با زیان آزمونِ پسانتشار برابری کند.
در ۲۰ میلیون توکن، شکاف بین Dust و پسانتشار با رشد جمعیت همچنان کمتر شد. برونیابیهای قانون توان (Power Law) نشان میدهد که در رژیمهای با محاسبات غنی، Dust پتانسیل عبور از عملکرد پسانتشار را دارد. این تحلیلها در راستای درک عمیقتر از اثرات غیرخطی وزندهی دادهها در مقیاسهای مختلف است که پیشتر توسط Jane Street بررسی شده بود.
در مقایسه با EGGROLL-Transformer، مشخص شد که Dust از ۱ میلیون توکن به بعد، بین ۱۰ تا ۱۰⁴ برابر کارآمدتر است. حتی با ۲۵۶ برابر جمعیت بیشتر، EGGROLL نتوانست به عملکرد Dust در کوچکترین اندازه جمعیت آن (۶۴ نمونه) برسد.
به چالش کشیدن افسانه مقیاسپذیری
باور رایج این است که روشهای مرتبه-صفر نمیتوانند مقیاسپذیر شوند زیرا واریانس (Variance) گرادیان با افزایش تعداد پارامترها رشد میکند. Dust این یافته را نقض میکند. پژوهشگران مدلهایی از ۲ میلیون تا ۲۴۳ میلیون پارامتر را آزمایش کردند و دریافتند مدلهای بزرگتر در واقع از نظر جمعیت کارآمدتر هستند.
بهطور مشخص، یک مدل ۲۴۳ میلیون پارامتری در اکثر اندازههای جمعیت، از مدلی ۱۲۰ برابر کوچکتر بهتر عمل کرد. این نشان میدهد که بیشپارامتریزه بودن (Overparameterization)، فضای جستوجوی بزرگتر با هندسه بهتر فراهم میکند و رویکرد جستوجومحور Dust را با رشد مدلها مؤثرتر میسازد.
همراستایی با پسانتشار
برای تأیید این متد، تیم پژوهشی شباهت کسینوسی (Cosine Similarity) بین گرادیانهای تخمینی Dust و گرادیانهای واقعی پسانتشار را اندازهگیری کرد. آنها دریافتند که با رشد جمعیت، تخمینهای Dust در انواع لایهها (MLP, Q, K, V) بهشدت با پسانتشار همراستا میشود.
این همراستایی در نقاط بازرسی (Checkpoints) از ۱۰ میلیون تا ۱ میلیارد توکن ثابت ماند. نکته کلیدی این است که Dust دقیقاً به پسانتشار همگرا نمیشود، بلکه مسیر بهینهسازی متفاوتی را طی میکند؛ نویسندگان معتقدند همین دلیل آن است که این روش گاهی میتواند نقاط مینیمم بهتری نسبت به گرادیانهای مرتبه-اول پیدا کند.
تحلیل: چرخش به سمت جستوجو
الگوریتم Dust نشاندهنده یک تغییر بنیادین در نگاه ما به تخصیص اعتبار است. با تبدیل آموزش به یک جستوجو روی استدلالهای نهان در فعالسازها بهجای یک مسئله حساب دیفرانسیل، نیاز به مشتقپذیری سرتاسری حذف میشود.
این موضوع در را برای معماریهایی باز میکند که پسانتشار در آموزش آنها مشکل دارد؛ مانند شبکههایی با برنامههای خارجی در حلقه یا ترنسفورمرهایی با حلقههای بازگشتی عمیق. اگرچه Dust هنوز برای جایگزینی روزمره پسانتشار بهاندازه کافی بهینه نیست، اما ثابت میکند که ساختار تحلیلی «قاعده زنجیرهای» یک سوگیری مفید است، نه یک الزام سخت برای دستیابی به هوش. این تحول در متدهای آموزشی، مکمل نقشه راه ۲۰۲۶ برای استقرار مدلهای زبانی در مقیاس صنعتی است که بر زیرساختهای بهینه تأکید دارد.
گام بعدی شما
- دنبال کردن نسخههای آتی Dust که با بهینهسازهای مدرنی مثل Adam ادغام میشوند.
- بررسی مقالات مربوط به بهینهسازهای تکاملیافته مخصوص جستوجوی مرتبه-صفر برای کاهش شکاف بهرهوری.
- آزمایش متدهای بدون گرادیان روی معماریهای غیرمشتقپذیر در پروژههای تحقیقاتی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو