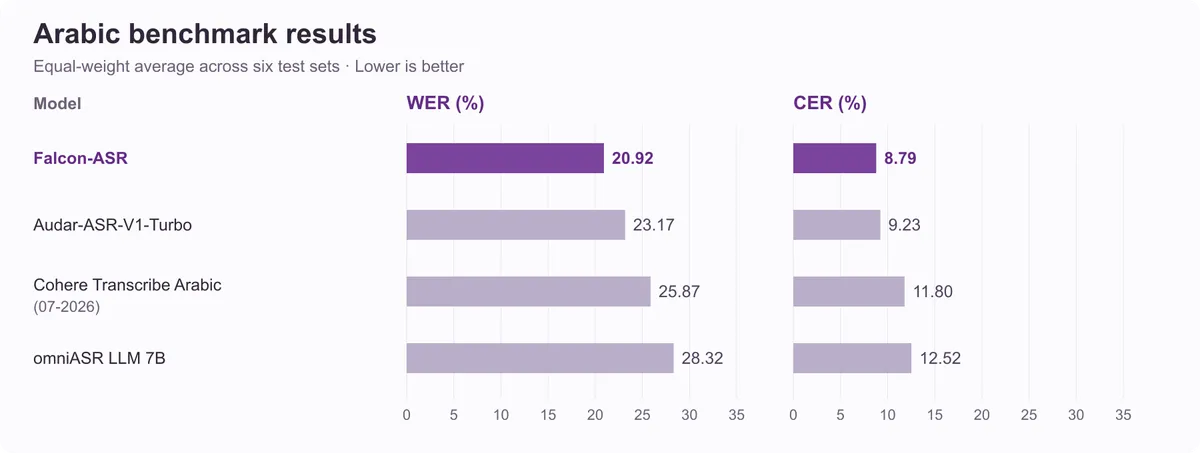
اگر در حال توسعه اپلیکیشنهای صوتی برای بازار خلیج فارس هستید، دیگر مجبور نیستید کاربران را به صحبت کردن به زبان رسمی و رباتگونه ترغیب کنید. مدل جدید Falcon-ASR با کاهش نرخ خطای کلمه به ۲۰.۹۲٪، مرزهای درک لهجههای محلی را جابهجا کرده است. این عدد، میانگین جدید نرخ خطای کلمه (WER) برای بازشناسی گفتار عربی است؛ یک معیار جهانی که توسط مدلی با ۱.۶ میلیارد پارامتر به نام Falcon-ASR بازتعریف شده است. طبق اعلام مؤسسه نوآوری فناوری (TII) در ۷ اکتبر ۲۰۲۶، این مدل توانسته است در ۶ مجموعه آزمون اصلی، رکورد قبلی یعنی ۲۳.۱۷٪ را با ۲.۲۵ درصد بهبود جدی بشکند.
بازشناسی گفتار (ASR) — شبیه به مترجمی است که باید نه تنها کلمات، بلکه لحن و تکیههای محلی هر منطقه را بفهمد — برای زبان عربی همواره به دلیل تفاوت شدید لهجهها یک چالش پراکنده بوده است. در حالی که عربی استاندارد مدرن (MSA) مستندات زیادی دارد، لهجههای منطقهای بهویژه در مکالمات روزمره، فاقد منابع متنی لازم برای آموزش هوش مصنوعی با دقت بالا هستند. به همین دلیل، اکثر مدلهایی که در پردازش پخشهای خبری رسمی موفق هستند، در مواجهه با یک تماس تلفنی با لهجه محلی شکست میخورند.
TII که در ابوظبی مستقر است، Falcon-ASR را بهطور ویژه برای پوشش شکاف موجود با تمرکز بر لهجه اماراتی و سایر گونههای خلیجی طراحی کرده است. هدف این مدل، ثبت دقیق نحوه صحبت واقعی مردم در زندگی روزمره، از جمله جابهجاییهای مکرر و سریع بین زبانها در حین گفتگو است.
زمینه: چالش لهجههای عربی
تفاوتهای گسترده در گویشهای عربی بسته به منطقه، گوینده و محیط گفتگو، یک مانع فنی بزرگ برای سیستمهای ASR ایجاد میکند. این تنوع باعث میشود مدلی که برای یک پخش خبری رسمی بهینه شده است، در درک یک گفتگوی دوستانه و غیررسمی در امارات یا صدای ضبطشده از طریق خط تلفن دچار مشکل شود.
علاوه بر این، عربی لهجهای (Dialectal Arabic) در مقایسه با عربی استاندارد مدرن (MSA)، منابع متنی و برچسبگذاریشده بسیار کمتری دارد. این کمبود منابع، هم فرآیند آموزش و هم ارزیابی این مدلها را بهطور قابلتوجهی سختتر از زبانهای استاندارد میکند.
برای حل این مشکل، TII مدل Falcon-ASR را روی مجموعهای متنوع از دادهها آموزش داد. این مجموعه شامل لهجه اماراتی، عربی استاندارد (MSA)، سایر لهجههای خلیجی و چندین گویش مختلف عربی در کنار زبان انگلیسی بود. هدف از این رویکرد، شکار تفاوتهای ظریف گفتار روزمره و انتقالهای سیال بین زبانهای مختلف است.
عملکرد عربی و معیارهای سنجش
ارزیابی این مدل بر اساس پروتکل Open Universal Arabic ASR Leaderboard انجام شد که توسط مرکز تحقیقات ELM مدیریت میشود. این پروتکل سیستمها را بر اساس میانگین نرخ خطای کلمه (WER) با وزن یکسان در ۶ مجموعه آزمون رتبهبندی میکند. همچنین، نرخ خطای نویسه (CER) نیز گزارش میشود. در هر دو معیار، مقادیر پایینتر نشاندهنده عملکرد بهتر و دقت بالاتر است.
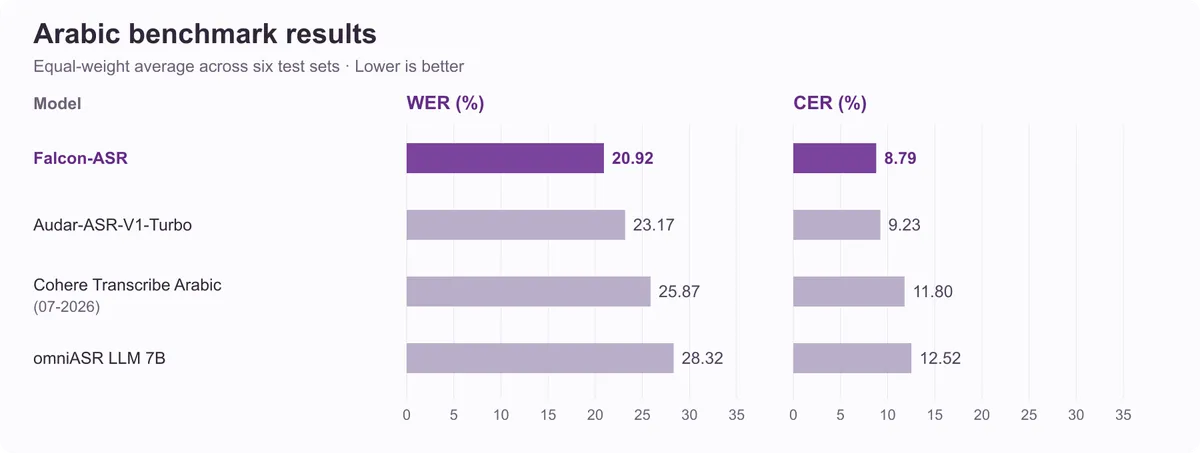
مدل Falcon-ASR روی همان ۶ محک با استفاده از مانیفستهای تثبیتشدهی لیدربورد ارزیابی شد. ارقام مربوط به رقبا بر اساس میانگینهای منتشرشده در لیدربورد بود که در تاریخ ۳۰ سپتامبر ۲۰۲۶ بررسی شده بود. میانگین WER مدل Falcon-ASR برابر با ۲۰.۹۲٪ است که ۲.۲۵ درصد بهتر از بهترین نتیجه منتشرشده در آن مقطع زمانی است.
جزئیات: ارزیابی گفتار اماراتی
دادههای ارزیابی عمومی برای امارات متحده عربی محدود است، هرچند مجموعه داده Casablanca شامل یک زیرمجموعه برای امارات است. TII برای ارزیابی دقت فراتر از این زیرمجموعه عمومی، دادههای مذکور را با یک ارزیابی داخلی سختگیرانه تکمیل کرد.
- متدولوژی داخلی: TII از ضبطهای جداشده (held-out) و نسخههای متنی تأییدشده توسط انسان استفاده کرد تا ارزیابی با وفاداری بالا از گفتار اماراتی و خلیجی تضمین شود.
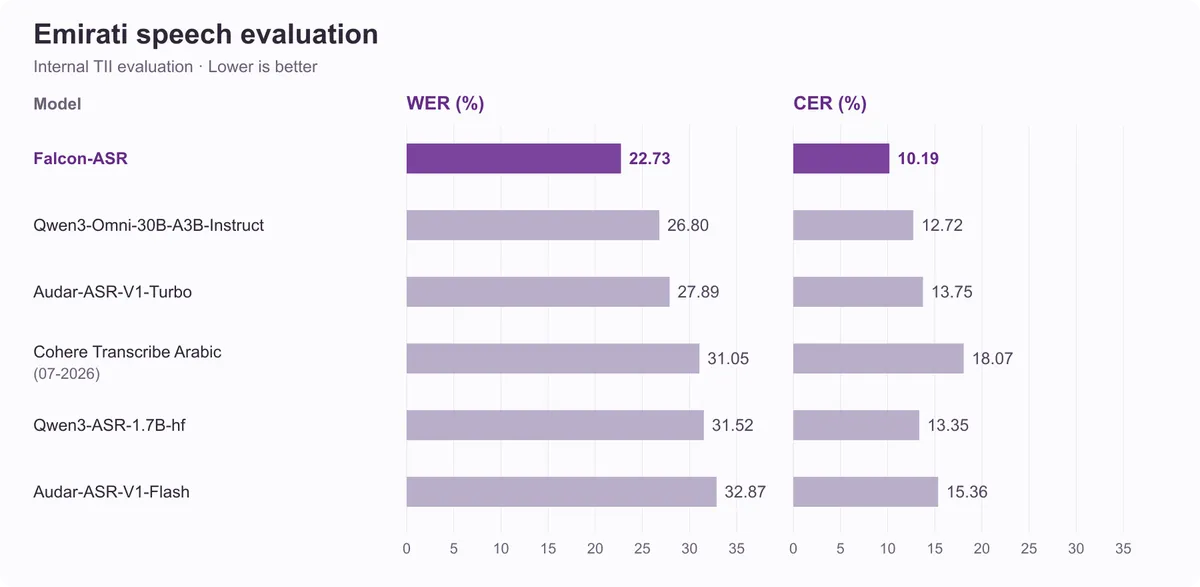
- نرخ خطای کلمه (WER): مدل Falcon-ASR به عدد ۲۲.۷۳٪ رسید.
- نرخ خطای نویسه (CER): مدل Falcon-ASR به عدد ۱۰.۱۹٪ دست یافت.
- شکاف رقابتی: این مدل کمترین WER و CER را در میان تمام سیستمهای مقایسهشده ثبت کرد. نرخ خطای کلمه آن ۴.۰۷ درصد پایینتر از Qwen3-Omni، یعنی دومین سیستم برتر، است.
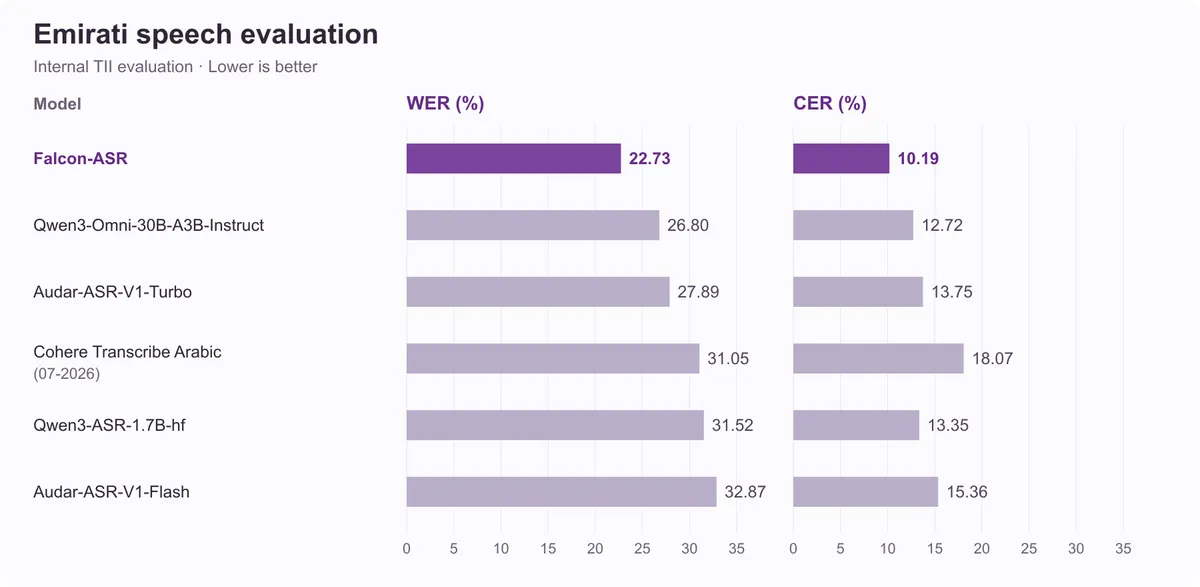
این نتایج نشان میدهد که دقت تبدیل گفتار به متن در هر دو سطح کلمه و نویسه برای لهجه اماراتی جهشی قابلتوجه داشته است.
استواری و قابلیتهای چندزبانه
برای اطمینان از کارکرد مدل در محیطهای واقعی، TII مدل Falcon-ASR را روی دادههایی آموزش داد که حاوی چالشهای صوتی متنوع بودند. این امر تضمین میکند که مدل برای شرایطی که در جلسات، تماسهای تلفنی و ضبطهای روزمره با آن مواجه میشود، آماده باشد.
مکانیزمهای آموزشی برای شرایط صوتی:
- نویز محیطی: گنجاندن نویز پسزمینه و بازگشت صدا (Reverberation) در اتاق.
- تداخل گفتاری: آموزش روی صداهای همپوشان و موسیقی.
- اثرات تلفنی: شبیهسازی تخصصی کیفیت صوتی خطوط تلفن.
- تغییرات صوتی: مواجهه با سرعتهای مختلف صحبت کردن و تغییرات در گام صدا (Pitch).
این پردازشها بهطور ویژه روی ضبطهای اماراتی اعمال شدند تا استواری منطقهای مدل تضمین شود.
فراتر از زبان عربی، این مدل بهطور ذاتی چندزبانه است. Falcon-ASR میتواند انگلیسی، فرانسوی، اسپانیایی و پرتغالی را با استفاده از همان وزنهای مدل بازشناسی کند. کاربران نیازی به ارائه پرچم زبان (Language Flag) ندارند؛ مدل بهطور خودکار زبان spoken را تشخیص داده و متن مربوطه را خروجی میدهد.
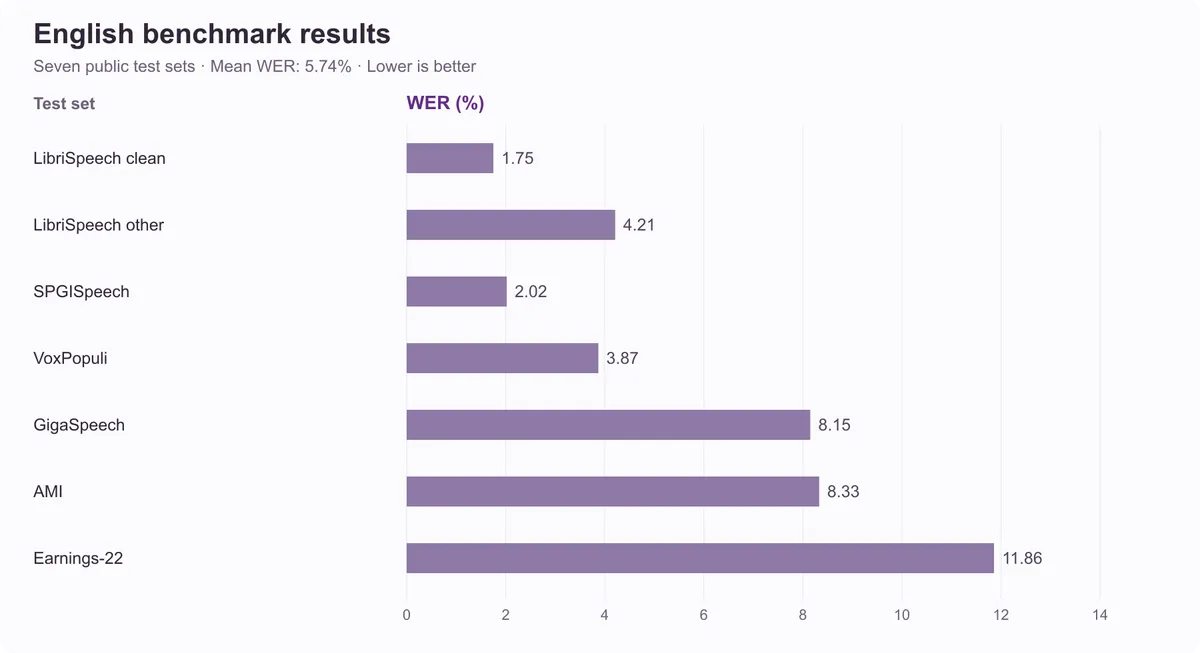
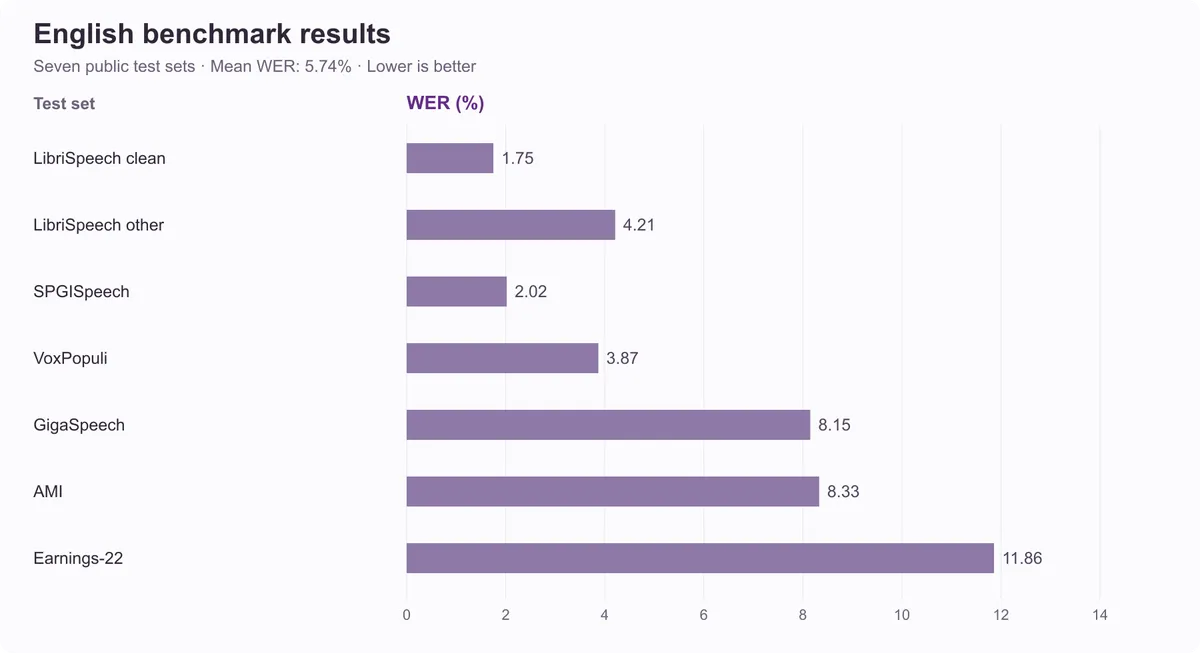
در ارزیابیهای انجام شده روی ۷ مجموعه آزمون عمومی انگلیسی از Hugging Face Open ASR Leaderboard، مدل Falcon-ASR به میانگین WER ۵.۷۴٪ رسید.
زیرساخت فنی
مدل Falcon-ASR بر پایه معماری Falcon3-Audio ساخته شده است. جزئیات مربوط به معماری خاص و رویکرد آموزشی در مقاله پژوهشی با عنوان "Competitive Audio-Language Models with Data-Efficient Single-Stage Training on Public Data" شرح داده شده است.
یک ویژگی کاربردی برای توسعهدهندگان، پشتیبانی از برچسبهای زمانی در سطح کلمه (Word-level timestamps) است. این قابلیت به سیستم اجازه میدهد هر کلمه تبدیلشده را به موقعیت دقیق آن در فایل صوتی متصل کند؛ نیازی که برای زیرنویسگذاری و ویرایش دقیق صوتی حیاتی است.
گام بعدی شما
- قابلیتهای مدل را در فضای دمو Hugging Face تست کنید.
- TII اعلام کرده است که اپلیکیشنهای بومی و دسترسی به API برای انتشار در آینده برنامهریزی شده است.
- تیم توسعه همچنین از حمایت تیم مدل Falcon-Emirati و Mikhail Lubinets برای پشتیبانی از زیرساختهای محاسباتی قدردانی کرده است.
- برای بهبود دقت در زبانهای دیگر، معماری Falcon3-Audio را در مقاله پژوهشی آن بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو