آیا یک مدل ۷ میلیارد پارامتری میتواند در دنیای پیچیدهٔ گویشهای عربی خلیج فارس، غولهای صنعت را شکست دهد؟ در ۶ اکتبر ۲۰۲۶، مؤسسه نوآوری فناوری (TII) با معرفی Falcon-Emirati-7B پاسخ مثبت داد؛ مدلی که نه برای ترجمهٔ ساده، بلکه برای تسلط بر ریتم، اصطلاحات و کدهای فرهنگی امارات طراحی شده است.
بیشتر مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بر پایهٔ عربی معیار (MSA) آموزش دیدهاند که زبان رسمی اخبار و کتابهاست. اما در زندگی روزمرهٔ امارات، طنز، مذاکره و قصهگویی با گویش اماراتی رخ میدهد؛ زبانی که یک گویش خلیجی با واژگان و ریتم خاص خود است. در این گویش، معنای واقعی اغلب در ضربالمثلها و شعر نباتی نهفته است؛ نشانگرهای فرهنگی که ترجمههای تحتاللفظی و کلمه-به-کلمه بهراحتی آنها را نادیده میگیرند. مدلی که فقط عربی معیار بداند، ممکن است تمام کلمات یک جمله اماراتی را ترجمه کند اما همچنان معنای واقعی و مقصود آن را نفهمد.
همانطور که در تحلیل قبلی ما دربارهٔ بهینهسازی هزینههای عملیاتی هوش مصنوعی با ابزارهایی مثل T-Zero V3 اشاره کردیم، چرخش به سمت مدلهای کوچکتر و تخصصی نشاندهندهٔ یک روند کلی است: بهرهوری از لایهٔ زیرساختی به لایهٔ زبانی منتقل شده است. بهجای استفاده از یک مدل عظیم برای همه، ما اکنون شاهد ظهور «متخصصان فرهنگی» هستیم.
معماری: بهرهوری ترکیبی
طبق مستندات TII، این مدل از ابتدا ساخته نشده، بلکه انطباق تخصصی از خانوادهٔ Falcon-H1-Arabic است؛ خانوادهای که در اوایل سال جاری استانداردهای جدیدی برای زبان عربی تعریف کرد. این معماری از یک ساختار ترکیبی استفاده میکند که مدلهای فضای حالت (Mamba) و مکانیزم توجه (Attention) را بهصورت موازی در هر بلوک اجرا کرده و خروجیهای آنها را پیش از هر تصویرسازی (Projection) ادغام میکند.
این طراحی به مدل اجازه میدهد تا بهرهوری خطی Mamba را در توالیهای طولانی حفظ کند و همزمان دقت مکانیزم توجه را برای وابستگیهای دوربرد به کار بگیرد. این موضوع برای زبان عربی که از نظر صرفی بسیار غنی است و در آن یک کلمه میتواند بار یک جمله کامل را به دوش بکشد، حیاتی است.
قابلیتهای مدل پایه
خانوادهٔ Falcon-H1-Arabic زیربنای محکمی برای کارهای گویشی فراهم کرده است:
- مقیاسپذیری: این خانواده در سه اندازه ۳، ۷ و ۳۴ میلیارد پارامتری عرضه شده است.
- پنجرههای متنی: پشتیبانی از پنجره متنی (Context Window) — میزان متنی که مدل همزمان «در ذهن» نگه میدارد — تا ۱۲۸ هزار و ۲۵۶ هزار توکن (Token).
- آموزش گسترده: مدلهای پایه روی ترکیبی از عربی معیار و گویشهای مختلف (از جمله خلیجی، شامی، مصری و مغربی) در کنار دادههای انگلیسی و دادههای چندزبانه آموزش دیدهاند.
چرا مقیاس ۷ میلیارد پارامتری؟
به گزارش TII، تیم توسعه بهطور خاص نسخه ۷ میلیاردی را برای این انطباق انتخاب کرد. آنها این مقیاس را «نقطه بهینه» برای تخصصیسازی گویشی دانستند. مدل ۳ میلیاردی فضای کافی برای درک عمیق فرهنگی و زبانی نداشت و مدل ۳۴ میلیاردی هزینههای آموزش و استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — را بهگونهای بالا میبرد که برای یک مدل چت تخصصی منطقی نبود. نسخه ۷ میلیاردی بهترین تعادل را میان کیفیت و هزینه استنتاج فراهم کرد.
چالشهای انطباق با گویش
تبدیل یک مدل عمومی عربی به یک متخصص اماراتی دشوارتر از آن است که به نظر برسد. TII سه مانع اصلی را شناسایی کرد:
- کمبود داده: گویش اماراتی عمدتاً گفتاری است. این گویش در نوشتههای آنلاین بسیار کمتر از عربی معیار یا حتی سایر گویشهای خلیجی و شامی ظاهر میشود و متون خام کمتری برای آموزش باقی میگذارد.
- معانی غیرتحتاللفظی: معنا اغلب به بستر فرهنگی مشترک، اصطلاحات خاص و اشارات شاعرانه وابسته است، نه لغتهای سطحی.
- فقدان دستورالعمل: هیچ دستورالعمل استانداردی برای مقدار دادههای گویشی مورد نیاز یا موثرترین مرحلهٔ آموزش — اعم از پیشآموزش مستمر، تنظیم نظارتشده (SFT) یا بهینهسازی ترجیحات — برای یادگیری یک گویش وجود نداشت.
به همین دلیل، توسعهٔ Falcon-Emirati-7B به شدت بر پایهٔ آزمون و خطا پیش رفت. تیم توسعه ترکیبات مختلف داده، مراحل آموزش و استراتژیهای نظارتی را آزمایش کرد و از قضاوت انسانی و نمرات محکها برای تعیین موثرترین روش استفاده نمود.
خط لوله داده: فراتر از خزش وب
TII یک خط لوله داده اختصاصی برای اماراتی بر روی پیشآموزش Falcon-H1-Arabic ساخت که از سه منبع مکمل تغذیه میشد:
۱. دادههای وب اصیل اماراتی: تیم توسعه محتوا را از وبسایتها و تالارهای گفتگوی اماراتی که بهصورت بومی و طبیعی با گویش نوشته شده بودند، استخراج و سازماندهی کرد. این دادهها ترجمه یا تبدیلشده از عربی معیار نبودند و «داده مرجع» برای عبارات روزمره، اصطلاحات محاورهای و تعامل طبیعی بین اماراتی و عربی معیار در کاربردهای واقعی فراهم کردند.
۲. دادههای عربی معیار درباره فرهنگ و هویت: آنها متونی به زبان عربی معیار را که بهطور خاص درباره میراث امارات، آداب و رسوم محلی، ارزشها، تاریخ و هنجارهای اجتماعی بود، ادغام کردند. این بخش شامل ارجاعاتی به نحوه نگرش و کلیشههای مربوط به اماراتیها بود. اگرچه این دادهها به مدل یاد ندادند که با گویش بنویسد، اما بستر فرهنگی را که یک بومی بهطور غریزی میداند (مانند آداب معاشرت و میراث) به مدل آموخت تا هنگام بحث درباره موضوعات اماراتی، بداند درباره چه چیزی صحبت میکند.
۳. دادههای مصنوعی کنترلشده: برای پوشش موضوعات چت روزمره که متون اصیل نمیتوانستند بهطور کامل پر کنند، TII دادههای مصنوعی تولید کرد. برای جلوگیری از ایجاد لحنی «شبهخلیجی» یا تقریبی، آنها اجازه ندادند مدل تولیدکننده بهصورت بداهه عمل کند. در عوض، از واژهنامههای سختگیرانه، لغتنامهها و قوانین سبکشناختی مخصوص واژگان و دستور زبان اماراتی استفاده کردند. این نردههای حفاظتی تضمین کرد که خروجیها واقعاً اماراتی به نظر برسند، نه اینکه صرفاً از نظر دستوری درست باشند.
یافتن دستورالعمل انطباق
از آنجا که دستورالعمل استانداردی برای تبدیل عربی معیار به گویش وجود نداشت، TII استراتژی آموزش را به عنوان یک آزمایش پیش برد. آنها تحلیلهای حذف (Ablations) را برای تعیین موارد زیر اجرا کردند:
- چه مقدار داده گویشی و در کدام مرحله از آموزش تزریق شود.
- چگونه تعادلی میان دادههای استخراجشده واقعی و دادههای مصنوعی ایجاد کنند تا مدل دچار بیشبرازش (Overfitting) به الگوهای مصنوعی نشود.
- چه مقدار بستر فرهنگی عربی معیار لازم است تا مدل بهجای تسلط سطحی، از نظر فرهنگی ریشهدار باشد.
در هر مرحله، آنها نمرات خودکار را با بررسی گویشوران بومی ترکیب کردند، زیرا معیارهای خودکار نمیتوانند طبیعی بودن، لحن یا تناسب فرهنگی را بهدرستی بسنجند.
محک Alyah: ستاره قطبی
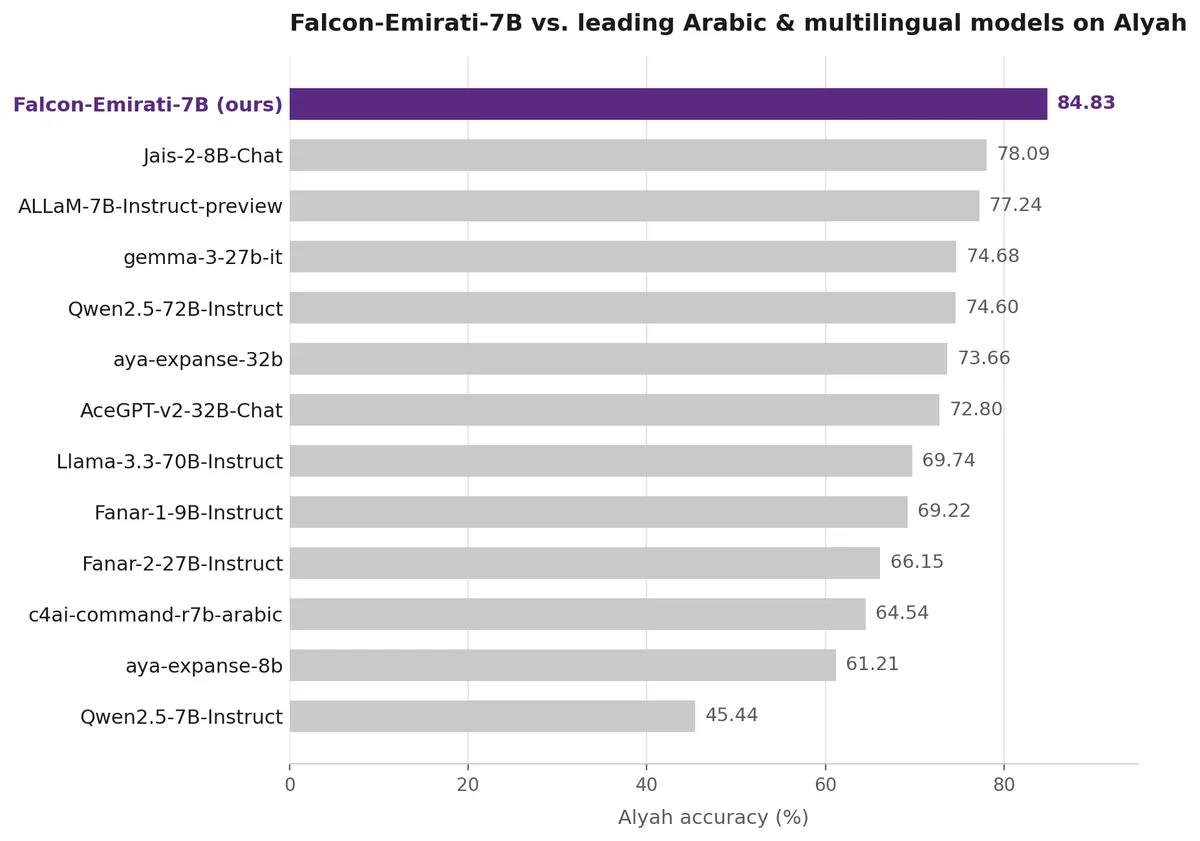
برای سنجش موفقیت، TII از Alyah (به معنای ستاره قطبی) استفاده کرد؛ یک محک بومی چندگزینهای شامل ۱۱۷۳ نمونه که بهصورت دستی از گویشوران بومی اماراتی جمعآوری شده است. Alyah دستههای مختلفی از سلام و احوالپرسی و آداب معاشرت روزمره تا زبان استعاری، دانش میراث فرهنگی و شعر اماراتی را پوشش میدهد.
Falcon-Emirati-7B در این آزمون به امتیاز ۸۴.۸۳٪ رسید و مدلهایی را که چندین برابر بزرگتر بودند، شکست داد. این نتیجه ثابت میکند که تسلط بر گویش، اثر جانبی افزایش پارامترها نیست، بلکه نیازمند آموزش هدفمند و آگاهانه است. تحلیلهای TII نشان داد در حالی که پوشش کلی زبان عربی یک نقطه شروع ضروری است، اما سختترین بخشهای Alyah — مانند شعر و میراث — نیازمند کار تخصصی روی گویش هستند.
شکاف وفاداری: صحت در برابر لحن
TII برای ارزیابی تولیدات باز، از Gemini 3.7 Flash به عنوان «مدل زبانی بهمثابه داور» استفاده کرد تا دو بعد متمایز را بسنجد: اول اینکه آیا محتوا از نظر واقعی درست است و دوم اینکه آیا پاسخ واقعاً با گویش اماراتی بازگردانده شده یا مدل به حالت پیشفرض عربی معیار بازگشته است.
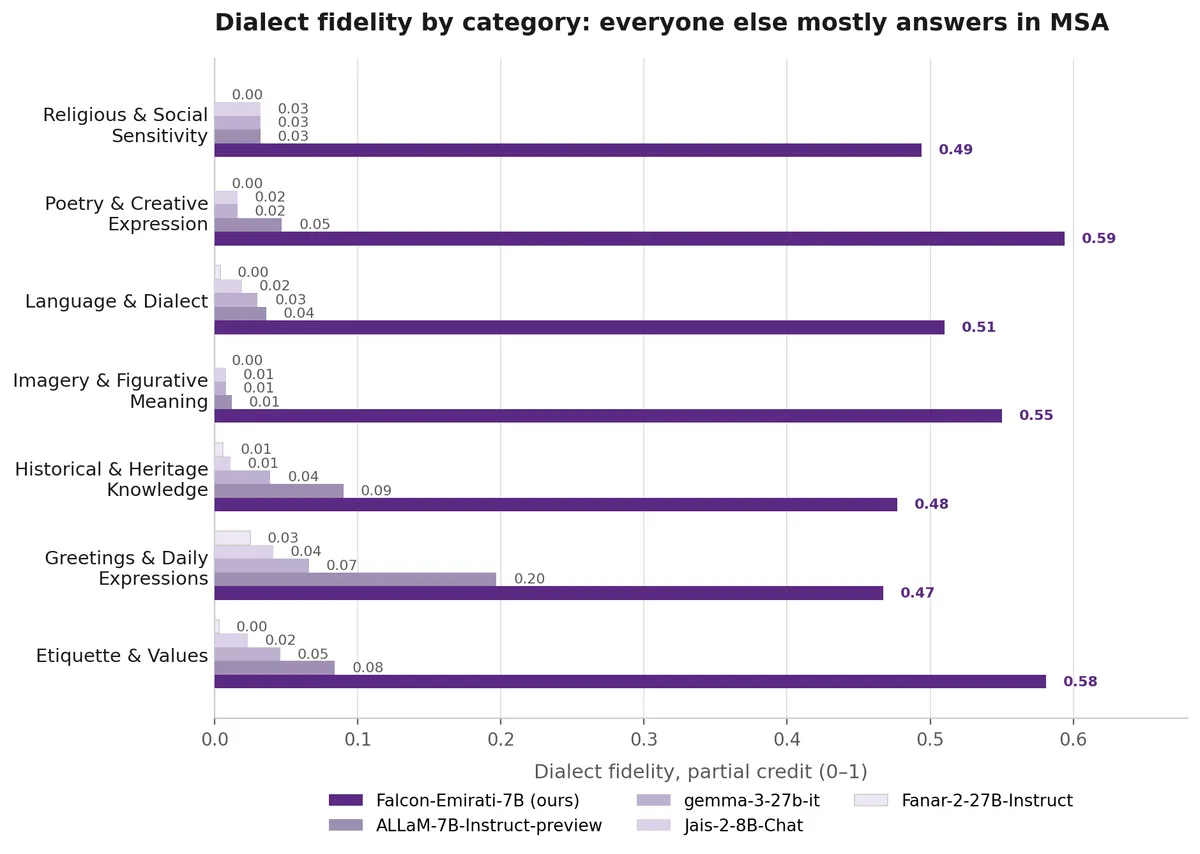
آنها Falcon-Emirati-7B را در برابر ALLaM-7B-Instruct-preview، gemma-3-27b-it، Jais-2-8B-Chat و Fanar-2-27B-Instruct مقایسه کردند. در حالی که مدلهای رقیب اغلب پاسخهای صحیح واقعی میدادند، اما تقریباً همیشه با عربی معیار پاسخ میدادند.
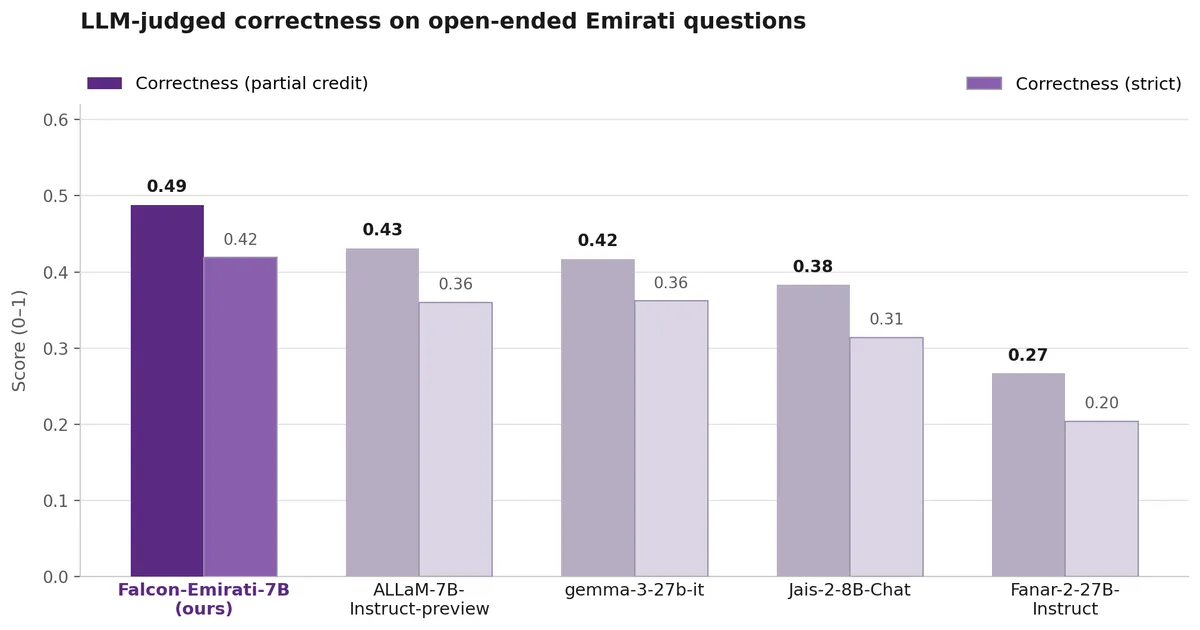
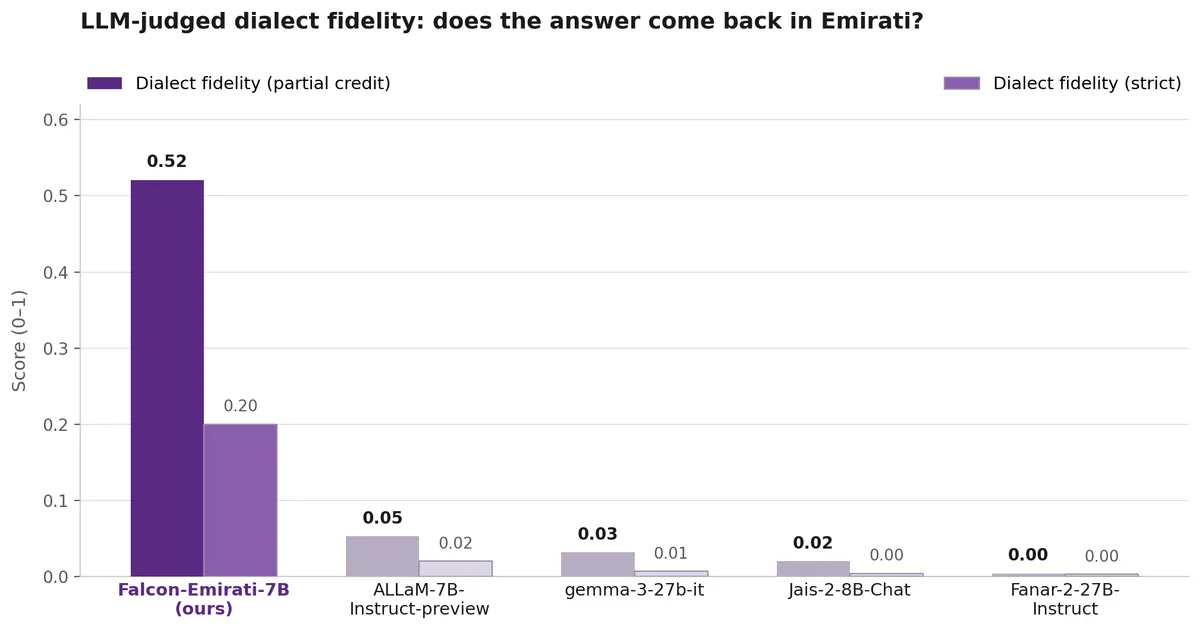
از نظر وفاداری به گویش، Falcon-Emirati-7B امتیاز ۰.۵۲ (امتیاز جزئی) را کسب کرد، در حالی که نزدیکترین رقبای آن امتیازی بین ۰.۰۵ (ALLaM) و ۰.۰۲ (Jais) داشتند و Fanar عملاً روی ۰.۰۰ بود. این یک تفاوت در مقیاس تقریباً دو مرتبه بزرگی است. در عمل، Falcon-Emirati-7B تنها مدل از بین این پنج مدل است که بهطور قابلاعتماد با همان گویشی که از او پرسیده شده بود، پاسخ میدهد.
رویاروییهای مستقیم
در مقایسههای جفتبهجفت، داور پاسخهای Falcon-Emirati-7B و یک رقیب را بهصورت ناشناس مشاهده کرد. Falcon-Emirati-7B در دستههای نیازمند تسلط فرهنگی عمیق غالب بود:
- در برابر Fanar-2-27B-Instruct: مدل Falcon در تمام دستهها پیروز شد و در بخش شعر و بیان خلاق به نرخ برد ۸۸٪ و در حساسیتهای مذهبی و اجتماعی به ۸۰٪ رسید. مدل Fanar همچنین در ۲۶.۲٪ موارد از پاسخ دادن اجتناب کرد، در حالی که این رقم برای سایر مدلها زیر ۵٪ بود. با ترکیب این موضوع و نمره صحت ۰.۲۷، مشخص میشود که Fanar هم تمایل کمتری دارد و هم توانایی کمتری در تعامل با محتوای اماراتی دارد.
- در برابر Jais-2-8B-Chat: بیشترین شکافها در بخش شعر و بیان خلاق (۰.۶۹ در برابر ۰.۳۱) و زبان و گویش (۰.۶۲ در برابر ۰.۳۸) مشاهده شد.
- در برابر ALLaM-7B-Instruct-preview: حاشیه پیروزی مشابهی در بخش شعر (۰.۶۶ در برابر ۰.۳۴) و زبان و گویش (۰.۵۸ در برابر ۰.۴۲) دیده شد.
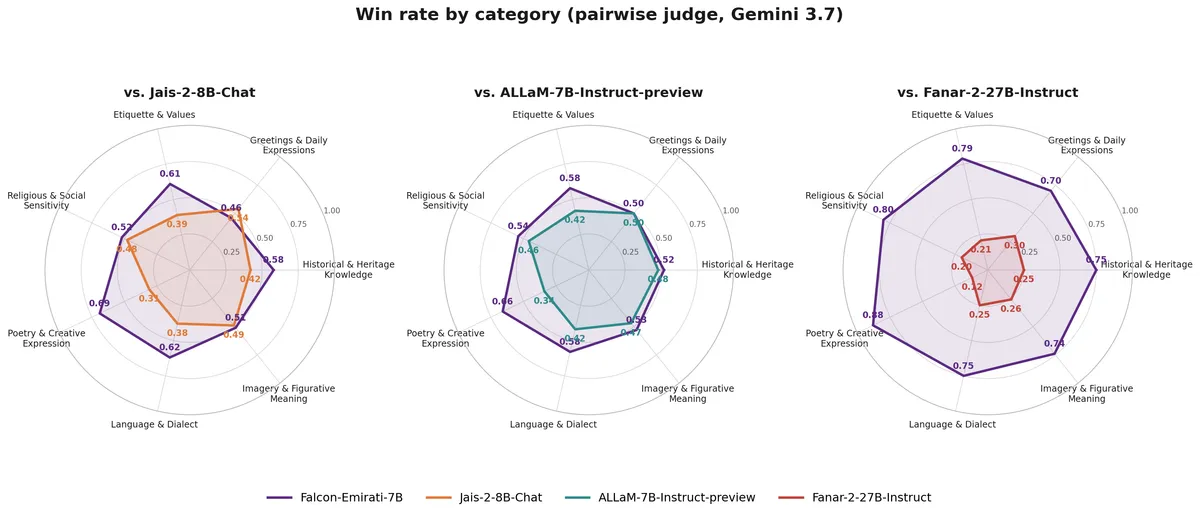
جالب است که تنها جایی که رقباء توانستند مقاومت کنند، بخش «سلام و احوالپرسی و عبارات روزمره» بود. Falcon-Emirati-7B در این بخش با اختلاف اندکی به Jais-2-8B-Chat باخت (۰.۴۶ در برابر ۰.۵۴) و با ALLaM برابر شد (۰.۵۰). دلیل این امر آن است که سلام و احوالپرسیهای پایه بین عربی معیار و اماراتی شباهت زیادی دارند و تنها جایی هستند که یک مدل عمومی میتواند «بهطور تصادفی» بومی به نظر برسد. اما هر جا که گویش متمایزتر میشود — مانند شعر، زبان استعاری و دانش میراث — برتری Falcon-Emirati-7B بهوضوح حفظ میشود.
هوش فرهنگی
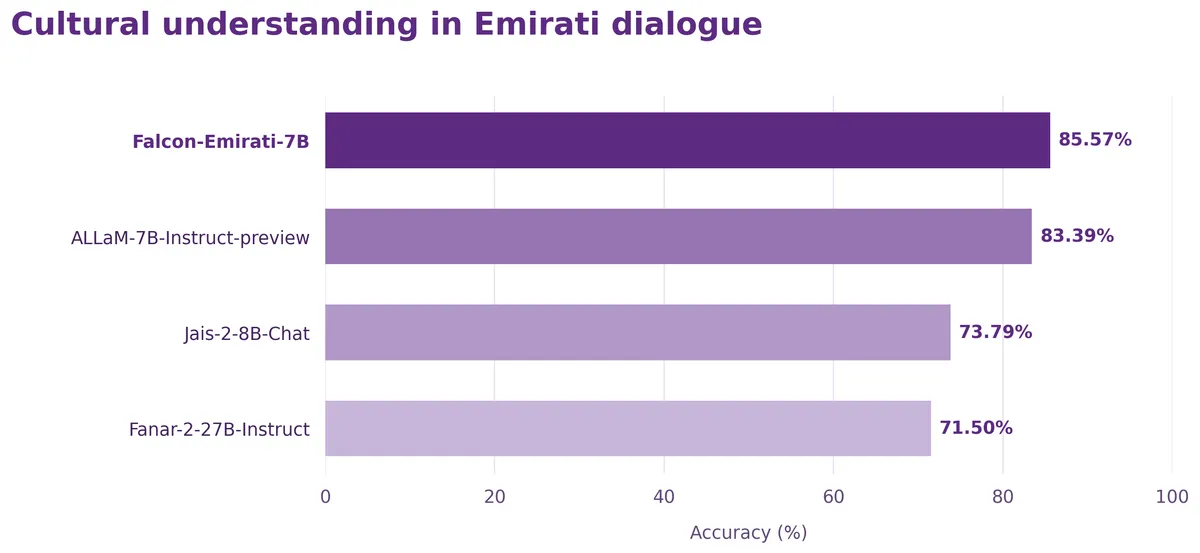
زبان نمایندهای از فرهنگ است. TII مدل را روی بخش اماراتی محک ArabCulture-Dialogue آزمایش کرد که معیاری برای پاسخهای متناسب با فرهنگ است. آنها چهار مدل را در ۲۸۳ سناریوی اماراتی، هم به زبان عربی اماراتی و هم عربی معیار، با تغییر میزان اطلاعات مکانی ارائه شده، آزمایش کردند.
Falcon-Emirati-7B به دقت ۸۵.۵۷٪ رسید و از ALLaM-7B (۸۳.۳۹٪)، Jais-2-8B (۷۳.۷۹٪) و Fanar-2-27B (۷۱.۵۰٪) پیشی گرفت. این نشان میدهد که مدل آداب اجتماعی و ارزشهای ذاتی منطقه را درک میکند، نه فقط واژگان را.
تحلیل: مرگ مدلهای «یکسایز برای همه»
این عرضه نشاندهنده تغییری در رویکرد به هوش مصنوعی چندزبانه است. سالها تصور میشد افزودن داده و پارامتر بیشتر به یک مدل جهانی، تفاوتهای منطقهای را حل میکند. Falcon-Emirati-7B عکس این موضوع را ثابت کرد: مقیاس نمیتواند جایگزین مبانی فرهنگی شود. حتی بزرگترین مدلهای چندزبانه در محک Alyah نمرات بسیار پایینتری نسبت به مدلهای کوچکتر و آگاه به گویش کسب کردند.
برای توسعهدهندگان و کسبوکارها در خلیج فارس، این یعنی «بهترین» مدل دیگر بزرگترین مدل نیست، بلکه مدلی است که دقیقترین همراستاسازی دادهای را دارد. توانایی تغییر لحن — از عربی رسمی (MSA) به اماراتی محاورهای — تفاوت بین ابزاری است که شبیه یک مترجم است و ابزاری که شبیه یک بومی رفتار میکند.
گام بعدی شما
- برای تجربه تفاوتهای فرهنگی و لحن بومی، مدل را در پلتفرم Falcon Chat تست کنید: https://chat.falconllm.tii.ae/?model=Falcon-Emirati-7B
- TII اشاره میکند که گویش و ظرافتهای فرهنگی ذهنی هستند و آنها جامعه اماراتی را تشویق میکنند تا برای بهبود مدل و محک Alyah بازخورد ارسال کنند.
- اگر روی مدلهای منطقهای کار میکنید، استراتژی TII در ترکیب دادههای مصنوعی کنترلشده با دادههای وب اصیل را بررسی کنید.
- منتظر بهروزرسانیهای محک Alyah باشید تا استانداردهای جدید سنجش گویشی را دنبال کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو