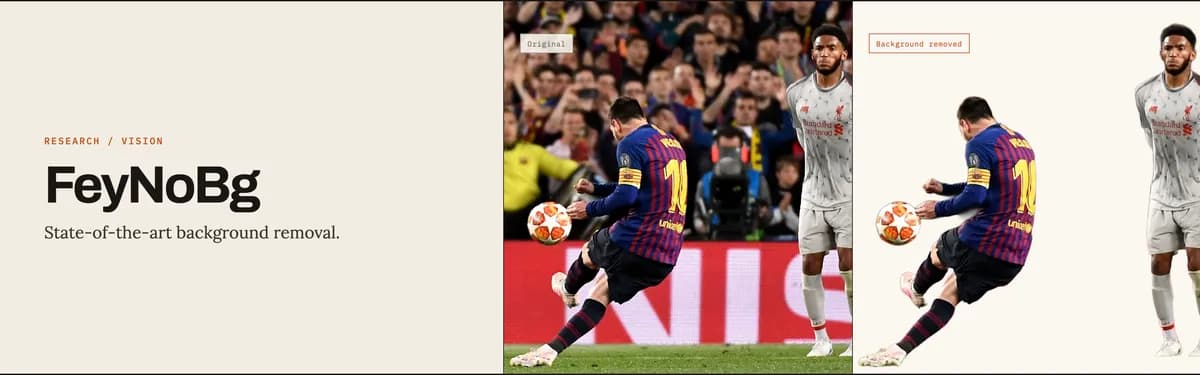
تصور کنید میخواهید پسزمینه تصویری با کیفیت 8K را حذف کنید، اما مدل شما موهای ظریف یا لبههای پیچیده را با پسزمینه یکی میکند. FeyNoBg دقیقاً برای حل همین مشکل آمده است تا مرز بین سوژه و محیط را با دقتی جراحیگونه تفکیک کند.
به نقل از مستندات فنی این پروژه، FeyNoBg در محک UHRSD-T به امتیاز S-measure ۰.۹۸۱ دست یافت و پیشتاز قبلی یعنی BiRefNet با امتیاز ۰.۹۵۷ را شکست داد. این نتیجه نشاندهنده جهشی واقعی در پردازش صحنههای با رزولوشن بسیار بالا (4K و 8K) است. بر اساس گزارشهای منتشرشده، این مدل در ۸ محک مختلف مورد آزمایش قرار گرفت؛ FeyNoBg در ۴ مورد از این محکها رتبه اول را کسب کرد و در سایر موارد، فاصله آن با رده اول کمتر از ۲٪ بود.

زمینه: چالش دوگانه حذف پسزمینه
برای درک این دستاورد، باید بدانیم حذف پسزمینه یک چالش دوگانه است. در دنیای دیجیتال، تصاویر به صورت شبکهای از پیکسلها ذخیره میشوند. هدف یک الگوریتم حذف پسزمینه این است که برای هر پیکسل، یک مقدار «شفافیت» (Opacity) پیشبینی کند. در این فرآیند، پیکسلهای پسزمینه باید کاملاً شفاف، پیکسلهای پیشزمینه باید مات (کدر) و پیکسلهای مرزی باید نیمهشفاف شوند.
تولید این نقشه شفافیت نیازمند دو مهارت مجزا است. اول، مدل باید بتواند پیشزمینه را از پسزمینه جدا کند. در پسزمینههای ساده، این کار با مقایسه رنگها انجام میشود. اما در تصاویری با کنتراست پایین، صحنههای شلوغ یا سوژههای استتارشده، مدل باید از شکل، بافت و بافتار (Context) برای شناسایی سوژه استفاده کند.
مهارت دوم، ترسیم دقیق مرزهای پیشزمینه است. در حالی که تغییرات شدید رنگ در تصاویر ساده سیگنالهای لبه قوی ایجاد میکنند، اما مرزهای واقعی بسیار دشوار هستند. مو، خز، سیمهای نازک و تاری ناشی از حرکت (Motion Blur) اغلب عناصر پیشزمینه و پسزمینه را با هم ترکیب میکنند. مدل باید اندازهگیری کند که چه مقدار از یک پیکسل لبه متعلق به سوژه است و شفافیت آن را بر همین اساس تنظیم کند. این فرآیند تخصصی، «ماتینگ تصویر» (Image Matting) نامیده میشود.
به طور کلی، این دو مهارت معمولاً با انواع مختلفی از دادههای متمرکز آموزش داده میشوند. این امر منجر به ایجاد یک نقطه شکست میشود؛ زیرا یک ترکیب آموزشی ضعیف میتواند مدلهایی نامتوازن ایجاد کند که در آنها بهبود در یک مهارت به قیمت ضعف در مهارت دیگر تمام شود. این اتفاق منجر به خروجیهایی میشود که یا بخشهایی از سوژه را حذف میکنند و یا لبههای تمیز و دقیقی ندارند. دیدگاه کلیدی تیم Feyn برای FeyNoBg این بود که تصاویر واقعی نیازمند مهارت همزمان در هر دو زمینه شناسایی پیشزمینه و دقت مرزها هستند.
جزئیات فنی: مهندسی توسعه مدل
تیم Feyn مدل BiRefNet را به عنوان پایه برای FeyNoBg انتخاب کرد، زیرا معماری آن از پیش با اهداف پروژه مطابقت داشت. BiRefNet مسئولیتها را بین دو بخش تقسیم میکند: یک ماژول مکانیابی (Localization) برای یافتن پیشزمینه و یک ماژول بازسازی (Reconstruction) برای ترسیم دقیق مرز.
مکانیسم استخراج ویژگی
فرآیند استخراج ویژگی در چهار مرحله انجام میشود:
- در مراحل ابتدایی، جزئیات محلی تصویر استخراج میشوند.
- در مراحل بعدی، این جزئیات با هم ترکیب شده و نماهای گستردهتری از تصویر ایجاد میکنند که به آنها «نقشههای ویژگی» (Feature Maps) میگویند.
- هر دو ماژول مکانیابی و بازسازی به شدت به نقشهای که در مرحله سوم تولید میشود وابسته هستند.
- مرحله سوم دشوارترین بخش است، زیرا مدل باید در حالی که جزئیات مکانی لازم برای نمایش شکل را حفظ میکند، درباره کل سوژه نیز استدلال کند.
رشد پارامترهای مدل
برای افزایش ظرفیت مدل و بهبود حفظ اطلاعات، Feyn تعداد بلوکهای مرحله سوم استخراجکننده ویژگی را از ۱۸ به ۲۴ بلوک افزایش داد. این تغییر باعث شد تعداد پارامترهای مدل (که میتوان آنها را مانند پیچهای تنظیم یک دستگاه پیچیده دانست) به صورت ملایم از ۲۲۲ میلیون به ۲۶۳ میلیون برسد.
- مدل BiRefNet (اصلی): ۲۲۲ میلیون پارامتر؛ عمق [۲، ۲، ۱۸، ۲]
- مدل FeyNoBg (توسعهیافته): ۲۶۳ میلیون پارامتر؛ عمق [۲، ۲، ۲۴، ۲]
نکته حیاتی این است که تیم توسعه در طول این گسترش، تمام وزنهای پیشآموزشده سازگار را حفظ کرد. تنها ۶ بلوک جدید بدون آموزش شروع به کار کردند. این استراتژی به FeyNoBg اجازه داد تا بدون فراموش کردن دانش پایه BiRefNet، مهارتهای جدید را بیاموزد.
تنوع دادهها و استراتژی آموزش
آموزش ابتدا با MaskFactory شروع شد که مجموعهای از جفتهای تصویر و ماسک مصنوعی بود که برای بخشبندی دقیق پیشزمینه ایجاد شده بودند. این مرحله اولیه ثابت کرد که دادههای مصنوعی به تنهایی کافی نیستند؛ در حالی که مدل در محک CAMO بهبود یافت، اما در محک DIS5K دچار پسرفت (Regression) شد.
جمعآوری و پالایش مجموعهدادهها
سپس Feyn یک مجموعه آموزشی متنوع شامل ۲۶.۱ هزار تصویر از ۱۰ منبع مختلف جمعآوری کرد تا مدل را با حداکثری از سناریوها مواجه کند. این منابع شامل موارد زیر بود:
- صحنههای شلوغ و سوژههای استتارشده
- پرترههای با رزولوشن بالا و تصاویر سبک انیمه
- S3OD: صحنههای مصنوعی که بهطور خاص برای کمک به مدلها در تعمیم دادن فراتر از مجموعههای تصویری آشنا طراحی شدهاند
قبل از اجرای نهایی، تیم ترکیب دادهها را بازنگری کرد. آنها ۴۰۰۰ تصویر از S3OD اضافه کردند و تعداد تصاویر مجموعه انیمه را به ۵۰۰ تصویر کاهش دادند. همچنین برای حفظ مفیدترین و سازگارترین نمونهها، مجموعههای ThinObject-5K، HIM-2K و COIFT را بهطور کامل حذف کردند.
حل عدم توازن دادهها
ترکیب این مجموعههای مختلف دو مشکل اصلی ایجاد کرد:
۱. تفاوت در اندازه: برای جلوگیری از تسلط منابع بزرگ بر آموزش و ایجاد خطای تخصصی (Specialization Errors)، تیم سقف هر منبع را به ۴۰۰۰ تصویر محدود کرد و سپس آنها را بُرزید (Shuffle). پس از آن، مدل برای ۷۰۰۰ گام (Steps) آموزش دید.
۲. تفاوت در برچسبگذاری: مجموعههای بخشبندی (Segmentation) ماسکهای پیشزمینه ارائه میدادند، در حالی که مجموعههای ماتینگ (Matting) «آلفا ماتها» را ارائه میکردند. Feyn هر دو را به ماسکهای باینری پیشزمینه تبدیل کرد تا هر تصویر هدف آموزشی یکسانی داشته باشد. این یعنی مجموعههای ماتینگ بهجای نظارت بر شفافیت نرم، در قالب سوژههایی با خطوط دقیق کمک کردند.
نتایج محکها
برای اندازهگیری عملکرد، Feyn از معیار S-measure استفاده کرد که امتیازی بین ۰ تا ۱ دارد. این معیار، پیشزمینه پیشبینیشده را با ماسک صحیح مقایسه میکند و هم به کامل بودن سوژه و هم به دقت شکل آن پاداش میدهد.
مدل FeyNoBg در ۸ محک مورد آزمایش قرار گرفت: UHRSD-T، HRSOD-T، DIS5K، DAVIS-S، DUTS-T، ECOD10K-T، DUT-OMRON و CAMO-T. FeyNoBg در چهار مورد از اینها پیشتاز بود و در سایرین در فاصله ۲٪ از رتبه اول باقی ماند. قابل ذکر است که ترکیب گستردهتر دادههای آموزشی باعث شد پسرفت قبلی در DIS5K به نتیجهای تبدیل شود که رتبه اول این محک را به دست آورد.
کتابخانه NoBg
در کنار مدل، Feyn کتابخانه متنباز NoBg را منتشر کرد. مدلهای ماتینگ تصویر معمولاً به صورت مخازن (Repositories) ایزوله منتشر میشوند که مقایسه مدلها یا تنظیم دقیق (Fine-tuning) آنها را دشوار میکند، زیرا کاربر باید پیش از شروع آزمایشها، چندین آداپتور بنویسد.
کتابخانه NoBg با ارائه یک رابط (Interface) یکپارسه برای اجرا و آموزش مدلهای حذف پسزمینه، این مشکل را حل کرده است. این کتابخانه با Hugging Face Trainer ادغام شده که حلقه آموزش، ذخیرهسازی نقاط بازگشت (Checkpointing) و ارزیابی را مدیریت میکند. در تستهای داخلی، پیادهسازی BiRefNet در NoBg در مقایسه با پیادهسازی اصلی در اندازههای دستهای (Batch sizes) ۱، ۲ و ۴، توان عملیاتی بیشتر، تأخیر کمتر و مصرف حافظه پیک GPU پایینتری را نشان داد. برای دستیابی به چنین بهینهسازیهایی در سطح سختافزار، تکنیکهای پیشرفتهای مانند استفاده از کرنلهای Triton برای افزایش سرعت استنتاج مدلها به طور گسترده در پروژههای مشابه به کار گرفته میشوند.
پیادهسازی و گردش کار
توسعهدهندگان میتوانند FeyNoBg را از طریق Hugging Face مستقر کنند یا مدلهای سفارشی خود را با استفاده از مخزن گیتهاب بسازند. این کتابخانه موارد زیر را بهطور خودکار مدیریت میکند:
- تغییر اندازه و نرمالسازی تصویر قبل از استنتاج (Inference).
- تبدیل خروجی مدل به یک آلفا مات در اندازه اصلی.
- ذخیره برش نهایی به صورت یک فایل PNG شفاف.
برای کسانی که این مدل را در یک خط لوله (Pipeline) پیاده میکنند، ادغام بسیار ساده است. با استفاده از کلاسهای AutoModel و AutoProcessor کاربر میتواند مدل را از مسیر "feyninc/FeyNobg" بارگذاری کرده، یک فایل JPG خام را پردازش کند و خروجی را با دستور processor.cutout(image, alpha).save("output.png") ذخیره نماید.
این حرکت به سمت یک کتابخانه unified نشان میدهد که حوزه ماتینگ تصویر از مقالات پژوهشی پراکنده به سمت یک اکوسیستم آماده برای تولید (Production-ready) در حال حرکت است. Feyn با متنباز کردن هم مدل و هم چارچوب آموزشی، موانع را برای سایر توسعهدهندگان جهت بهبود بخشبندی با رزولوشن بالا کاهش داده است.
گام بعدی شما
- اگر در پروژههای خود از حذف پسزمینه استفاده میکنید، مدل FeyNoBg را در Hugging Face تست کنید تا تفاوت دقت در لبههای ظریف را ببینید.
- برای بهینهسازی مصرف حافظه GPU در خط لولههای پردازش تصویر، کتابخانه NoBg را جایگزین پیادهسازیهای قدیمی BiRefNet کنید.
- بررسی کنید آیا دادههای آموزشی شما برای مدلهای بخشبندی تصویر، تعادل لازم بین دادههای مصنوعی و واقعی را دارند.



گفتگو