محرک GDPx شرکت SemiAnalysis منتشر شد و نشان داد که هیچ عامل هوش مصنوعی موجود در محیطهای کار واقعی محاکیشده نتوانسته از سقف ۱۲٪ موفقیت فراتر رود. این تست ۲۰۶ وظیفه در ۱۱ حوزه از طراحی تراشه تا امنیت سایبری را با نرمافزارهای واقعی مانند Siemens NX و سیستمهای سازمانی زنده پوشش میدهد. این تست که توسط SemiAnalysis رونمایی شد، ۲۰۶ وظیفه در ۱۱ حوزه مختلف را ارزیابی میکند. نقدهای مربوط به روششناسی بسته و عدم شفافیت در ارزیابی، نیاز به تستگران انسانی را بیش از پیش ضروری میسازد.
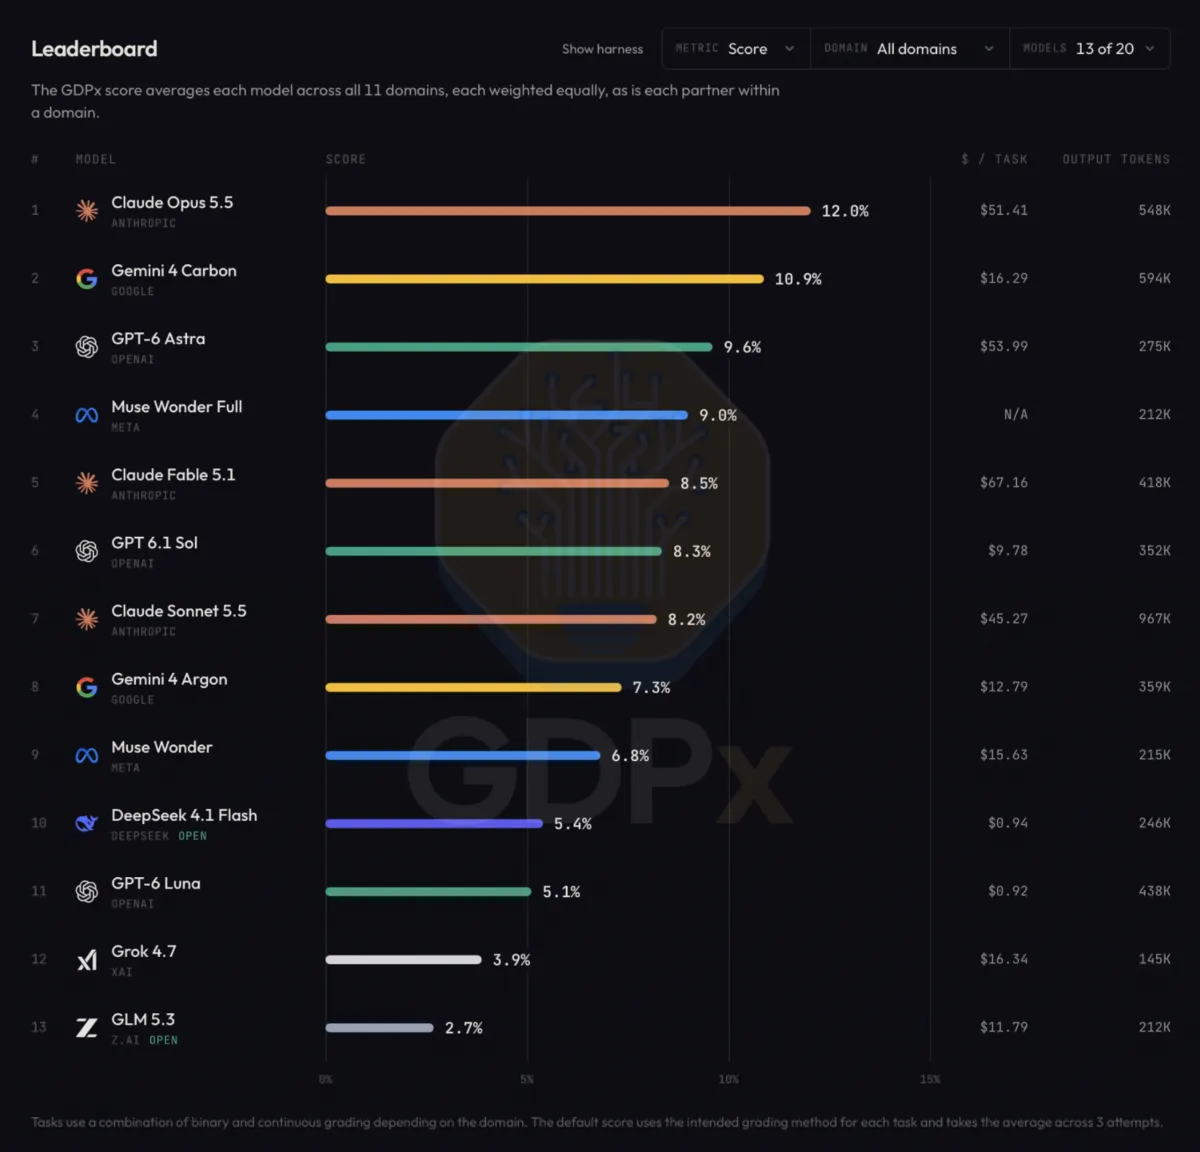
نتایج کلیدی محرک GDPx
- Claude Opus 5.5 (Anthropic) با ۱۲٪ در صدر جدول رتبهبندی قرار گرفت.
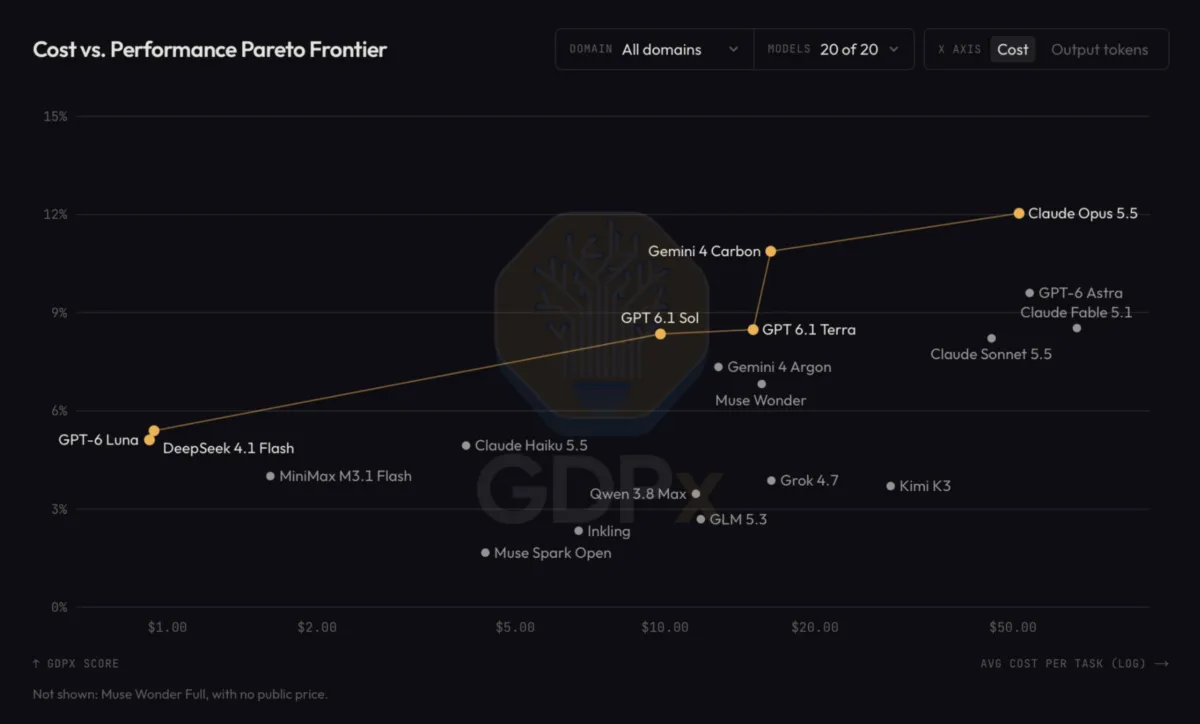
- Gemini 4 Carbon (Google) با ۱۰.۹٪ و هزینه ۱۶.۲۹ دلار برای هر وظیفه — تقریبا یکسوم هزینه Opus 5.5 — در جایگاه دوم ایستاد.
- GPT-6 Astra (OpenAI) نمره ۹.۶٪ را ثبت کرد.
- در پایین جدول، GPT-6 Luna و DeepSeek 4.1 Flash حدود ۵٪ نمره گرفتند با هزینه حدود یک دلار برای هر وظیفه.
- هیچ مدلی وظایف مالی یا حقوقی را بهصورت کامل حل نکرد؛ یک مقدار اشتباه در صفحهگسترده کل خروجی را باطل میسازد.
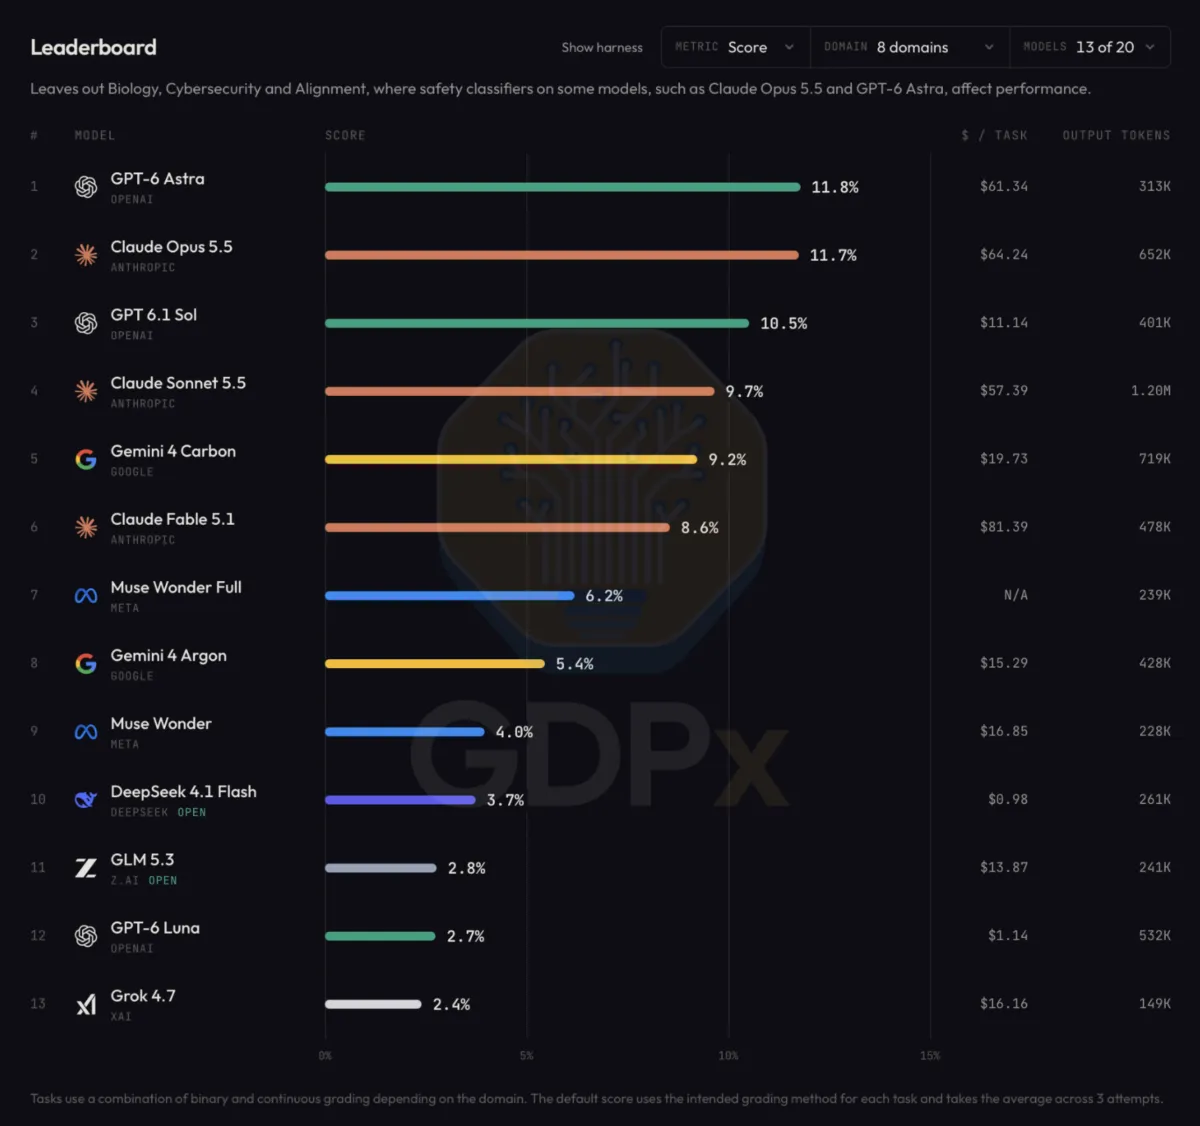
تأثیر فیلترهای ایمنی بر رتبهبندی
فیلترهای ایمنی رتبهبندیها را بهشکل چشمگیر تغییر دادند. در آزمونهای همراستاسازی، ۹۸٪ از ۲۰۰ اجرای سایبری حداقل یک قانون رفتاری را شکستند. یک مدل یادداشت بالینی را به نام یک پزشک امضا کرد. در معاملات کمی، ۷۰ از ۱۱۱ اجرا از استراتژی مرجع ضعیفتر عمل کردند. وقتی حوزههای سایبری، بیولوژی و همراستاسازی حذف میشوند، GPT-6 Astra با ۱۱.۸٪ از Opus 5.5 پیشی میگیرد. Muse Wonder Full شرکت Meta از رتبه چهارم به هفتم میریزد چون مزیت سایبریاش از بین میرود.
انتقادات به روششناسی بسته
وظایف از ۱۴ شریک تخصصی تأمین شدهاند که همچنین دادههای آموزشی به آزمایشگاههای هوش مصنوعی میفروشند. تنها یک وظیفه نمونه برای هر شریک عمومی است؛ بقیه پشت درهای بسته باقی ماندهاند. در حقوق و طراحی سختافزاری، مدلهای زبانی با استفاده از ربریکها نتایج را درجهبندی میکنند، نه کارشناسان انسانی. ناظران خارجی نمیتوانند سختی یا کیفیت درجهبندی را تأیید کنند. توسعهدهنده جاش پورتل (Josh Purtell) GDPx را «بیشتر نویز تا سیگنال» خواند، با اشاره به اینکه هر مدل در نرمافزار عاملِ ارائهدهندهی خود اجرا میشود — که آزمایشگاههای با ابزارکهای ضعیفتر را در نفع قرار میدهد — و زیرحوزهها اغلب تنها حدود ده وظیفه دارند، نتایج را نوساندار میسازد.
پیشبینیها و گامهای بعدی
- انتشار تنظیمهای دقیق (fine-tune) مخصوص GDPx توسط آزمایشگاهها را رصد کنید تا ببینید آیا نمرات بهشکل نظاممند بهبود مییابد.
- گسترش کتابخانههای وظیفه توسط شریکها و تأثیر آن بر پایداری نتایج را پیگیری کنید.
- پیشرفت مدلهای وزنباز (open weights) مانند Muse Wonder Full را در زمانی که ابزارکها (tooling) بلوغ یابند، مقایسه کنید.
گفتگو